Quan điểm
Giải mã 'ngưỡng sát thương' của mô hình AI: Hiệu suất đang định hình lại cuộc chơi như thế nào?
(giờ Việt Nam)
Tóm tắt AI
Bài viết phân tích sự chuyển dịch của cuộc đua AI năm 2026 từ trí thông minh thuần túy sang cân bằng giữa hiệu năng và chi phí. Tác giả đánh giá dòng MiMo-V2.6 vừa ra mắt với bước nhảy vọt về thông minh gấp đôi so với thế hệ trước.
Chính văn · Bản dịch AI
Ngưỡng "chém giết" của các mô hình lớn (Large Model) lại một lần nữa bị Xiaomi MiMo-V2.6 phá vỡ
👦🏻 Tác giả: GaKi
🥷 Biên tập: Koji
🧑🎨 Dàn trang: NCon
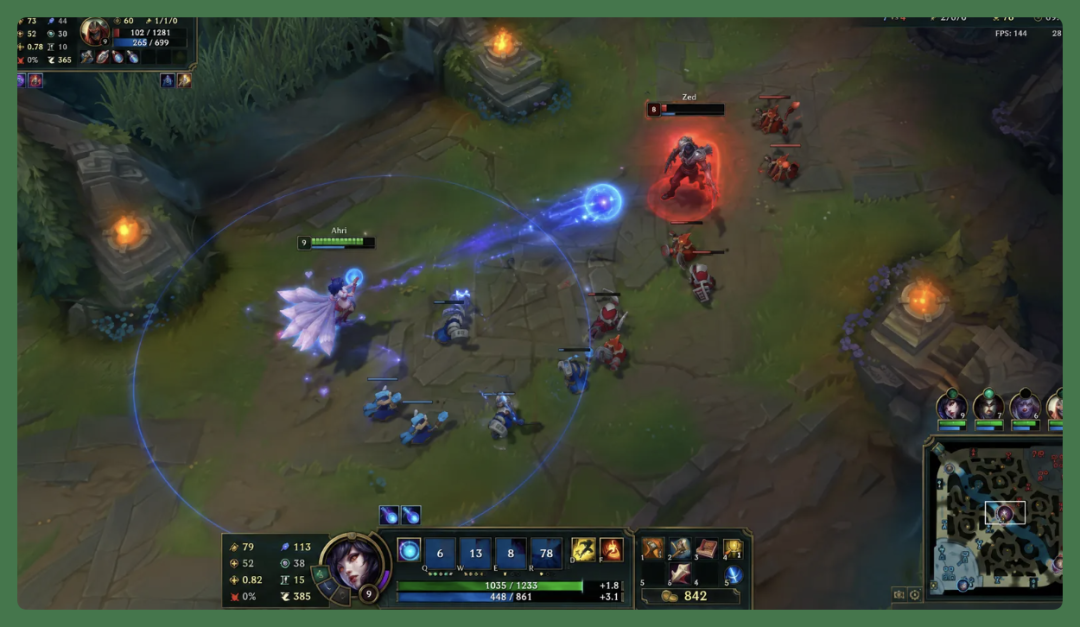
Các mô hình lớn đã có "ngưỡng chém giết".
Tại sao thuật ngữ này lại trở nên phổ biến? — Nó bắt nguồn từ trò chơi Liên Minh Huyền Thoại (LOL), có nghĩa là: khi lượng máu thấp hơn một ngưỡng nhất định, đối thủ sẽ bị kết liễu ngay lập tức.
AI tạo sinh
Đặt trong bối cảnh các mô hình lớn, dù có chút hài hước nhưng ý nghĩa cũng tương tự:
Khi một mô hình bị mô hình khác vượt mặt ở cả hai khía cạnh "trí tuệ" và "chi phí", nó sẽ không còn lý do gì để được lựa chọn và bị "chém giết" tại chỗ. Trong nửa năm qua, khái niệm "ngưỡng chém giết" này đã được nhắc đến liên tục với tần suất ngày càng cao. Bởi vì ngày càng có nhiều mô hình đứng trên ngưỡng này, và ngày càng có nhiều mô hình bị đẩy lùi xuống dưới ngưỡng.
Tháng 2 năm nay, thị phần gọi API các mô hình Trung Quốc trên OpenRouter đã vượt qua các mô hình Mỹ; đồng thời, các nhà cung cấp hàng đầu ở nước ngoài như OpenAI, Google, Anthropic bắt đầu tung ra các dòng sản phẩm giá rẻ và liên tục giảm giá.
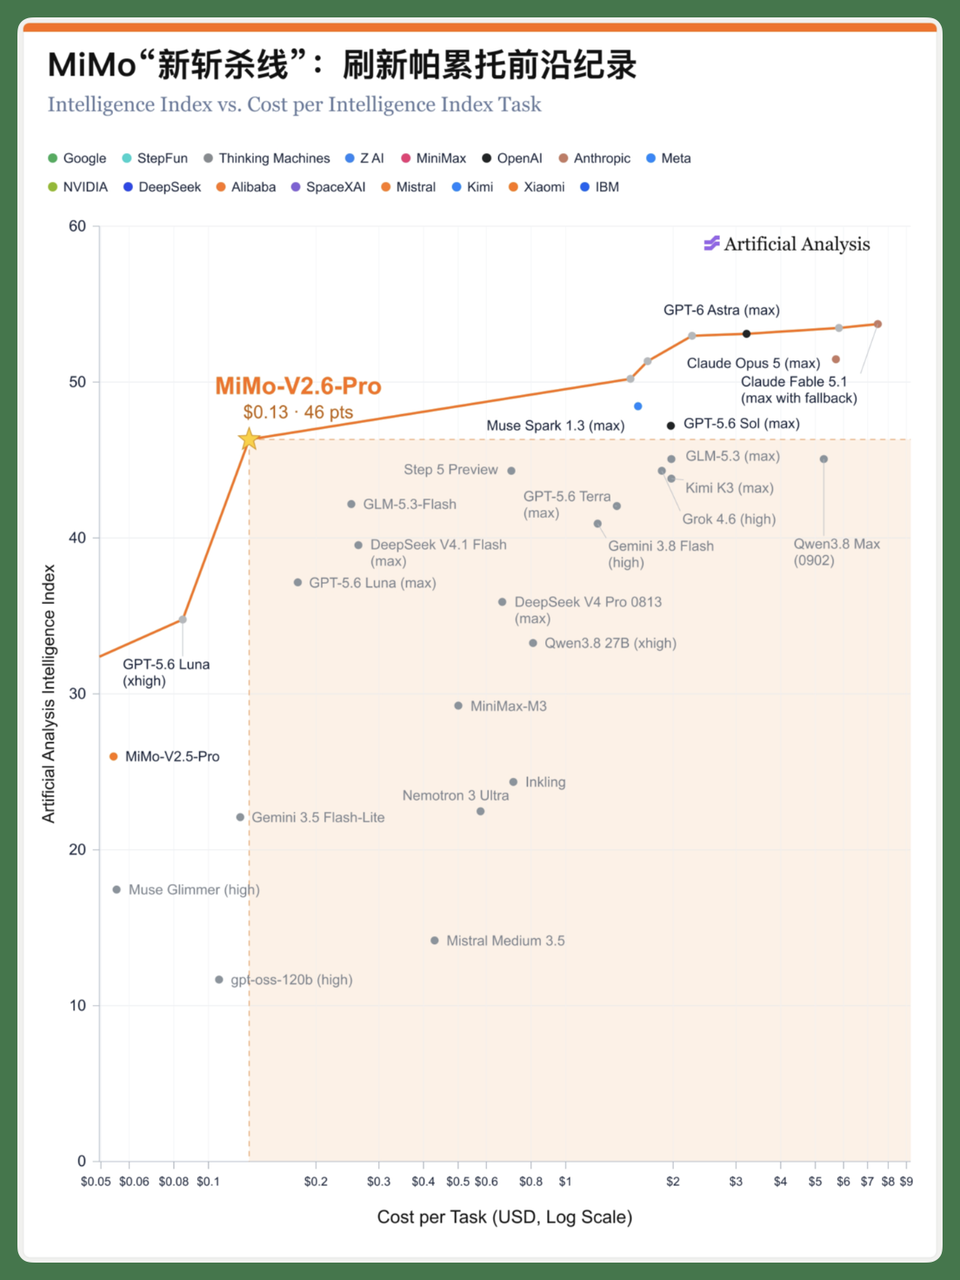
Ngày 22 tháng 9, Xiaomi đã phát hành và mở mã nguồn dòng MiMo-V2.6 thế hệ mới. Ba mô hình mới có mức độ thông minh gần gấp đôi thế hệ trước nhưng giá thành không đổi.
Theo tọa độ này, dòng mô hình MiMo-V2.6 dự kiến sẽ tạo ra một "ngưỡng chém giết" mới về ranh giới giữa trí tuệ và chi phí, đặc biệt là với mô hình V2.6-Pro. Hiện tại, nằm dưới ngưỡng này sẽ là đại đa số các mô hình mã nguồn mở. Còn nằm trên ngưỡng này, có lẽ chỉ còn lại 5 mô hình cao cấp đóng (closed-source) hàng đầu như GPT-6Astra, Fable5.
So với Grok 4.7 ra mắt cùng ngày, MiMo-V2.6 đạt chỉ số thông minh ngang bằng với 46 điểm, nhưng chi phí cho mỗi tác vụ chỉ tốn 0,13 USD. Trong khi đó, chi phí tác vụ đơn lẻ của Grok 4.7 ở cường độ suy luận cao và cực cao lần lượt đạt 2,73 USD và 3,74 USD, gấp khoảng 21 và 29 lần so với MiMo-V2.6.
Nói cách khác, với mức độ thông minh tương đương, MiMo-V2.6 thể hiện ưu thế vượt trội về hiệu quả chi phí, khiến Grok 4.7 bị tụt hậu ngay khi vừa ra mắt xét trên khía cạnh "trí tuệ - chi phí".
🚥
Tiếp theo, chúng ta hãy cùng thảo luận tại sao lại là nửa cuối năm 2026, khi hiệu suất trở thành trọng tâm.
Từ tháng 6 đến tháng 9, tại sao nhiều nhà sản xuất lại cùng đi theo con đường hiệu suất?
Trong hai năm qua, cuộc cạnh tranh giữa các mô hình nền tảng hầu như chỉ có một chủ đề chính: trí tuệ mạnh hơn, làm cho mô hình trở nên "Smart" hơn.
Nhưng đến năm 2026, bộ tiêu chuẩn đánh giá này bắt đầu thay đổi rõ rệt.
Một tín hiệu trực tiếp là hầu hết các nhà sản xuất mô hình hàng đầu đều bắt đầu đầu tư nguồn lực lớn vào khía cạnh "trí tuệ - chi phí".
Một mặt, điều này có thể coi đơn giản là "ngành công nghiệp cạnh tranh khốc liệt hơn, ngoài cạnh tranh trí tuệ còn phải cạnh tranh chi phí", nhưng mặt khác, đây thực chất là sự thay đổi giai đoạn của các mô hình nền tảng, phản ánh nhu cầu thực tế của người dùng.
Kể từ tháng 6 năm nay, Google, OpenAI, Anthropic, cũng như các đơn vị trong nước như GLM, Qwen, DeepSeek đều liên tục điều chỉnh phân cấp mô hình và giá cả.
Google nhanh chóng lặp lại dòng sản phẩm Flash; OpenAI chia mô hình thành ba cấp Sol, Terra, Luna, trong đó Luna chuyên phục vụ các yêu cầu tần suất cao, chi phí thấp; Anthropic cũng tiếp tục giảm chi phí sử dụng các mô hình như Sonnet, Opus.
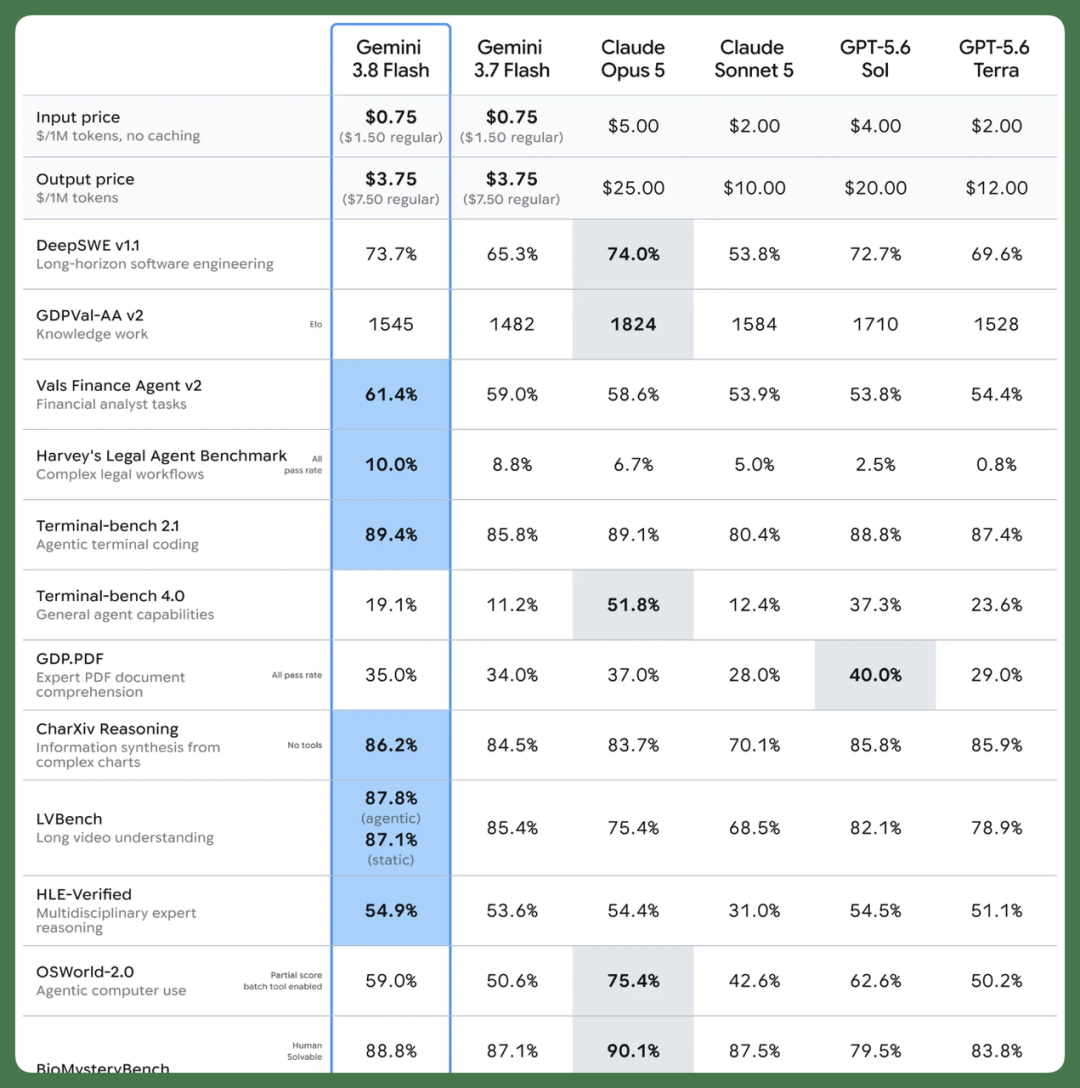
Trong nước cũng vậy, GLM, Qwen, DeepSeek đều bắt đầu nhấn mạnh thường xuyên vào "hiệu suất", "chi phí" và "đường biên Pareto".
Vấn đề mà các nhà sản xuất mô hình quan tâm đã chuyển dịch sang vấn đề mà người dùng thực tế phải đối mặt:
"Với cùng một mức độ thông minh, liệu có thể hoàn thành Workflow của tôi với chi phí thấp hơn không? Viết xong một PRD, hoàn thành một dự án, liệu có thể tốn ít tiền hơn không? Tốn ít hạn mức hơn không?". Đằng sau điều này thực chất là cách sử dụng AI đã trở nên chuyên sâu hơn, đây có thể coi là một bước chuyển tích cực.
Trước đây mọi người dùng Chatbot, một lần gọi thường chỉ tương ứng với một câu trả lời. Bây giờ bước vào giai đoạn Agent, một tác vụ có thể kéo dài vài giờ, đọc tệp, gọi công cụ, sửa mã, chạy, kiểm tra và thử lại liên tục.
Đằng sau một tác vụ có thể là hàng chục, thậm chí hàng trăm lần gọi mô hình và Tools.
Vì vậy, khi AI thực sự đi vào Workflow, các lập trình viên độc lập và các nhóm B-end buộc phải bắt đầu tính toán chi phí tiêu thụ:
1 Tác vụ cuối cùng có hoàn thành được không
2 Cần bao nhiêu thời gian để hoàn thành
3 Tổng chi phí cho toàn bộ quá trình là bao nhiêu
Lúc này, việc dẫn trước vài điểm trong các bài kiểm tra Artificial Analysis đơn lẻ đã khó có thể đại diện hoàn toàn cho giá trị của một mô hình trong các tình huống thực tế.
Đặc biệt là trong các kịch bản Agent, một mô hình dù khả năng đơn lẻ hơi yếu, nhưng chỉ cần tốc độ nhanh hơn, chi phí thấp hơn, cho phép Agent lập kế hoạch thêm vài bước, gọi công cụ thêm vài lần, thử nghiệm thêm vài vòng, thì cuối cùng vẫn có khả năng hoàn thành cùng một tác vụ.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ elsewhere: Bài viết. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.