Tin ngành
Google Research ra mắt R4T: Bộ truy xuất khuếch tán giúp tăng tốc truy vấn gấp 12-20 lần
(giờ Việt Nam)
Tóm tắt AI
Google Research giới thiệu R4T, sử dụng học tăng cường để tối ưu hóa truy vấn và chưng cất vào mô hình Diffusion Transformer, cho phép tạo toàn bộ hướng truy xuất chỉ trong một lần chạy duy nhất.
Bản dịch AI
Các hệ thống tìm kiếm và gợi ý ngày càng cần trả về một tập hợp kết quả thay vì chỉ một kết quả khớp nhất. Một truy vấn như ‘camping gear’ (dụng cụ cắm trại) nên trả về lều, túi ngủ, bếp và đèn đeo đầu, thay vì trả về 10 chiếc lều gần như giống hệt nhau.
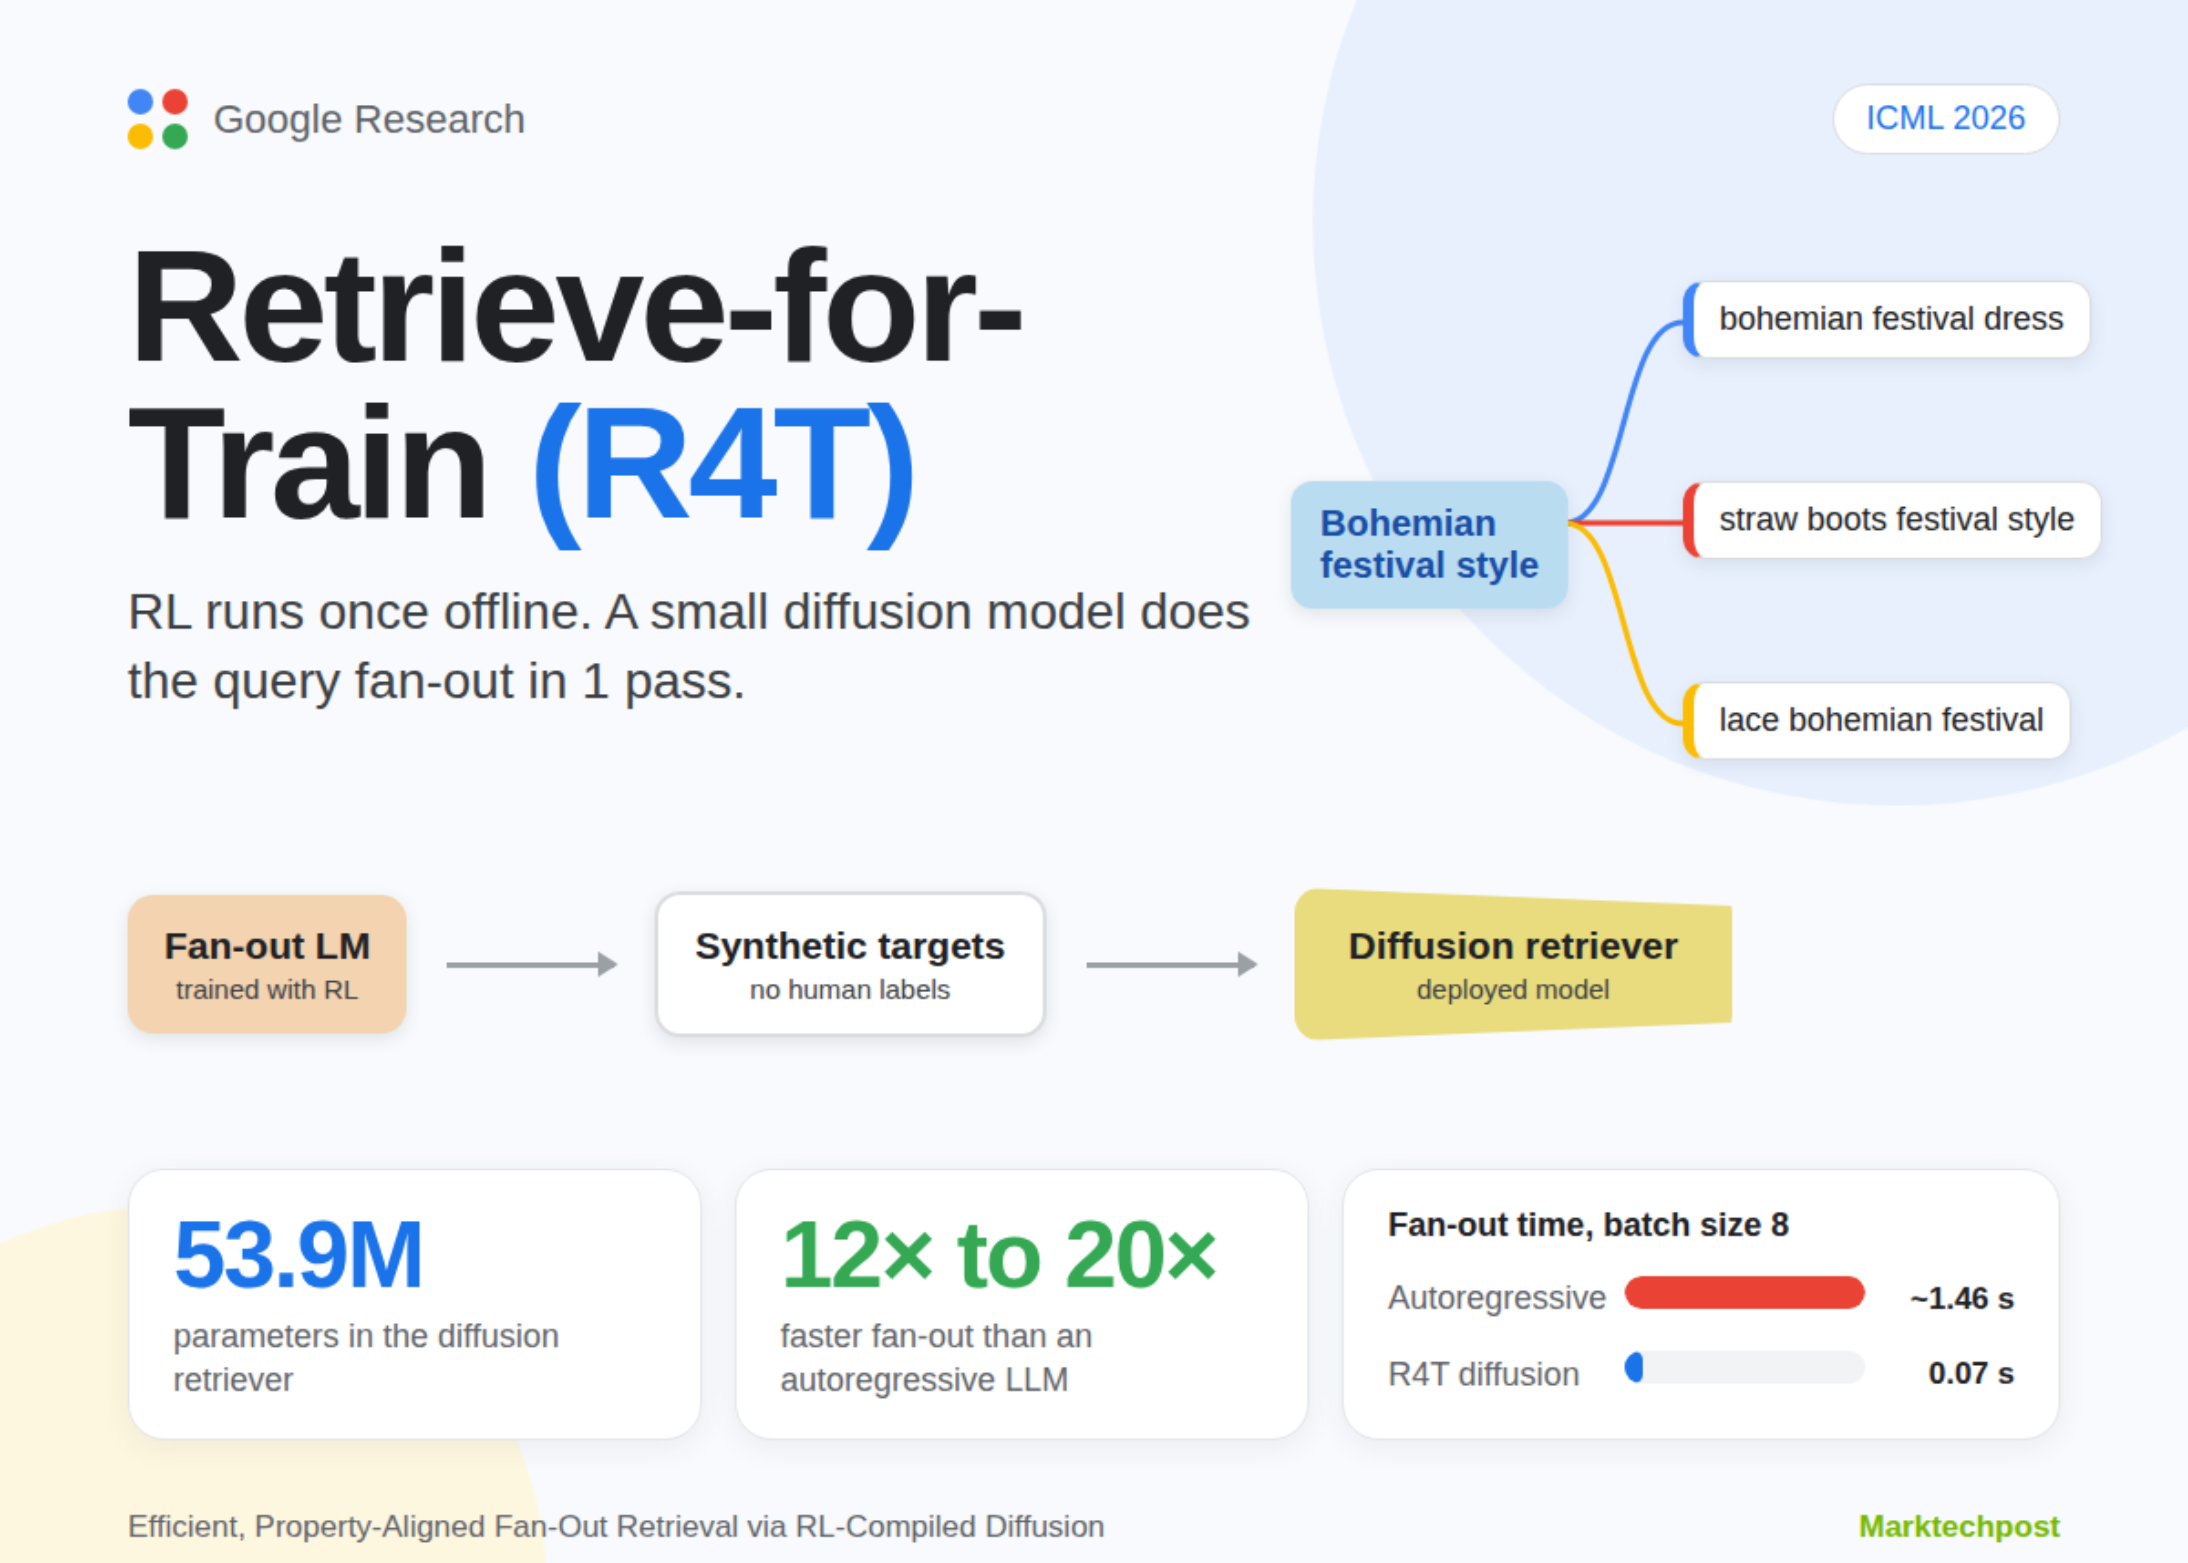
Google Research đã giới thiệu Retrieve-for-Train (R4T) để giải quyết vấn đề này. Khung làm việc này sử dụng học tăng cường (RL) một lần, ngoại tuyến (offline), để học cách phân nhánh truy vấn (query fan-out) hiệu quả. Sau đó, nó chưng cất hành vi đó vào một mô hình khuếch tán (diffusion model) nhỏ, cho phép tạo ra tất cả các hướng truy xuất chỉ trong 1 lần chạy.
Tại sao phương pháp phân nhánh truy vấn tiêu chuẩn lại thiếu hiệu quả
Phân nhánh truy vấn chia một câu lệnh (prompt) rộng thành nhiều truy vấn con. Nhóm nghiên cứu xác định 2 vấn đề khi một LLM thông thường thực hiện việc này tại thời điểm suy luận (inference).
Vấn đề đầu tiên là sự sụp đổ diễn giải (paraphrastic collapse). Đối với truy vấn ‘Bohemian festival style’, mô hình Qwen3-4B ở chế độ zero-shot đã viết ra ‘bohemian festival fashion’ và ‘festival bohemian clothes’. Những từ gần như đồng nghĩa này dẫn đến việc truy xuất ra một tập hợp kết quả đồng nhất.
Vấn đề thứ hai là độ trễ. Việc tạo văn bản tự hồi quy (autoregressive generation) cộng với các lệnh gọi truy xuất lặp đi lặp lại rất chậm. Phương pháp lấy mẫu Best-of-N giúp cải thiện chất lượng nhưng lại làm tăng chi phí suy luận.
Quy trình 3 bước của R4T
Thiết kế phần thưởng và tấn công phần thưởng (Reward Hacking)
Đối với truy xuất trừu tượng mở (OAR), phần thưởng kết hợp 3 thành phần có trọng số:
Đối với truy xuất thành phần có giám sát yếu (WSCR), phần thưởng là tỷ lệ các mục trong tập tham chiếu mà quá trình phân nhánh truy xuất được.
Phân tích ablation giải thích lý do tại sao cả 3 thành phần của OAR đều quan trọng. Nếu chỉ sử dụng tính căn cứ (groundedness), Gemma3-4B sẽ hội tụ về các chuỗi như ‘line ending line ending line ending’. Việc thêm tính căn chỉnh (alignment) khiến sự sụp đổ diễn ra nhanh hơn vì chính sách này lặp lại các cách diễn giải của truy vấn. Việc thêm tính đa dạng (diversity) đã loại bỏ cả hai lối tắt này.
Quá trình huấn luyện sử dụng GRPO với cơ chế điều chuẩn soft PPO, bổ sung các hình phạt KL thuận và nghịch. Các thiết lập chính bao gồm kích thước nhóm (group size) là 8, tốc độ học 1×10⁻⁷ và kích thước batch toàn cục là 512.
Giải thích tương tác
Kết quả
Các thí nghiệm sử dụng tập dữ liệu trang phục thời trang Polyvore với bộ mã hóa matryoshka dựa trên CLIP ở 128 chiều. Họ cũng sử dụng một tập dữ liệu nhạc danh sách phát chuyên gia độc quyền với các embedding MuLan. Mỗi phương pháp phân nhánh tạo ra k = 10 truy vấn con và Best-of-N sử dụng N = 5.
Chất lượng OAR được đánh giá bởi một LLM judge trên thang đo Likert 5 điểm. Trên Polyvore, Gemma3-4B R4T-FOLM đạt trung bình 49,1 điểm, so với 40,9 của Best-of-N và 38,5 của zero-shot. Tính đa dạng tăng từ 56,0 (zero-shot) lên 76,8. R4T-Diffusion duy trì được phần lớn chỉ số này ở mức 74,3. Trên tập dữ liệu nhạc, Gemma3-4B R4T-FOLM đạt trung bình 58,1 so với 49,2 của Best-of-N. Tính căn cứ không được báo cáo cho R4T-Diffusion vì nó không tạo ra các truy vấn con dạng văn bản.
Kết quả WSCR trên Polyvore cho thấy sự đánh đổi giữa độ bao phủ và tính đa dạng. R4T-FOLM (Qwen) đạt 20,9 Recall@5K và 64,6 Hit@5K, so với 15,7 và 52,1 của Gemini-2.5-Flash. Tuy nhiên, Vendi Score của nó giảm xuống còn 27,5. Các tác giả liên kết điều này với việc giảm entropy đầu ra dưới sự tối ưu hóa mạnh mẽ của RL. R4T-Diffusion (Qwen) giữ được Vendi Score cao hơn là 34,7 với 16,5 Recall@5K.
Hiệu suất
Ở kích thước batch là 8, phân nhánh truy vấn tự hồi quy mất khoảng 1,46 giây. Mô hình khuếch tán mất 0,07 giây. Ở kích thước batch 1024, phân nhánh tự hồi quy mất gần 50 giây, so với 4,21 giây của mô hình khuếch tán. Các tác giả báo cáo tốc độ tăng ổn định từ 12 đến 20 lần.
Những điểm chính cần lưu ý
Hãy xem bài báo và các chi tiết kỹ thuật. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy theo dõi chúng tôi trên Twitter, đừng quên tham gia SubReddit ML với hơn 150 nghìn thành viên và đăng ký nhận bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, trang Hugging Face, sản phẩm mới hoặc hội thảo trực tuyến, v.v.? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt nền tảng truyền thông về Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy và học sâu, đảm bảo tính kỹ thuật nhưng vẫn dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.