Mô hình
Alibaba Qwen ra mắt Qwen-Audio-3.1-Realtime: Mô hình giọng nói song công toàn phần với khả năng tư duy và phản hồi tự nhiên
(giờ Việt Nam)
Tóm tắt AI
Đội ngũ Qwen của Alibaba vừa giới thiệu dòng Qwen-Audio-3.1, nổi bật với mô hình song công toàn phần qwen-audio-3.1-realtime-plus. Dịch vụ này hiện cung cấp qua API với mức giảm giá sâu cho các tính năng Realtime, TTS và ASR.
Chính văn · Bản dịch AI
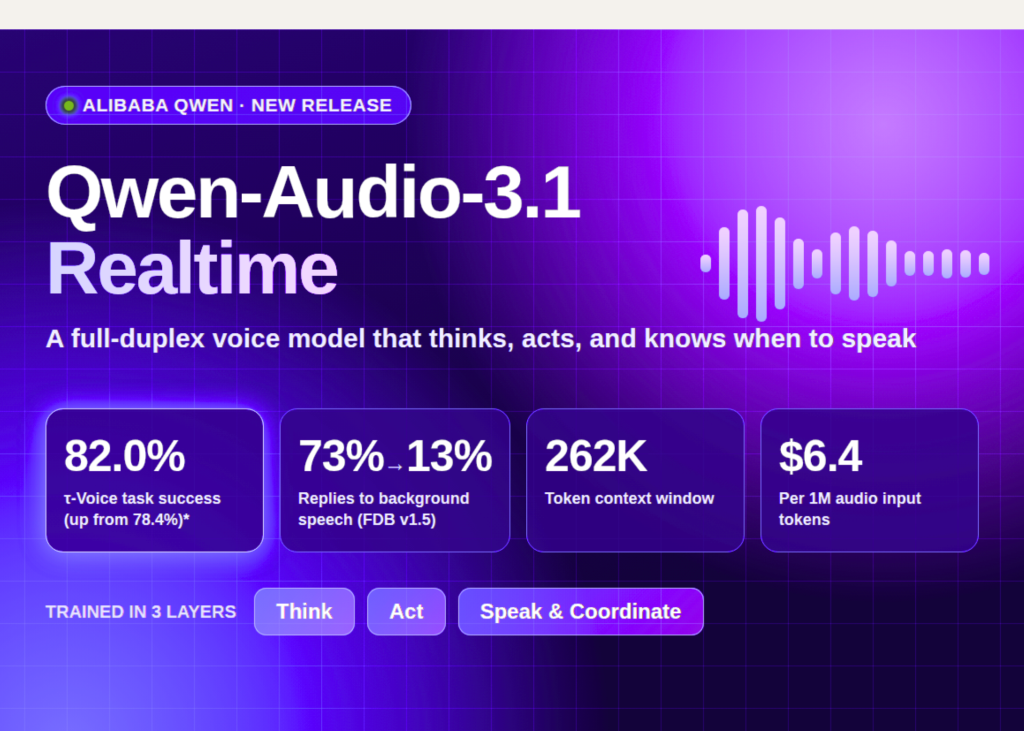
Đội ngũ Qwen của Alibaba đã phát hành Qwen-Audio-3.1, một bộ công cụ âm thanh gồm 5 mô hình bao gồm ASR, TTS và tương tác thời gian thực. Mô hình chính là Qwen-Audio-3.1-Realtime, một mô hình giọng nói song công (full-duplex) được xây dựng cho các tác nhân giọng nói có khả năng gọi công cụ. Qwen cũng giảm giá: khoảng 85% cho Realtime, khoảng 70% cho TTS và lên tới 95% cho ASR.
Có thể triển khai được không? Có, dưới dạng API được quản lý. qwen-audio-3.1-realtime-plus hiện đã có mặt trên QwenCloud qua WebSocket. Không có thông tin về việc công khai trọng số mô hình.
Những gì có trên QwenCloud
Trang mô hình liệt kê cả văn bản và âm thanh là đầu vào và đầu ra. Ngữ cảnh là 262K token, với tối đa 245K đầu vào và 16K đầu ra. Giới hạn mặc định là 60 yêu cầu và 100K token mỗi phút. Giá là 6,4 USD cho mỗi 1 triệu token đầu vào âm thanh và 0,8 USD cho mỗi 1 triệu token đầu vào văn bản. Đầu ra văn bản và âm thanh có giá 24 USD cho mỗi 1 triệu token, trong đó văn bản đầu ra không bị tính phí. Các tính năng chính bao gồm gọi hàm, tìm kiếm web, đầu ra có cấu trúc, bộ nhớ đệm ngữ cảnh và tinh chỉnh (fine-tuning).
Một mô hình đi kèm, Qwen-Audio-3.1-ASR-Flash-Filetrans, nhắm đến việc chuyển đổi âm thanh dài ngoại tuyến. Nó hỗ trợ từ khóa nóng, tách người nói, dấu câu và nhận dạng đa ngôn ngữ cộng với các phương ngữ tiếng Trung. Chi phí là 0,15 USD cho đầu vào và 0,47 USD cho đầu ra trên mỗi 1 triệu token.
Kiến trúc: 2 mô hình đằng sau 1 giọng nói
Hệ thống chạy 2 mô hình với cùng thiết kế Audio Encoder và LLM. Một mô hình quyết định song công dự đoán liệu có nên tiếp tục lắng nghe, nói, dừng hay tiếp tục. Một mô hình chuyển đổi giọng nói thành văn bản sẽ viết nội dung phản hồi dưới dạng văn bản. Sau đó, một trình kết xuất giọng nói nhận biết ngữ cảnh sẽ chuyển văn bản đó thành giọng nói phát trực tuyến. Nó dựa trên lịch sử hội thoại, tín hiệu giọng nói và ngữ cảnh âm thanh.
Quá trình đào tạo được tổ chức thành 3 lớp: Suy nghĩ (Think), Hành động (Act), và Nói & Phối hợp (Speak and Coordinate).
Suy nghĩ: M²-OPD
Core-Cocktail SFT tái thiết lập mô hình âm thanh với LLM văn bản nguồn của nó bằng cách sử dụng dữ liệu ghép đôi quy mô hàng triệu giờ. Tiếp theo là OPD đa phương thức. Một giáo viên văn bản (Text Teacher) và một tham chiếu âm thanh cố định (frozen Audio Reference) chấm điểm từng token trong quỹ đạo của chính học viên. Đây là chưng cất on-policy, không phải bắt chước các câu trả lời được viết sẵn. Các chuyên gia miền về sự đồng cảm, ý định thực dụng và bối cảnh âm thanh sau đó được đào tạo với GRPO. Multi-Teacher OPD hợp nhất chúng thành 1 mô hình có thể triển khai.
Hành động: Môi trường thực thi
Mỗi miền đào tạo bao gồm một nhóm công cụ, cơ sở dữ liệu JSON có trạng thái và chính sách kinh doanh bằng ngôn ngữ tự nhiên. Các miền được tạo từ các định nghĩa công cụ mã nguồn mở và máy chủ MCP. Mỗi tác vụ xác định 1 trong 3 kết quả: ghi, từ chối có lý do, hoặc yêu cầu không được hỗ trợ. Việc chấm điểm kiểm tra trạng thái cuối cùng, sau đó là các lệnh ghi được phép, rồi đến các khẳng định hành vi. Một câu trả lời trôi chảy không thể cứu vãn một trạng thái kiểm tra thất bại.
GRPO nhận phần thưởng ở cấp độ hội thoại, cột mốc và lượt. Đào tạo tìm kiếm phạt các truy vấn dư thừa với rquery=qmin(1,nrefnpred)r_{\text{query}} = q \min \left( 1, \frac{n_{\text{ref}}}{n_{\text{pred}}} \right). Số truy vấn trung bình cho mỗi lệnh gọi tìm kiếm giảm từ 4,37 xuống 1,05. Trigger F1 giảm từ 60,87% xuống 58,61%.
Nói và Phối hợp
Lớp này quyết định liệu có nên nói, khi nào nói và nói như thế nào. Trên Full-Duplex-Bench v1.5, các phản hồi cho những người đang nói chuyện với người khác giảm từ 0,13 xuống 0,03. Trên v3.0, tỷ lệ từ đệm (filler rate) giảm từ 0,7590 xuống 0,2960. Có những sự đánh đổi. Sau khi bị ngắt lời, tỷ lệ tiếp tục không mong muốn tăng từ 0,035 lên 0,130. Độ trễ dừng ngắt lời là 1,116 giây, so với 0,383 của GPT-Realtime-2.
Giải thích tương tác
Khám phá vòng lặp Suy nghĩ, Hành động, Nói, các quyết định song công, một tập đào tạo được chấm điểm và phần thưởng tìm kiếm.
Các điểm chuẩn (Benchmarks) trong nháy mắt
So với 3.0, Audio MultiChallenge tăng từ 47,12 lên 52,21. Điểm trung bình BBA 14 ngôn ngữ tăng từ 81,7% lên 88,1%. FLEURS WER giảm từ 9,01 xuống 3,98. Các số liệu τ-Voice sử dụng bản chuyển đổi giọng nói thành văn bản bán song công. Chúng không thể so sánh với kết quả song công chính thức. GPT-Realtime-2 vẫn dẫn đầu nghiên cứu red-team trên người với 50 phiên, 96,00% so với 92,00%.
So sánh như thế nào
| Tính năng | Qwen-Audio-3.1-Realtime-Plus | OpenAI GPT-Realtime-2 | Google Gemini 3.8 Live |
|---|---|---|---|
| Đầu vào | Văn bản, âm thanh | Văn bản, âm thanh, hình ảnh | Văn bản, hình ảnh, âm thanh, video |
| Đầu ra | Văn bản, âm thanh | Văn bản, âm thanh | Văn bản và âm thanh |
| Giới hạn ngữ cảnh / đầu vào | 262K | 128K | 131,072 |
| Đầu ra tối đa | 16K | 32K | 65,536 |
| Gọi hàm | Có | Có | Có (mặc định là bất đồng bộ) |
| Tìm kiếm web tích hợp | Có | Không liệt kê | Nền tảng tìm kiếm Google |
| Suy luận | Chế độ suy nghĩ, tối đa 2K suy luận | Nỗ lực có thể cấu hình | Suy luận xen kẽ |
| Đầu vào âm thanh / 1 triệu token | $6.4 | $32 | $3.00 |
| Đầu ra âm thanh / 1 triệu token | 24 USD (văn bản và âm thanh) | $64 | $12.00 |
| Trọng số mở | Không | Không | Không |
| Nguồn | QwenCloud | Tài liệu OpenAI | Trang model, bảng giá |
Giá niêm yết được kiểm tra vào ngày 28 tháng 9 năm 2026. Tỷ lệ token không thể so sánh trực tiếp vì mỗi nhà cung cấp có cách token hóa âm thanh khác nhau.
Điểm tin chính
- Tỷ lệ thành công của tác vụ trên bản chuyển đổi τ-Voice tăng từ 78,4% lên 82,0% so với phiên bản 3.0.
- Phản hồi đối với lời nói nền giảm từ 73,0% xuống 13,0% trên Full-Duplex-Bench v1.5.
- Cửa sổ ngữ cảnh 262K, hỗ trợ gọi hàm (function calling) và tìm kiếm web với giá 6,4 USD cho mỗi 1 triệu token đầu vào âm thanh.
- Khả năng sử dụng công cụ (tool use) được huấn luyện bằng GRPO trong các môi trường thực thi tự tiến hóa.
- Tỷ lệ thành công của các cuộc tấn công đa lượt giảm xuống còn 26,0% (tiếng Trung) và 23,5% (tiếng Anh).
Câu hỏi thường gặp (FAQ)
- Qwen-Audio-3.1-Realtime là gì? Đây là một mô hình giọng nói song công (full-duplex) từ đội ngũ Qwen của Alibaba, dành cho các tác nhân giọng nói có khả năng suy luận, gọi công cụ và quản lý lượt hội thoại.
- Tôi có thể tự lưu trữ (self-host) mô hình này không? Chưa có thông báo về việc mở trọng số. Bạn có thể truy cập thông qua QwenCloud API với tên gọi qwen-audio-3.1-realtime-plus.
- Chi phí là bao nhiêu? 6,4 USD cho mỗi 1 triệu token đầu vào âm thanh và 24 USD cho mỗi 1 triệu token đầu ra cho cả văn bản và âm thanh.
Xem Bài báo, Qwen-Audio-3.1-ASR, và Qwen-Audio-3.1-Realtime. Mọi ghi nhận xin dành cho các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit 150k+ ML cũng như đăng ký Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bạn cũng có thể tham gia cùng chúng tôi trên Telegram ngay bây giờ.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, Hugging Face Page, Sản phẩm mới hoặc Hội thảo trực tuyến, v.v.? Kết nối với chúng tôi
Asif Razzaq
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt nền tảng truyền thông về Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về học máy và học sâu, đảm bảo tính kỹ thuật nhưng vẫn dễ hiểu đối với đông đảo độc giả. Nền tảng này tự hào với hơn 2 triệu lượt xem mỗi tháng, minh chứng cho sự phổ biến của nó đối với công chúng.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.