Hướng dẫn
Cơ chế chú ý thưa (Sparse Attention) trên GLM5.3 ảnh hưởng thế nào đến bộ nhớ HBM?
(giờ Việt Nam)
Tóm tắt AI
Phân tích từ SemiAnalysis chỉ ra rằng cơ chế chú ý thưa trên GLM5.3 chỉ tối ưu hóa băng thông và bộ nhớ cho KV cache trong quá trình tính toán SDPA, chứ không giảm tổng dung lượng HBM cần thiết do yêu cầu lưu trữ toàn bộ ngữ cảnh cho việc chọn lọc top-k.
Chính văn · Bản dịch AI
Sparse attention ảnh hưởng thế nào đến TAM của bộ nhớ, bao gồm HBM và NAND? Sparse attention chọn ra top-k token liên quan nhất để chú ý, giúp giảm mức tiêu thụ bộ nhớ và yêu cầu băng thông trong quá trình thực hiện thao tác Scaled Dot-Product Attention (SDPA) cốt lõi. Tuy nhiên, việc cải thiện hiệu suất này không trực tiếp chuyển đổi thành khả năng tiết kiệm bộ nhớ tổng thể trong thực tế. Cụ thể, thao tác chọn top-k thường yêu cầu toàn bộ ngữ cảnh phải nằm trong HBM, vì vậy sparse attention không loại bỏ được nút thắt về dung lượng bộ nhớ.
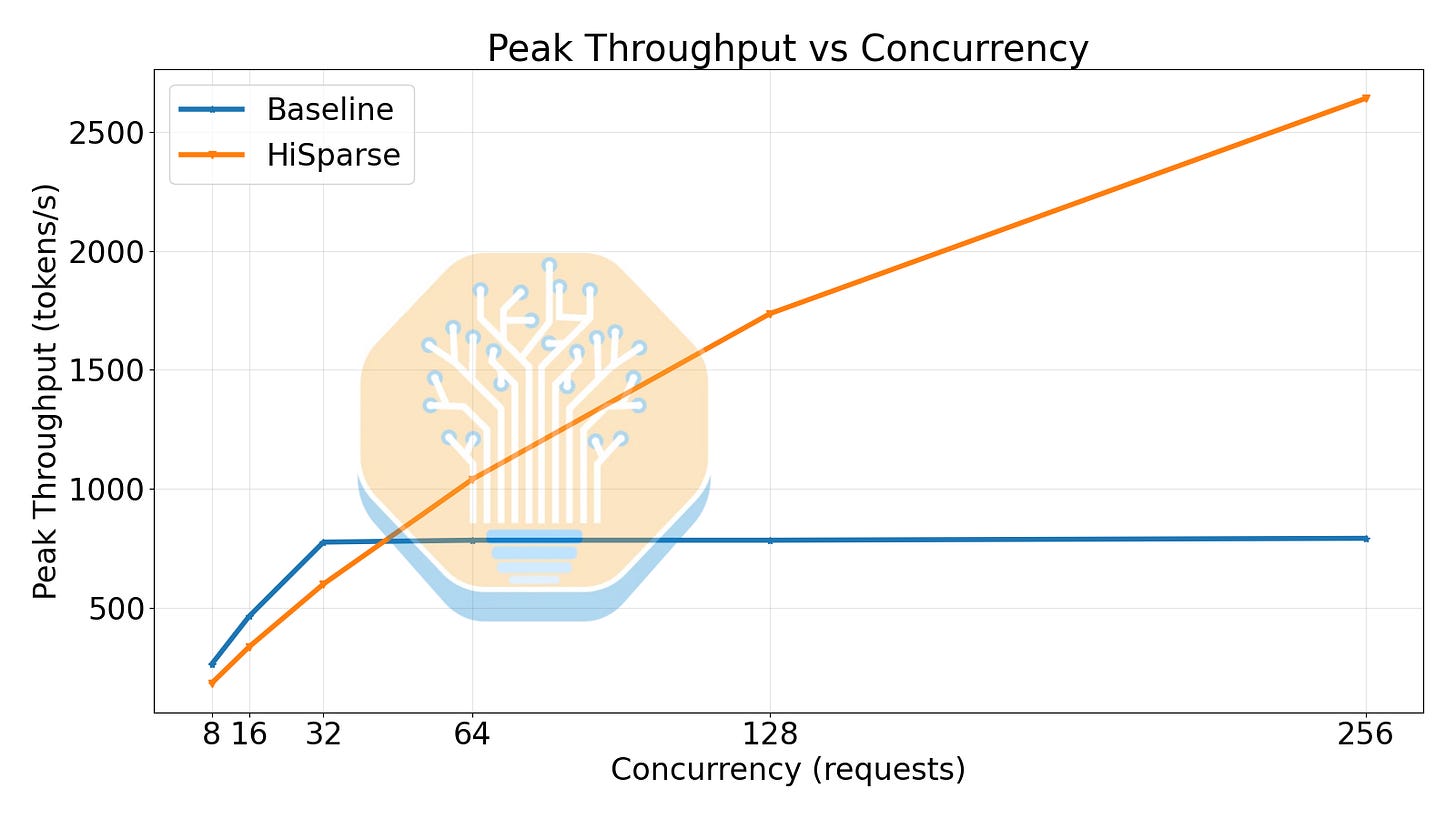
Để khắc phục hạn chế này, đội ngũ SGLang đã thiết kế HiSparse, một hệ thống bộ nhớ phân cấp chủ động chuyển các mục KV cache từ HBM của thiết bị sang DRAM của máy chủ. HiSparse hoạt động giống như một bộ nhớ đệm LRU (Least Recently Used), nơi nó tải các token từ DRAM vào HBM khi xảy ra cache miss trong quá trình chọn top-k, và chuyển các token từ HBM sang DRAM dựa trên chính sách loại bỏ LRU. Để giảm độ trễ khi cache miss, HiSparse thực hiện chồng lấp việc tải KV cache của lớp N với quá trình thực thi lớp N-1 (chồng lấp theo lớp), một kỹ thuật đã được giới thiệu trong công trình trước đó của HiSparse là HiCache.
Với HiSparse, SGLang tăng đáng kể thông lượng trong các kịch bản có độ đồng thời cao và ngữ cảnh dài, đổi lại là chi phí I/O do cache miss của top-k.
Sparse attention giúp giảm yêu cầu về bộ nhớ và băng thông KV cache tại thao tác SDPA, nhưng nó không giảm mức sử dụng dung lượng bộ nhớ tổng thể. Ngoài ra, HiSparse cho thấy các tối ưu hóa hệ thống có thể vượt qua những hạn chế về dung lượng bộ nhớ của sparse attention, vì vậy chỉ riêng hồ sơ bộ nhớ của sparse attention không thể phản ánh đầy đủ bức tranh về hiệu quả KV cache của hệ thống. Để cung cấp cái nhìn toàn diện hơn về việc phục vụ các mô hình sparse attention, tại đây chúng tôi giải thích thiết kế của dòng mô hình GLM-5 của Z.ai và cách chúng được phục vụ trong thực tế.
Trong bảng xếp hạng benchmark thời gian thực InferenceX của chúng tôi, GB300 mang lại chi phí phục vụ mô hình thấp nhất trong so sánh của chúng tôi với tốc độ phản hồi 150 token mỗi giây. GB300 xử lý nhiều token hơn trên mỗi GPU, và chi phí hàng giờ cao hơn của nó vẫn giúp nó vượt trội hơn GB200 về hiệu quả chi phí. Kết quả của GB300 sử dụng Dynamo-TRT-LLM, trong khi kết quả của GB200 sử dụng Dynamo-SGLang.
Chúng tôi sử dụng kết quả từ bản chụp AgentX ngày 17 tháng 9 để minh họa các tác động phục vụ của GLM-5.3. Chúng tôi ước tính chi phí bằng cách sử dụng mô hình của InferenceX về việc sở hữu và vận hành cơ sở hạ tầng ở quy mô hyperscaler. Tổng số token bao gồm đầu vào và đầu ra được tạo, bao gồm cả lịch sử đầu vào được lưu trong cache và tái sử dụng qua các lượt. Tốc độ truyền phát (streaming) được đo bằng độ tương tác p90; thời gian đến token đầu tiên (TTFT) được đánh giá riêng biệt.
Ở mức 150 token mỗi giây, GB200 có chi phí khoảng 0,044 USD cho mỗi triệu tổng số token, so với 0,238 USD của MI355X khi chạy ATOM. Đó là mức chi phí thấp hơn khoảng 82% ở cùng mục tiêu tốc độ truyền phát. Các giá trị này được ước tính từ các đường cong đo lường, thay vì từ một bài kiểm tra riêng biệt ở chính xác 150 token mỗi giây.
Đối với so sánh này, chúng tôi sử dụng chi phí ước tính của InferenceX về việc sở hữu và vận hành cơ sở hạ tầng ở quy mô hyperscaler. Tổng số token bao gồm đầu vào và đầu ra được tạo, bao gồm cả lịch sử đầu vào được tái sử dụng từ cache.
Trong số các kết quả của Dynamo-SGLang, GB300 phục vụ khoảng 13.950 tổng số token mỗi giây trên mỗi GPU, lợi thế thông lượng 17,5% so với 11.873 tổng số token của GB200. Tuy nhiên, chúng tôi giả định chi phí 2,31 USD cho mỗi giờ GPU GB300 so với 1,86 USD cho GB200. Chi phí hàng giờ cao hơn đã bù đắp đáng kể lợi thế thông lượng của GB300 ở mục tiêu này.
Trong so sánh với AMD, GB200 có chi phí thấp hơn khoảng 52% so với ATOM ở mức 100 token mỗi giây, thấp hơn 62% ở mức 125 và thấp hơn 82% ở mức 150. Trên ba mục tiêu này, khoảng cách ngày càng rộng khi tốc độ phản hồi tăng lên.
Chỉ tính đầu ra được tạo, GB200 có chi phí 5,92 USD cho mỗi triệu token đầu ra ở tốc độ phản hồi 150 token mỗi giây, thấp hơn 79% so với 28,52 USD của MI355X ATOM. Chỉ số này hữu ích để phân tích chi phí dưới các khối lượng công việc đại lý (agentic workloads), nơi các đại lý liên tục tái sử dụng lịch sử đầu vào dài trong khi tạo ra tương đối ít văn bản mới.
Các phép đo GB200 ở hai bên mục tiêu 150 token mỗi giây có p90 TTFT (thời gian đến token đầu tiên) là 14-19 giây, so với 1,3-1,7 giây đối với MI355X ATOM. Một số lần chạy có chi phí thấp nhất của GB200 có thời gian chờ đợi token đầu tiên lâu hơn nhiều.
Do đó, chúng tôi thực hiện so sánh thứ hai chỉ sử dụng các cấu hình đã được kiểm tra thực tế và đạt ít nhất 150 token mỗi giây với p90 TTFT dưới hai giây. Biểu đồ dưới đây cho thấy B200 với Dynamo-SGLang ở mức 0,0666 USD cho mỗi triệu tổng số token so với 0,1265 USD cho MI355X với SGLang. B200 vẫn có chi phí thấp hơn khoảng 47% với giới hạn token đầu tiên.
Trong mô hình 5.2 / 5.3 của GLM, kiến trúc chú ý của nó làm giảm nhu cầu bộ nhớ, và các đại lý chạy lâu vẫn cần giữ lại lịch sử hội thoại trước đó. GLM giảm chi phí xử lý lịch sử này theo hai cách: KV compression giảm trạng thái được lưu trong cache cho mỗi token, và sparse attention giảm lượng trạng thái mà mỗi thao tác chú ý đọc. Sau đó, công cụ phục vụ sẽ xác định nơi lưu trữ cache và cách truy xuất nó một cách hiệu quả.
Những kết quả B200 này cho thấy mức độ tái sử dụng có thể xảy ra bên ngoài bộ nhớ GPU. Khi độ đồng thời tăng từ 8 lên 16 yêu cầu, tỷ lệ token nhắc (prompt tokens) được tái sử dụng từ bộ nhớ GPU giảm từ 90,3% xuống 54,8%. Phần lớn sự tái sử dụng đó chuyển sang bộ nhớ máy chủ, tăng từ 6,0% lên 40,3%. Phần lớn sự sụt giảm trong cache GPU được bù đắp bằng việc tái sử dụng từ bộ nhớ máy chủ, giữ cho tỷ lệ cache hit tổng thể trên 95% ở mọi cấp độ đồng thời.
Ngoài việc quản lý cache, các thay đổi về cách công cụ phục vụ thực hiện prefill và giải mã cũng có thể thay đổi hiệu suất. Hai nghiên cứu riêng biệt về GLM-5.2 minh họa điều này:
- vLLM giữ bước giải mã đầu tiên trên đường dẫn thực thi CUDA graph nhất quán đã giảm TPOT (thời gian cho mỗi token đầu ra) trung bình từ khoảng 40 ms xuống 22 ms trong một nghiên cứu NVFP4.
- Trên một khối lượng công việc ngữ cảnh dài 8 MI355X khác, công cụ ATOM xử lý prefill theo từng khối qua các giai đoạn pipeline đã mang lại thông lượng tổng thể cao hơn 98% và giảm TTFT trung bình từ 28,6 xuống 8,7 giây.
Đối với GLM5.3 trên TileRT, AMD MI355X được hỗ trợ đầu tiên. TileRT là một công cụ suy luận LLM độ trễ thấp biên dịch quá trình giải mã thành một nhân (kernel) bền bỉ duy nhất, giảm chi phí khởi chạy và chồng lấp tính toán, truy cập bộ nhớ và giao tiếp.
Nó ưu tiên tạo token nhanh hơn cho mỗi người dùng, thay vì thông lượng theo lô tối đa, trong khi vLLM xử lý prefill.
Trên AgentX, FP8 TileRT MI355X đạt độ tương tác P90 gấp 2 lần so với cấu hình FP4 MI335X tốt nhất. So với GB300 NVL72, nó mang lại mức tăng 40% về độ tương tác. Đây là những chỉ số phục vụ từng yêu cầu phần cứng chuyên dụng.
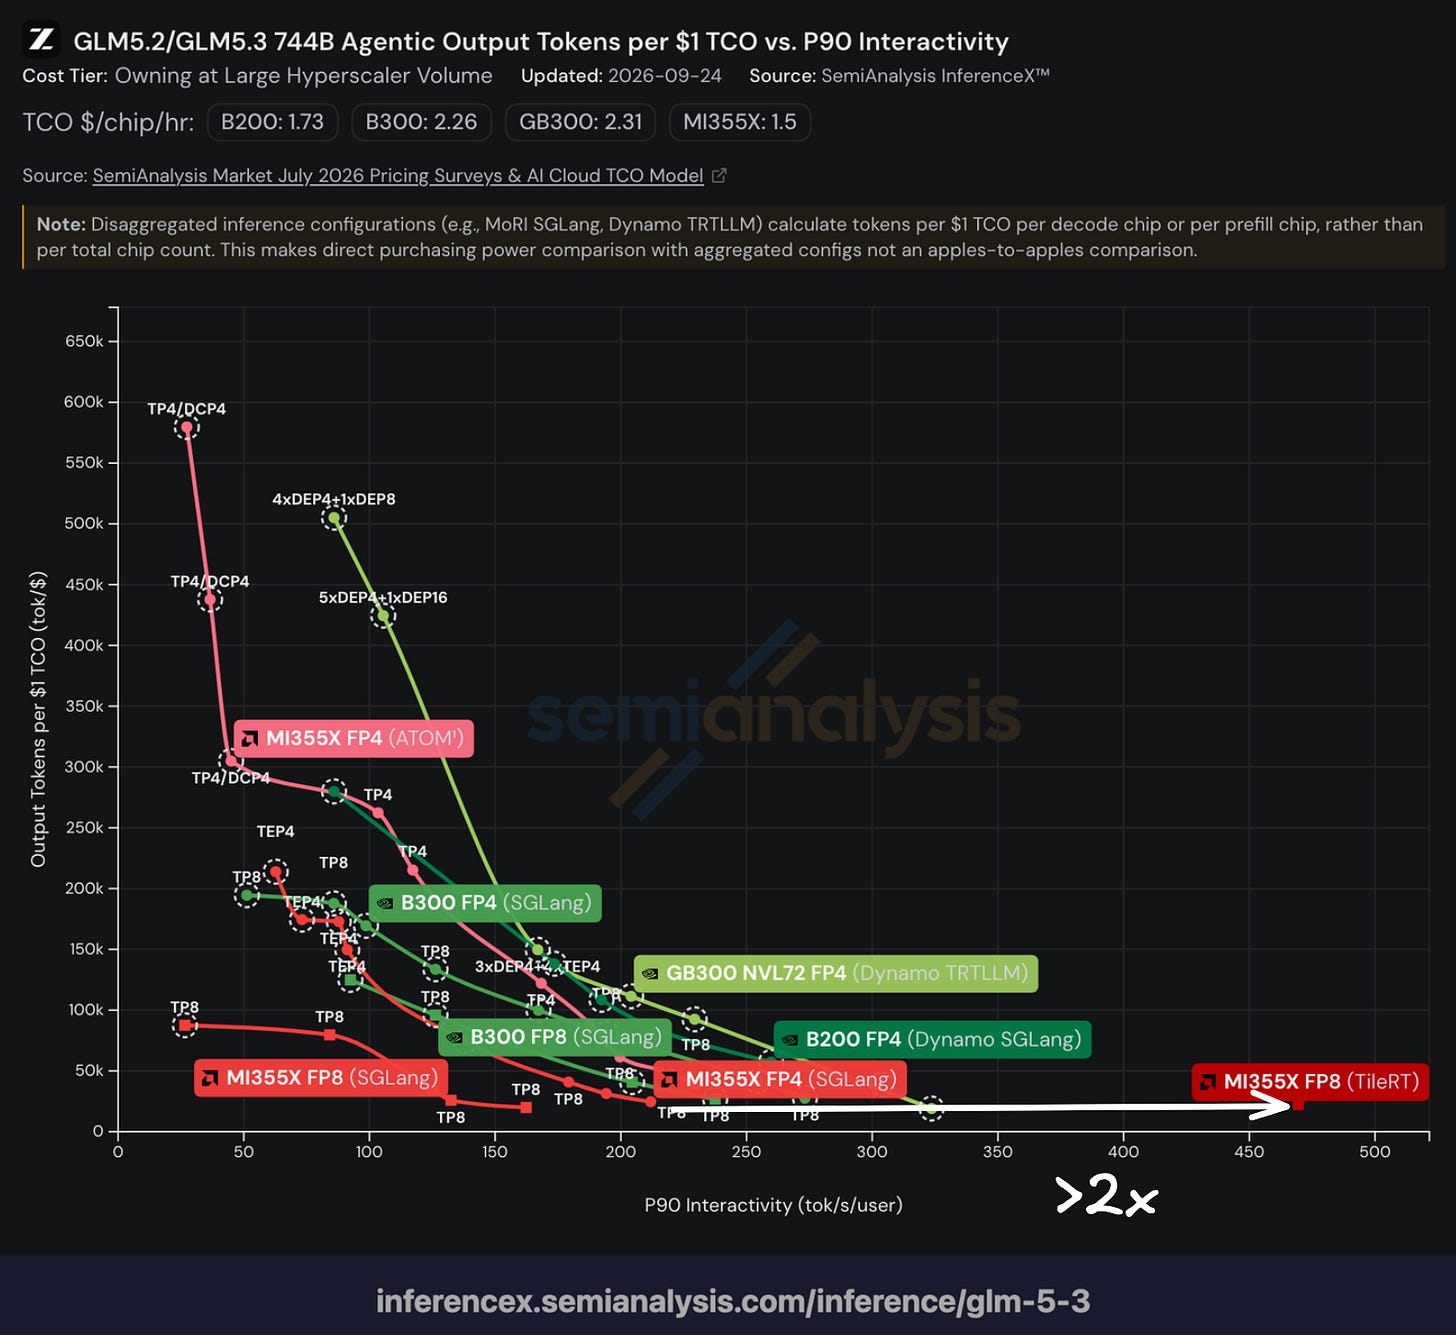
Tuy nhiên, TTFT vẫn chưa tối ưu và vẫn còn dư địa để phát triển, chẳng hạn như tối ưu hóa chuyển đổi KV, hỗ trợ FP4 và kích thước lô lớn hơn.
GLM-5 (và các mô hình GLM-5.x) là một mô hình mixture-of-experts với tổng 744B tham số, 40B tham số hoạt động. Đối với mỗi token, nó có 1 chuyên gia dùng chung và được định tuyến qua 8 trong số 256 chuyên gia, tức là độ thưa thớt (sparsity) là 32. Nó có tính năng DeepSeek Sparse Attention, mà chúng tôi sẽ thảo luận trong phần này.
DeepSeek Sparse Attention (DSA), được giới thiệu trong DeepSeek V3.2, bao gồm hai thành phần: một bộ lập chỉ mục lightning (lightning indexer) chọn top K token, và một cơ chế Multi-Latent Attention (MLA) thưa.
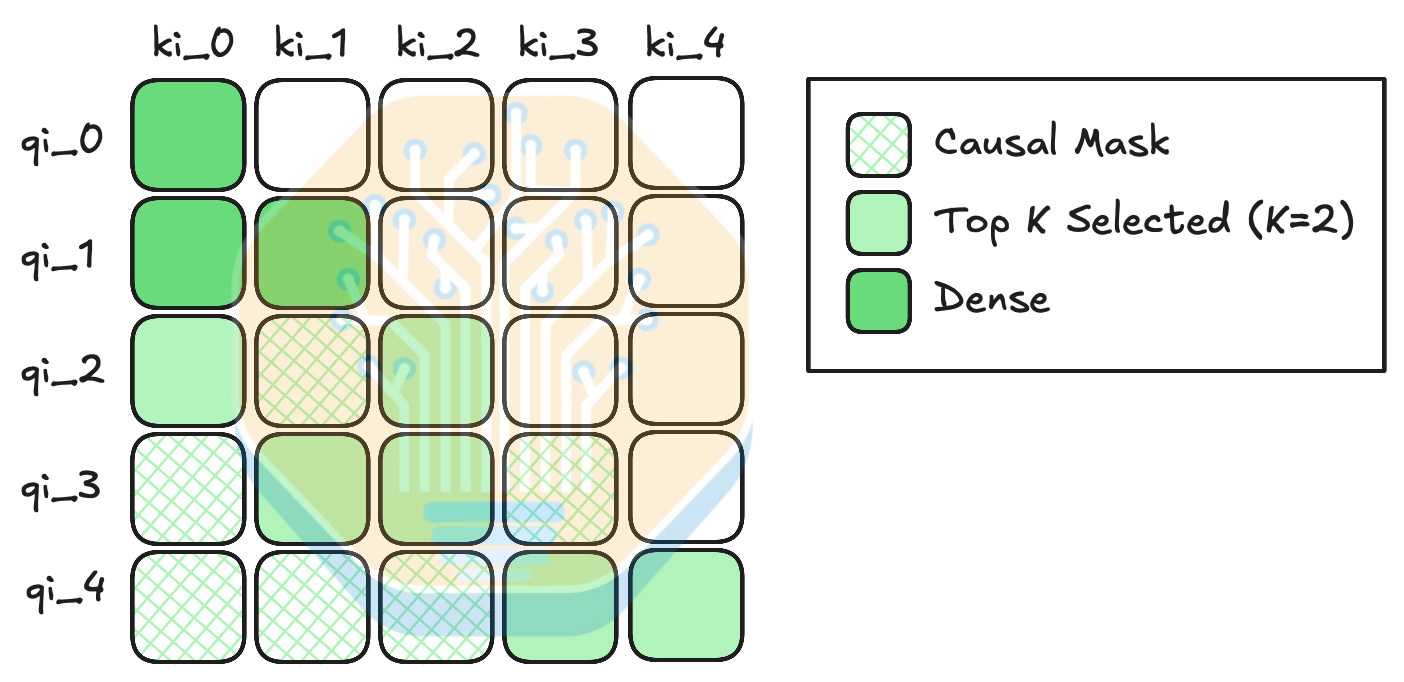
Lightning indexer có chức năng tương tự như một cơ chế attention nhẹ. Các query và key được chiếu xuống chiều thấp hơn, trong đó query của indexer là đa đầu (multi-headed) và key của indexer là đơn đầu (single-headed). Vì chúng ta chỉ cần điểm quan hệ query-key (logits) để chọn top K token, indexer không cần các nhúng giá trị (value embeddings) hay phép toán softmax để chuẩn hóa logits. Thay vào đó, nó tính tích vô hướng query-key, theo sau là hàm phi tuyến ReLU. Sau đó, indexer tính điểm indexer của mỗi token dưới dạng tổng có trọng số của các logit trên tất cả các đầu query, giá trị này được dùng để chọn top K token. Điều này có nghĩa là mặc dù indexer có nhiều đầu, việc chọn token được chia sẻ trên nhiều đầu attention. Khi chọn top K token, chúng ta giữ lại các query chú ý đến ít hơn K token dưới dạng dense attention, và chọn top K trong các trường hợp còn lại.
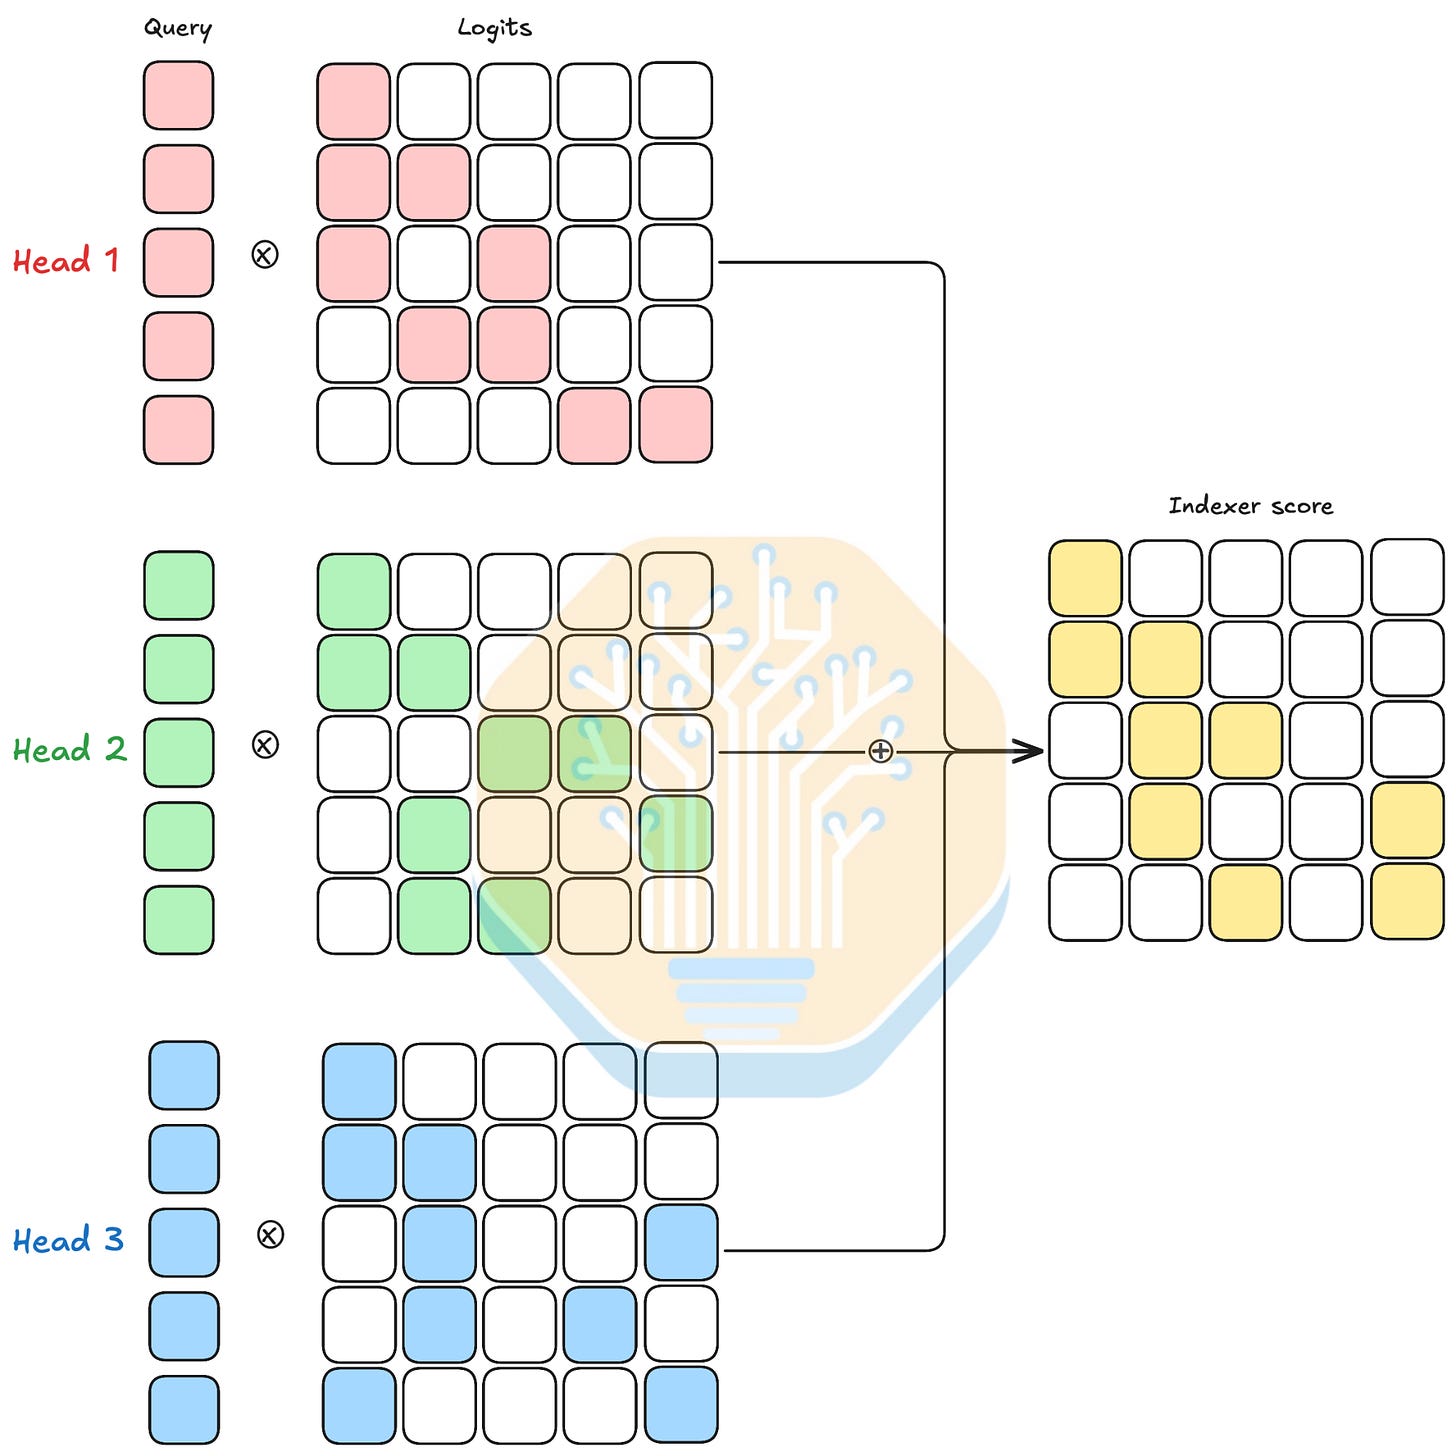
Như chúng tôi đã giải thích trong bài viết về Kimi K3, MLA hoạt động ở hai chế độ: chế độ Multi-Head Attention (MHA) và chế độ Multi-Query Attention (MQA). Cả hai đều có những đánh đổi: chế độ MHA có số FLOP thấp hơn nhưng chi phí bộ nhớ cao gấp 42 lần, chế độ MQA có chi phí bộ nhớ thấp hơn nhưng số FLOP cao gấp 3,4 lần. DSA sử dụng chế độ MQA vì attention thưa chú ý đến ít token hơn, giúp giảm thiểu việc sử dụng FLOP cao. Tuy nhiên, trong thực tế, có một ngưỡng độ dài chuỗi mà dưới đó, chế độ MHA thực sự hiệu quả hơn chế độ MQA. Trực giác là ở độ dài chuỗi ngắn hơn, thời gian tải bộ nhớ không chiếm ưu thế, và chế độ MHA có thể chiếm ưu thế nhờ số FLOP thấp hơn. vLLM triển khai tính năng này và cấu hình chế độ MHA cho độ dài chuỗi từ 2K đến khoảng 5K đối với song song dữ liệu (data parallel), và từ 2K đến khoảng 77K đối với song song tensor (tensor parallel). Mức tối thiểu 2K là do top K bằng 2048, và như đã đề cập ở trên, attention dưới 2K là dense.
So sánh cấu hình chiều MLA của GLM-5 và DeepSeek V3.2, chúng ta thấy những khác biệt đáng chú ý nhất là số lượng đầu query và chiều của đầu query key.
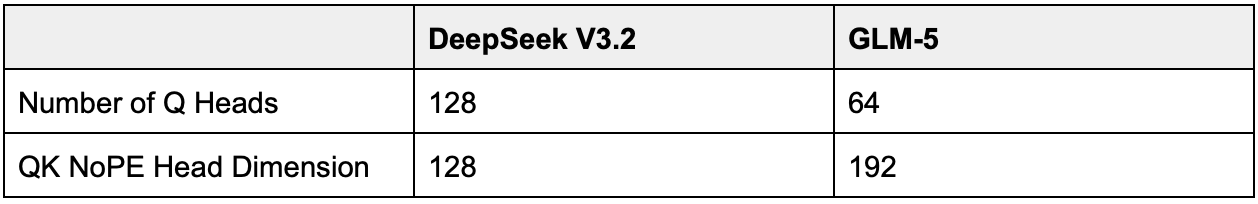
Báo cáo kỹ thuật của GLM-5 đề cập rằng DeepSeek đã chọn số lượng đầu query dựa trên giới hạn hiệu năng (roofline) của H800. Điều này có khả năng ám chỉ thực tế rằng cường độ tính toán SDPA của MLA trong quá trình giải mã (decode) nằm xấp xỉ tại điểm tới hạn (ridge point) của H800. Cách suy luận như sau. Giả sử
- L: Độ dài chuỗi
- d: Chiều của đầu (head dimension)
- r: Chiều của RoPE
- H: Số lượng đầu
- b: Số byte trên mỗi tham số
Trong chế độ MQA, số FLOP là
và bộ nhớ được tải là
Vì vậy, cường độ tính toán là
Nếu chúng ta áp dụng cấu hình của DeepSeek V3.2 (d = 512, r = 64, b = 2), chúng ta có
Cường độ tính toán thực tế của H800 là 258,2 FLOP/B (Đỉnh thực tế 865 TFLOP/s, băng thông 3,35 TB/s, theo DeepSeek), và áp dụng vào công thức, ta có H ~= 128.
Việc GLM-5 có H = 64, bằng một nửa số lượng đầu query, ngụ ý rằng GLM-5 có thể được thiết kế cho phần cứng khác. Nếu chúng ta áp dụng cấu hình của GLM-5 (d = 512, r = 64, b = 2, H = 64), chúng ta có cường độ tính toán là 120,8 FLOP/B. Do đó, chúng tôi nghi ngờ GLM-5 được tối ưu hóa cho Moore Threads MTT S4000, vốn có mức khoảng 128 FLOP/B. Sự hợp tác của Moore Threads với Z.ai, chẳng hạn như hỗ trợ ngày đầu cho GLM-5.3-Flash, đã củng cố giả thuyết của chúng tôi.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ SemiAnalysis bài dài RSS. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.