Mô hình
Black Forest Labs ra mắt FLUX 3 Action: Mô hình hành động thế giới 7B dẫn đầu bảng xếp hạng RoboLab-120
(giờ Việt Nam)
Tóm tắt AI
Black Forest Labs vừa trình làng FLUX 3 Action, mô hình điều khiển robot mã nguồn mở với 7 tỷ tham số. FLUX 3 Action đã xuất sắc chiếm lĩnh vị trí số 1 trên RoboLab-120 với tỷ lệ thành công 42,92%, vượt xa Cosmos 3 Nano về hiệu suất dù sở hữu kích thước nhỏ gọn hơn đáng kể.
Chính văn · Bản dịch AI
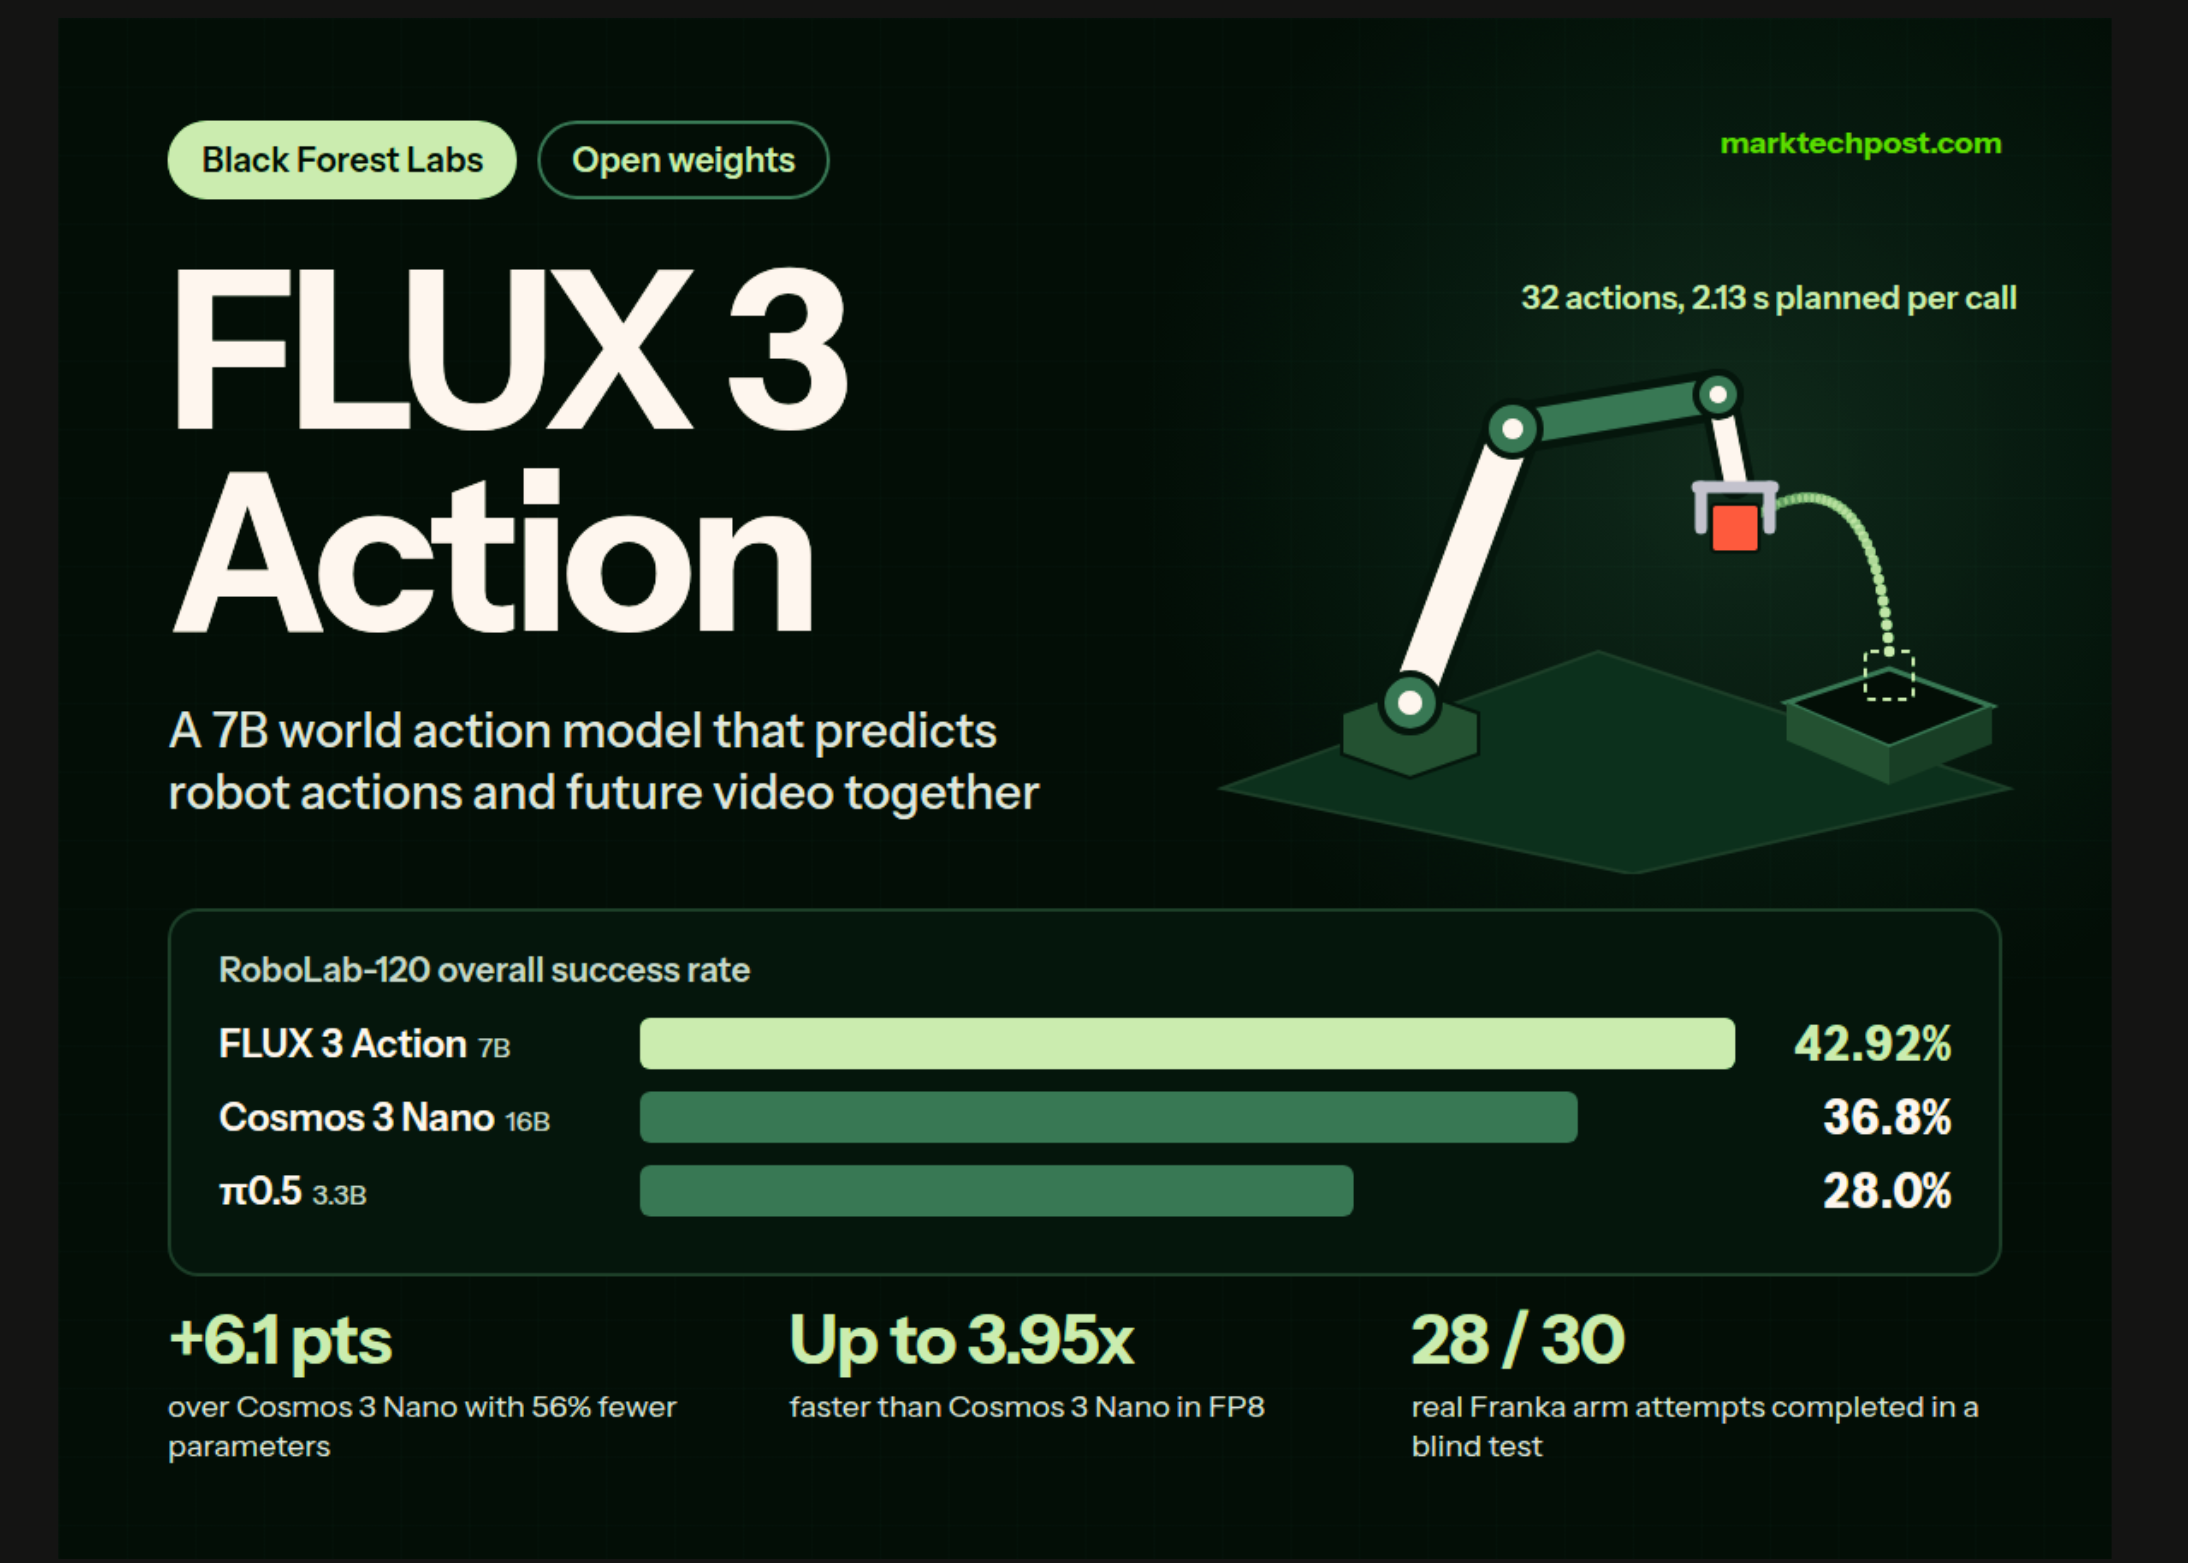
Black Forest Labs (BFL), phòng thí nghiệm đứng sau các mô hình hình ảnh FLUX, vừa phát hành FLUX 3 Action. Đây là World Action Model (WAM) mã nguồn mở 7B dành cho điều khiển robot. Mô hình đọc các khung hình camera, trạng thái robot và chỉ dẫn văn bản, sau đó dự đoán đồng thời các khung hình video tương lai và chuỗi hành động tiếp theo. Trên bảng xếp hạng RoboLab-120, mô hình này đứng đầu với tỷ lệ thành công 42,92%.
Liệu nó có thể triển khai được không? Có, nhưng có điều kiện. Chính sách DROID cần khoảng 32 GB bộ nhớ GPU ở định dạng BF16 trên H200. Nó có thể chạy trên các card 24 GB với kỹ thuật lượng tử hóa FP8 và giảm tải bộ mã hóa văn bản. Giấy phép FLUX Kommunity cho phép sử dụng phi thương mại.
Các mục tiêu đánh đổi của FLUX 3 Action
Các chính sách robot mở thường buộc người dùng phải lựa chọn. Các WAM như Cosmos 3 Nano của NVIDIA dẫn đầu RoboLab với 36,8%, nhưng việc dự đoán video rất tốn kém. Các VLA như π0.5 thì nhanh nhưng chỉ đạt 28,0%. Trên B200, BFL đo lường rằng Cosmos 3 Nano (FP8) cần thời gian xử lý gấp khoảng 4,7 lần so với π0.5 (BF16) cho mỗi giây chuyển động của robot.
FLUX 3 Action duy trì việc dự đoán đồng thời video và hành động. BFL thu hẹp khoảng cách về tốc độ bằng cách sử dụng backbone nhỏ hơn và kỹ thuật chưng cất (distillation).
Kiến trúc và Đào tạo
FLUX 3 Action được phát triển từ backbone đa phương thức FLUX 3. Quá trình tiền huấn luyện sử dụng dữ liệu hình ảnh, video và âm thanh, trong đó video chiếm hơn 95% token huấn luyện. Văn bản, video và trạng thái robot được mã hóa thành các token. Các token tương lai của backbone được giải mã thành khung hình video, và các token hành động được giải mã thành hành động của robot.
Quá trình huấn luyện trung gian kết hợp dữ liệu tiền huấn luyện (36,95% mẫu) với video đã căn chỉnh hành động (63,05%). Dữ liệu hành động bao gồm các bản ghi trò chơi, video góc nhìn thứ nhất của con người, tay gắp cầm tay và điều khiển từ xa trên 14 cấu hình robot khác nhau. Hầu hết dữ liệu robot sử dụng không gian hành động end-effector 50 chiều chung gọi là EE50.
Tiền huấn luyện đóng vai trò rất quan trọng ở đây. Nếu không có nó, việc huấn luyện chỉ với DROID duy trì dưới 1% trên RoboLab. Với tiền huấn luyện, cùng một giao thức đó đã đạt 11,6%.
Kết quả Benchmark
RoboLab-120 có 120 tác vụ trên bàn trong Isaac Sim, với 10 lần thử nghiệm cho mỗi tác vụ trên thiết lập Franka kiểu DROID.
| Mô hình | Loại | Tham số | RoboLab-120 |
|---|---|---|---|
| FLUX 3 Action | WAM | 7B | 42.92% |
| Cosmos3-Nano-Policy | WAM | 16B | 36.8% |
| π0.5 | VLA | 3.3B | 28.0% |
| DreamZero | WAM | 14B | 25.7% |
| GR00T N1.6 | VLA | 3B | 7.2% |
Đó là mức dẫn trước 6,1 điểm phần trăm với số lượng tham số ít hơn 56% so với Cosmos 3 Nano. Con số 42,92% là kết quả trên bảng xếp hạng. Giá trị trung bình đa hạt giống của BFL cho checkpoint FP8 đã chưng cất hướng dẫn là 42,24% ± 0,36.
Kết quả trên phần cứng thực tế cũng theo mô hình tương tự. Positronic Robotics đã thực hiện đánh giá mù trên cánh tay Franka với 10 tác vụ DROID và mỗi tác vụ thử 3 lần. FLUX 3 Action hoàn thành 28 trên 30 lần thử (93,3%). Cosmos 3 Nano đạt 27/30, DreamZero 20/30 và π0.5 13/30.
3 Checkpoint, 3 Mức tốc độ
BFL cung cấp chính sách DROID theo 3 công thức, mỗi công thức đều có định dạng BF16 và FP8:
- Cơ bản: 4 bước lấy mẫu với hướng dẫn phân tách (video CFG 4, hành động CFG 1).
- Đã chưng cất hướng dẫn: loại bỏ bước hướng dẫn thứ hai, chạy nhanh hơn từ 1,8x đến 2x và đạt điểm cao hơn từ 0,6 đến 1,08 điểm phần trăm.
- Đã chưng cất bước: 1 bước lấy mẫu, nhanh hơn từ 3,15x đến 4x, với mức giảm thành công từ 3,51 đến 4,32 điểm phần trăm.
So với Cosmos 3 Nano ở định dạng FP8, các checkpoint cơ bản và đã chưng cất hướng dẫn chạy nhanh hơn từ 1,52x đến 3,95x trên các GPU tiêu dùng, máy trạm và trung tâm dữ liệu.
Mỗi lần gọi tạo ra 32 hành động ở tần số 15 Hz, tương đương 2,13 giây chuyển động. π0.5 tạo ra 1,0 giây mỗi lần gọi. Vì vậy, BFL báo cáo tốc độ dưới dạng hệ số thời gian thực, không phải độ trễ mỗi lần gọi. Ở định dạng FP8, checkpoint đã chưng cất bước vượt qua π0.5 từ 1,34x đến 2,28x trên GPU máy trạm và trung tâm dữ liệu. Trên RTX 5090, nó chậm hơn π0.5.
Kết hợp Chính sách nhanh với Bộ suy luận
BFL cũng đã thử nghiệm điều khiển lai với GPT 6 Astra, theo thiết lập của Su et al. (2026). Bộ suy luận có thể thực thi, chỉnh sửa hoặc thay thế các hành động do chính sách dự đoán. Với FLUX 3 Action và nỗ lực suy luận thấp, hệ thống lai đã giải quyết 90% các tập phim với chi phí $8,77 và 8 phút 08 giây mỗi lần thành công. Astra thuần túy ở mức nỗ lực tối đa giải quyết được 100%, nhưng tốn $13,47 và 16 phút 23 giây mỗi lần thành công.
Tinh chỉnh, LeRobot và Jetson
Các đội ngũ AI có thể tinh chỉnh FLUX 3 Action trên các bản demo của riêng họ. BFL đã xuất bản một công thức DROID và công thức SO-101 LoRA. Tài liệu của họ cho thấy kỹ năng gắp và đặt SO-101 được học từ khoảng 200 bản demo. Cùng với NVIDIA, BFL đã tích hợp mô hình này một cách tự nhiên vào Hugging Face LeRobot, và nó hỗ trợ triển khai biên trên NVIDIA Jetson. Tài liệu cũng bao gồm các ví dụ về chơi game và mô phỏng máy bay không người lái.
from lerobot.policies.flux3 import Flux3Policy
from lerobot.policies.factory import make_pre_post_processors

repo_id = "black-forest-labs/flux-3-action-droid"
policy = Flux3Policy.from_pretrained(repo_id)
preprocessor, postprocessor = make_pre_post_processors(policy.config, pretrained_path=repo_id)
Mô hình xuất ra các mục tiêu khớp mà không có giới hạn tích hợp về vận tốc, lực hoặc không gian làm việc. Ứng dụng của bạn phải thực thi các giới hạn đó.
Những điểm chính
- WAM 7B đứng đầu trên RoboLab-120 với 42,92%.
- Dẫn trước Cosmos 3 Nano 6,1 điểm phần trăm với số tham số ít hơn 56%.
- Nhanh hơn tới 3,95 lần so với Cosmos 3 Nano ở định dạng FP8.
- Lên kế hoạch cho 2,13 giây chuyển động mỗi lần gọi so với 1,0 giây của π0.5.
- Trọng số, mã nguồn và công thức được phát hành theo Giấy phép FLUX Kommunity.
Xem báo cáo kỹ thuật đầy đủ, trọng số mô hình, kho lưu trữ GitHub và tài liệu. Mọi tín dụng thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit ML 150k+ và đăng ký bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá kho lưu trữ GitHub, trang Hugging Face, phát hành sản phẩm hoặc hội thảo trực tuyến của bạn? Kết nối với chúng tôi

Asif Razzaq
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem mỗi tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.