Nghiên cứu
Anthropic dùng Claude tối ưu hóa hơn 30 mô hình sinh học mã nguồn mở, tăng tốc độ gấp 4 lần
(giờ Việt Nam)
Tóm tắt AI
Anthropic công bố nghiên cứu sử dụng Claude để tối ưu hóa hơn 30 mô hình sinh học mã nguồn mở trong chưa đầy 4 tuần, giúp tăng tốc độ xử lý trung bình gấp 4 lần mà vẫn giữ nguyên độ chính xác.
Bản dịch AI
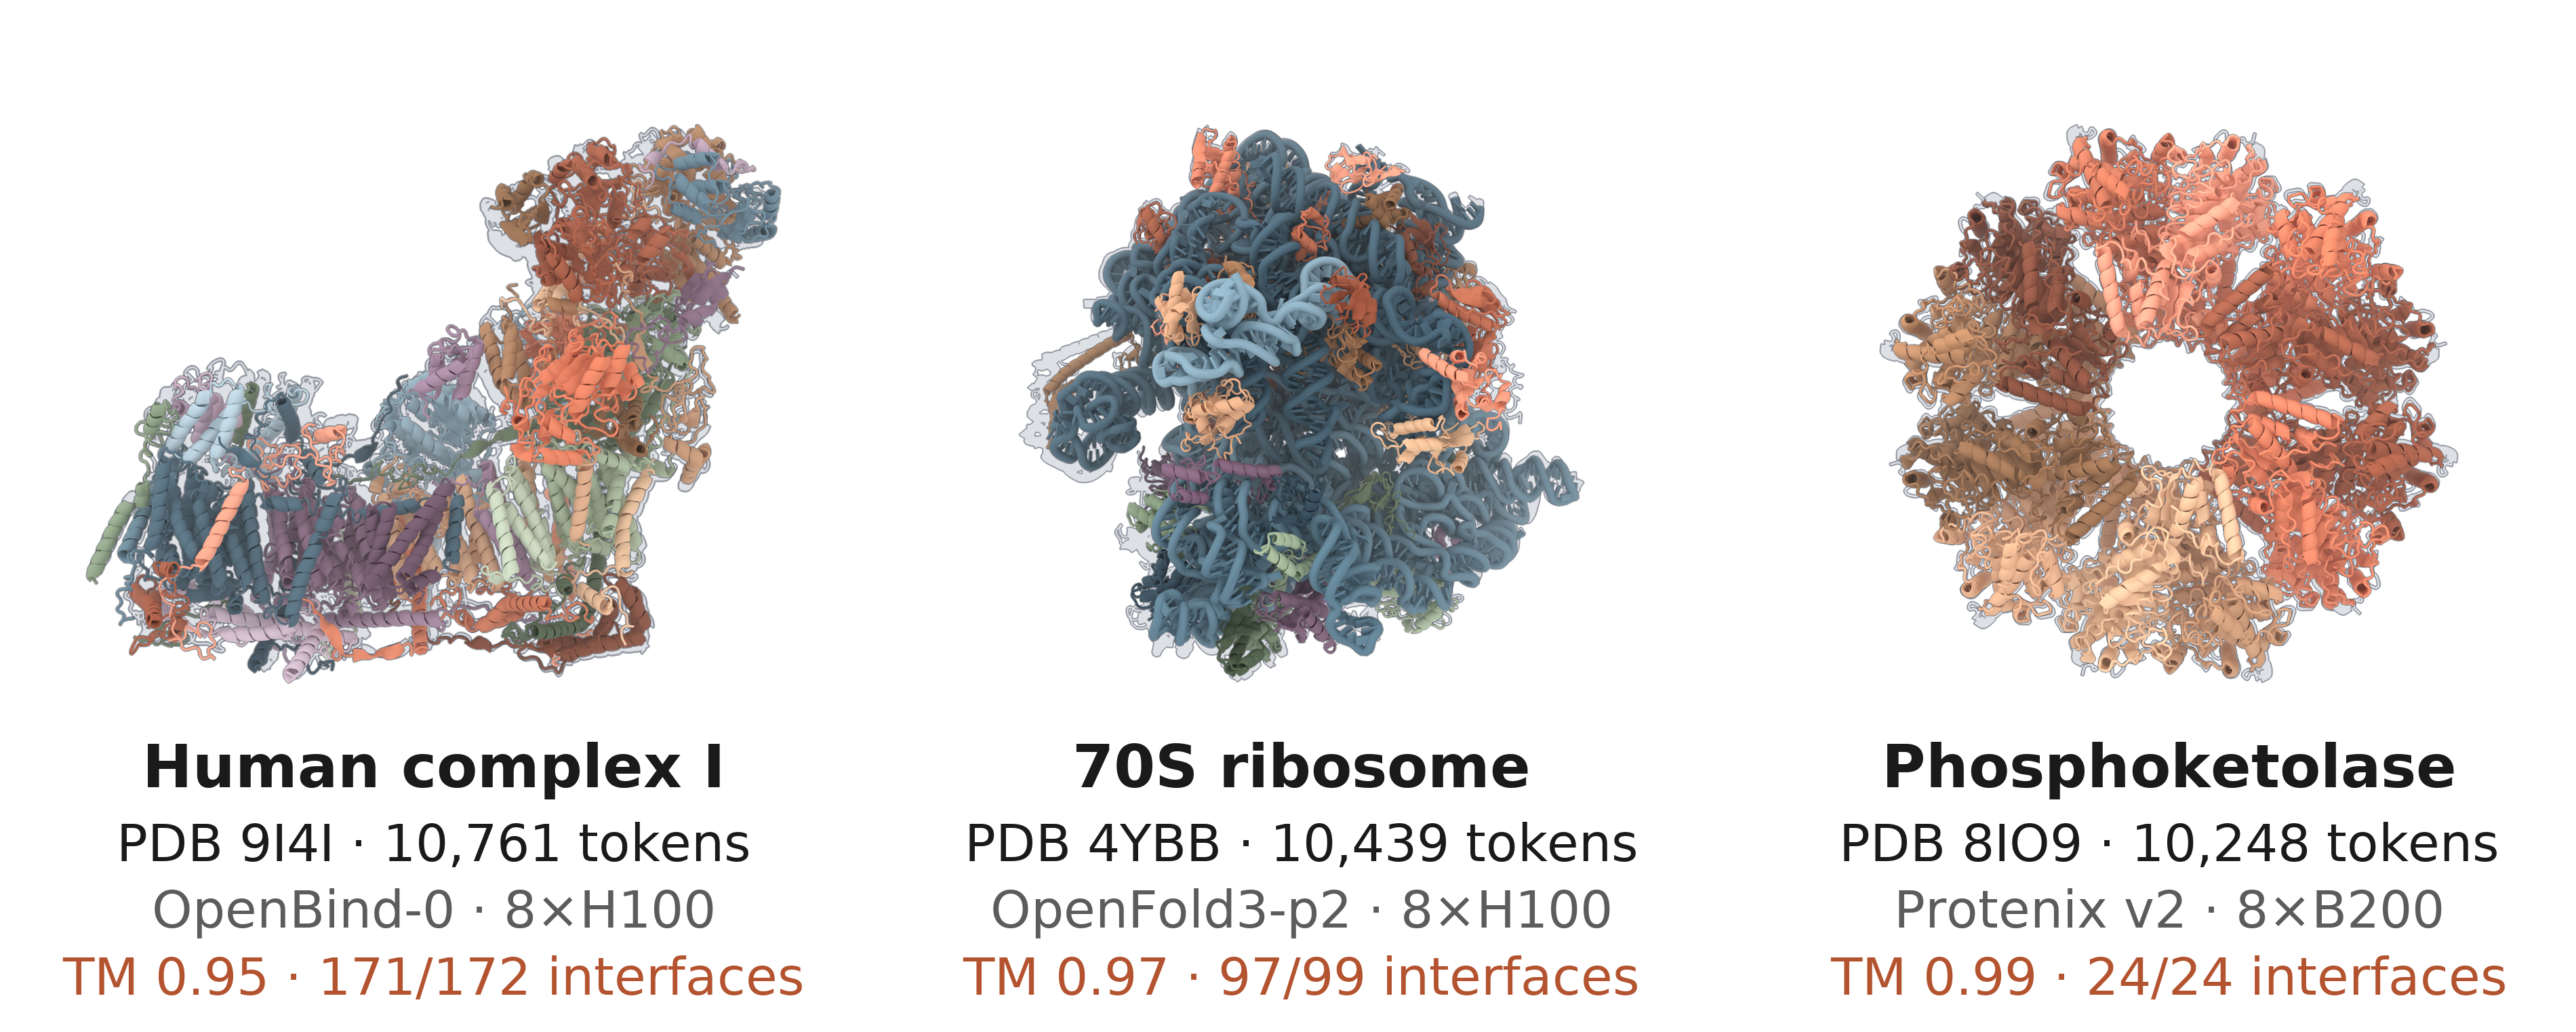
Trong bài viết này, chúng tôi chia sẻ cách Claude đã giúp các mô hình mã nguồn mở mà các nhà khoa học sử dụng để dự đoán và thiết kế các phân tử sinh học trở nên nhanh hơn và tiết kiệm bộ nhớ hơn. Claude đã tối ưu hóa hơn 30 mô hình trong số này chỉ trong chưa đầy bốn tuần, giúp tăng tốc độ xử lý trung bình lên khoảng 4 lần. Nó cũng tạo ra một chế độ tiêu thụ bộ nhớ thấp, cho phép dự đoán chính xác các hệ thống phân tử sinh học lớn hơn 10.000 token (axit amin, nucleotide và các nguyên tử từ các phân tử nhỏ và ion) trên một node GPU NVIDIA duy nhất. Chúng tôi đang mở mã nguồn tất cả các mã đã được tối ưu hóa và công bố một cuộc thi thiết kế protein đồng tài trợ với Adaptyv Bio, với sự hỗ trợ lên tới 1 triệu USD dưới dạng tín dụng Claude và xác thực tại phòng thí nghiệm ướt (wet lab) cho hơn 5.000 thiết kế. Gần đây, chúng tôi đã chia sẻ kết quả chứng minh khả năng của Claude trong việc thiết kế các protein liên kết de novo thông qua việc điều phối ở cấp độ chuyên gia các mô hình thiết kế và dự đoán cấu trúc protein mã nguồn mở. Các protein liên kết de novo là những protein nhỏ được thiết kế bằng máy tính, có khả năng gắn chặt vào một phân tử mục tiêu cụ thể để kích hoạt, ngăn chặn hoặc vận chuyển một thứ gì đó đến mục tiêu đó.
Mặc dù đây là một minh chứng đáng khích lệ về năng lực khoa học của AI và là bước tiến sớm trong việc thúc đẩy khám phá thuốc, nhưng nó tiêu tốn nhiều tài nguyên hơn mức mà đại đa số các nhà thiết kế protein có thể tiếp cận. Chúng tôi đã cho phép Claude chi tiêu tới 10.000 USD cho mỗi mục tiêu trên nền tảng cơ sở hạ tầng AI Modal, tương đương với khoảng 2.500 giờ GPU NVIDIA H100.
Để giúp nghiên cứu này dễ tiếp cận hơn, chúng tôi bắt đầu khám phá các tối ưu hóa suy luận để chạy các mô hình này hiệu quả hơn. Là kết quả ban đầu của những tối ưu hóa này, Claude Mythos 5.1 đã tăng tốc bảy mô hình sinh học mã nguồn mở, cho phép chúng chạy nhanh hơn tới 2,5 lần.
Tại đây, chúng tôi trình bày các kết quả mới cho thấy một mô hình nghiên cứu đa năng nội bộ đã có thể tối ưu hóa hơn 30 mô hình học sâu được huấn luyện cho nhiều tác vụ sinh học khác nhau, chẳng hạn như dự đoán cấu trúc và thiết kế protein, cũng như các mô hình ngôn ngữ protein và hệ gen học. Trung bình, Claude có thể tăng tốc các tác vụ này lên khoảng 4 lần mà chỉ hy sinh một lượng độ chính xác tối thiểu, và gần 2 lần với kết quả đầu ra giống hệt nhau. Claude cũng cải thiện việc sử dụng bộ nhớ của các mô hình này, giúp việc dự đoán các hệ thống phân tử sinh học với kích thước chưa từng có trở nên khả thi. Bằng cách kết hợp các kết quả này với việc đơn giản hóa phương pháp thiết kế protein dựa trên tác nhân (agentic) trước đây của chúng tôi, chúng tôi cho thấy Claude có thể đạt được hiệu suất in silico tương đương với các kết quả mà chúng tôi đã báo cáo trước đó với số giờ GPU ít hơn hai bậc độ lớn.
Ngoài thiết kế protein, các mô hình sinh học chuyên biệt này còn được các nhà sinh học phân tử sử dụng rộng rãi, bao gồm cả trong việc khám phá và phát triển thuốc. Hôm nay, chúng tôi mở mã nguồn cho tất cả các mô hình đã được tối ưu hóa này (tại đây) để cộng đồng rộng lớn hơn có thể sử dụng chúng. Bạn có thể tìm thêm chi tiết trong báo cáo kỹ thuật của chúng tôi (tại đây).
Để hỗ trợ cộng đồng hơn nữa, chúng tôi cũng đồng tài trợ một cuộc thi thiết kế protein với Adaptyv Bio, đơn vị tiên phong trong các cuộc thi thiết kế protein mở. Chúng tôi đã cùng nhau chọn ra năm bài toán đầy thách thức ở ranh giới của các năng lực hiện nay. Cùng với Adaptyv, và nhờ sự đóng góp hào phóng từ Modal và Twist Bioscience, chúng tôi cam kết tài trợ lên tới 1 triệu USD dưới dạng tín dụng Claude và 250.000 USD dưới dạng tín dụng tính toán Modal, cũng như xác thực tại phòng thí nghiệm ướt cho hơn 5.000 thiết kế. Tìm thêm thông tin (tại đây) và (đăng ký tại đây).
Tăng tốc các mô hình dự đoán và thiết kế cấu trúc protein
Dự đoán cấu trúc protein là bài toán xác định cấu trúc ba chiều của một protein chỉ từ trình tự axit amin của nó. Trong khi đó, thiết kế protein là quá trình tạo ra một protein có cấu trúc, chức năng hoặc tập hợp các đặc tính cụ thể. Cùng với nhau, các công cụ tính toán này cho phép các nhà khoa học tìm hiểu các quá trình phân tử sinh học quan trọng, chẳng hạn như cách ung thư hình thành, và tạo ra các phân tử hữu ích, như các loại thuốc có thể nhắm mục tiêu vào các bệnh ung thư này.
Các mô hình dự đoán cấu trúc hiện đại, như AlphaFold3, OpenFold3 và Boltz-2, dành phần lớn thời gian chạy tính toán và bộ nhớ cho hai thao tác: triangle attention (chú ý tam giác) và triangle multiplication (nhân tam giác), hoạt động trên các bộ ba token. Các thao tác này giúp mô hình hóa hình học của các hệ thống phân tử sinh học, nhưng chúng cực kỳ tốn kém về mặt tính toán vì chúng có độ phức tạp bậc ba về cả thời gian chạy và bộ nhớ: tăng gấp đôi kích thước hệ thống sẽ tốn gấp 8 lần thời gian và bộ nhớ, trong khi tăng gấp ba sẽ tốn gấp 27 lần.
Viết các kernel—các lớp chuyển đổi phần mềm cấp thấp cho phần cứng tính toán tăng tốc như GPU—là một phương pháp tiêu chuẩn để giảm các chi phí này. Do tầm quan trọng của chúng, triangle attention và multiplication đã trở thành đối tượng của các nỗ lực phát triển kernel chuyên biệt, đầu tiên là với cuEquivariance của NVIDIA và gần đây hơn là BioNeMo Inference Runtime (BioNeMo-IR) của NVIDIA.
Đối với nỗ lực tối ưu hóa suy luận cho các mô hình dự đoán cấu trúc của riêng mình, chúng tôi đã làm việc với Claude để phát triển FlashPairformer, một tập hợp các kernel tùy chỉnh giúp tăng tốc triangle attention và multiplication. Nó đạt được trạng thái kỹ thuật tiên tiến (state-of-the-art) mới, vượt qua tiêu chuẩn ngành trung bình 2,7-2,9 lần đối với triangle attention và 1,7-3,2 lần đối với triangle multiplication, tùy thuộc vào cấu hình mô hình.
Ngoài việc phát triển các kernel có thể chuyển đổi, chúng tôi đã hướng Claude vào từng mô hình riêng lẻ với mục tiêu tạo ra các tối ưu hóa cụ thể hơn. Những thay đổi này bao gồm việc lưu trữ đệm (caching) các công việc tính toán lại dư thừa và đơn giản hóa các nhánh chết thành các đầu ra hằng số của chúng. Sự kết hợp của những cải tiến này đã tăng tốc các mô hình dự đoán cấu trúc lên trung bình 4 lần, và đối với mỗi mô hình, chúng tôi xác nhận rằng các phiên bản tăng tốc của Claude không ảnh hưởng đến hiệu suất của tác vụ hạ nguồn (như dự đoán cấu trúc).
Thông thường, một đội ngũ kỹ sư giàu kinh nghiệm phải mất nhiều tuần để tạo ra các tối ưu hóa như vậy cho mỗi mô hình, và công việc này thường không thể chuyển đổi giữa các mô hình. Claude, dưới sự giám sát của hai thành viên thuộc đội ngũ kỹ thuật của Anthropic—những người có kinh nghiệm về mô hình hóa phân tử sinh học nhưng không có kinh nghiệm trước đó về tối ưu hóa suy luận hoặc kỹ thuật kernel—đã thực hiện việc tăng tốc hơn 30 mô hình mã nguồn mở trên các lĩnh vực dự đoán cấu trúc phân tử sinh học, thiết kế protein, mô hình hóa ngôn ngữ protein và hệ gen học chỉ trong chưa đầy bốn tuần. Kết quả của chúng tôi cho thấy các mô hình AI tiên phong sẽ giúp những người khác trong lĩnh vực này xây dựng các công cụ khoa học với tốc độ và sự dễ dàng hơn.
Cho phép mô hình hóa các hệ thống phân tử sinh học khổng lồ
Ngoài việc làm cho các mô hình dự đoán và thiết kế cấu trúc protein này nhanh hơn, chúng tôi cũng giao nhiệm vụ cho Claude giảm mức sử dụng bộ nhớ liên quan đến việc mô hình hóa các cỗ máy phân tử lớn. Phần lớn công việc trong tế bào được thực hiện bởi các hệ thống như vậy, bao gồm ribosome xây dựng protein, các phức hợp hô hấp cung cấp năng lượng cho tế bào và các chaperone giúp các protein khác cuộn gập. Mỗi cỗ máy được xây dựng từ hàng chục thành phần, và chức năng của nó phụ thuộc vào cách các thành phần đó khớp nối và tương tác với nhau. Việc dự đoán cấu trúc của các hệ thống lớn như vậy thường đòi hỏi tài nguyên tính toán đáng kể mà hầu hết các nhà sinh học phân tử không thể tiếp cận, chẳng hạn như suy luận trải rộng trên nhiều node GPU.
Claude đã tạo ra một chế độ "Big" tiêu thụ bộ nhớ thấp, cho phép mô hình hóa chính xác các hệ thống lớn hơn 10.000 token và suy luận thành công trên các hệ thống lớn hơn 70.000 token chỉ bằng một node GPU NVIDIA—một tác vụ trước đây nằm ngoài tầm với. Các cỗ máy phân tử được cuộn gập thành công bằng chế độ Big bao gồm phức hợp I ty thể người, phức hợp chaperone TRiC, proteasome và ribosome vi khuẩn, mỗi loại đều khớp chặt chẽ với cấu trúc đã được xác định bằng thực nghiệm. Theo hiểu biết của chúng tôi, đây là những cấu trúc lớn nhất từng được cuộn gập chính xác bằng các mô hình dự đoán cấu trúc, với phức hợp I và ribosome 70S mỗi loại bao gồm hơn 10.000 token, so với ribosome 40S được dự đoán chính xác bởi AlphaFold3, vốn chỉ bao gồm 7.663 token.
Để kiểm tra giới hạn các tối ưu hóa của Claude, chúng tôi đã yêu cầu Claude dự đoán các cấu trúc có kích thước lớn hơn bất kỳ thứ gì đã đạt được trước đây. Sử dụng một node B300 8-GPU duy nhất, Claude đã tạo ra các dự đoán về toàn bộ vỏ virus (viral capsids) và các ngăn protein có kích thước từ hơn 31.000 đến hơn 70.000 token. Các hệ thống này lớn hơn gần hai bậc độ lớn so với ngữ cảnh huấn luyện của các mô hình dự đoán cấu trúc này, và có lẽ không có gì ngạc nhiên khi chúng không được dự đoán chính xác. Tuy nhiên, rào cản đối với việc suy luận ở quy mô này đã được hạ thấp đáng kể khi giờ đây chỉ cần một node NVIDIA B300, cho thấy rằng với các công cụ cải tiến, các nhà nghiên cứu sẽ sớm có thể mô hình hóa bằng máy tính một tập hợp các hệ thống sinh học ngày càng phức tạp.
Claude thiết kế hiệu quả các protein liên kết de novo
Trong công việc trước đây về thiết kế protein, chúng tôi đã cung cấp cho Claude một lời nhắc (prompt) dài khoảng 16.000 từ, khuyến khích nó sử dụng các tác nhân phụ (sub-agents) và chi tiêu tới 10.000 USD cho mỗi mục tiêu trên Modal (khoảng 2.500 giờ GPU NVIDIA H100) trong vòng 24 giờ. Tại đây, chúng tôi đã cho một mô hình Claude duy nhất quyền truy cập vào một NVIDIA H200 và 24 giờ thời gian thực, một lời nhắc khoảng 1.100 từ và một bảng tham chiếu cho các công cụ được cài đặt sẵn, không có tác nhân phụ và không có sự điều khiển của con người đối với các thiết kế.
Chúng tôi đã chạy ba mô hình Claude (Mythos 5.1, Mythos 5 và Opus 5) đối với 16 mục tiêu bằng các mô hình phân tử sinh học đã được tăng tốc được mô tả trong bài viết này. Chúng tôi chấm điểm các thiết kế bằng ipSAE, một điểm số in silico đã được chứng minh là có khả năng dự đoán sự liên kết trong phòng thí nghiệm ướt. Trung bình trên 16 mục tiêu, các thiết kế có điểm trung bình và điểm cao nhất từ cả ba mô hình Claude được đánh giá đều đạt được các giá trị ipSAE xấp xỉ như các chiến dịch Mythos 5.1 trước đây của chúng tôi, mặc dù sử dụng ít hơn khoảng hai bậc độ lớn giờ GPU. Chúng tôi cũng xem xét chi phí token của Claude và nhận thấy rằng với tổng chi tiêu khoảng 150 USD cho GPU và token, chúng tôi có thể đạt được hiệu suất in silico tương đương với các cấp độ của các chiến dịch trước đây.
Đồng tài trợ một cuộc thi thiết kế protein với Adaptyv Bio
Các tối ưu hóa được mô tả ở trên giúp chúng tôi dự đoán và thiết kế các phân tử hiệu quả hơn, đồng thời mở ra các khả năng mà trước đây sẽ bị hạn chế do chi phí tài nguyên. Để chứng minh sự nâng cấp mà chúng mang lại và tác động của Claude đối với việc thiết kế phân tử nói chung, chúng tôi đang hợp tác với Adaptyv Bio để khởi động một cuộc thi thiết kế protein. Chúng tôi đã chọn ra năm bài toán ở ranh giới của các năng lực thiết kế protein hiện nay, bao gồm các thách thức như phản ứng chéo giữa các loài, độ nhạy pH và tính đặc hiệu peptide-MHC, cũng như các mục tiêu khó như GPCR.
Cùng với đội ngũ Adaptyv, chúng tôi sẽ xác thực bằng thực nghiệm hơn 5.000 thiết kế do cộng đồng gửi đến đối với các bài toán này. Chúng tôi sẽ cung cấp lên tới 1 triệu USD dưới dạng tín dụng Claude và các khoản tài trợ bổ sung cho việc xác thực thực nghiệm tại Adaptyv cho các nhà nghiên cứu tham gia, Modal sẽ cung cấp lên tới 250.000 USD dưới dạng tín dụng tính toán, và Twist Bioscience sẽ cung cấp DNA cho cuộc thi. Bạn có thể tìm thêm thông tin, bao gồm các tiêu chí đủ điều kiện (tại đây) và (đăng ký tại đây).
Chúng tôi cũng đã bắt đầu cung cấp các năng lực AI tiên phong cho các nhà khoa học sự sống cho công việc liên quan đến sinh học thông qua Chương trình Xác minh Khoa học Sự sống (Life Sciences Verification Program) của chúng tôi. Gần đây, chúng tôi đã ghi danh nhóm tổ chức đầu tiên và mở chương trình dưới dạng beta công khai ngay hôm nay. Bạn có thể tìm thêm thông tin (tại đây).
Đọc thêm
Các tài nguyên sau đây cung cấp chiều sâu kỹ thuật hơn và thông tin chi tiết hơn về các kết quả được mô tả ở trên:
Nội dung liên quan
Đo lường năng lực nhắm mục tiêu tình báo chiến thuật và vũ khí thông thường của các mô hình AI
Đội ngũ Red Team tiên phong của Anthropic đã phát triển các đánh giá mới để đo lường năng lực AI trong việc nhắm mục tiêu tình báo chiến thuật và phát triển vũ khí thông thường.
Đọc thêm
Đánh giá sự liên kết của các sự cố an ninh mạng gần đây
Chúng tôi trình bày đánh giá sự liên kết của bốn sự cố trong đó các mô hình Claude đã truy cập trái phép vào các hệ thống thực của bên thứ ba.
Đọc thêm
Chính thức hóa Định lý cuối cùng của Fermat
Chúng tôi chia sẻ bằng chứng hoàn chỉnh đầu tiên được máy tính kiểm chứng về Định lý cuối cùng của Fermat. Claude đã làm việc phần lớn một cách tự chủ trong 11 ngày để viết bằng chứng bằng ngôn ngữ lập trình Lean.
Đọc thêm
Bài viết được AI dịch và tổng hợp tự động từ Anthropic: Research ( - Web). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.