Tin ngành
Ứng dụng LangSmith trong AI y tế: Xây dựng lớp bảo mật và độ tin cậy
(giờ Việt Nam)
Tóm tắt AI
LangSmith giúp các đội ngũ phát triển AI y tế chuyển đổi quy trình đánh giá lâm sàng thành các bộ dữ liệu và tiêu chuẩn kiểm định, đảm bảo hệ thống vận hành an toàn trong môi trường thực tế.
Bản dịch AI
Trong lĩnh vực chăm sóc sức khỏe, những người đánh giá tốt nhất về việc liệu một hệ thống AI có hoạt động chính xác hay không chính là những người mà hệ thống đó được xây dựng để hỗ trợ. Một bác sĩ lâm sàng có thể nhanh chóng nhận biết liệu một ghi chú được tạo ra có quy kết triệu chứng đúng hay không, hoặc liệu bệnh nhân có được đề xuất mức độ chăm sóc phù hợp nhất hay không. Tuy nhiên, họ không thể thực hiện việc đánh giá này trên hàng ngàn cuộc thăm khám một cách liên tục. Ở quy mô lớn, sự xác nhận của chuyên gia trở thành yếu tố hạn chế.
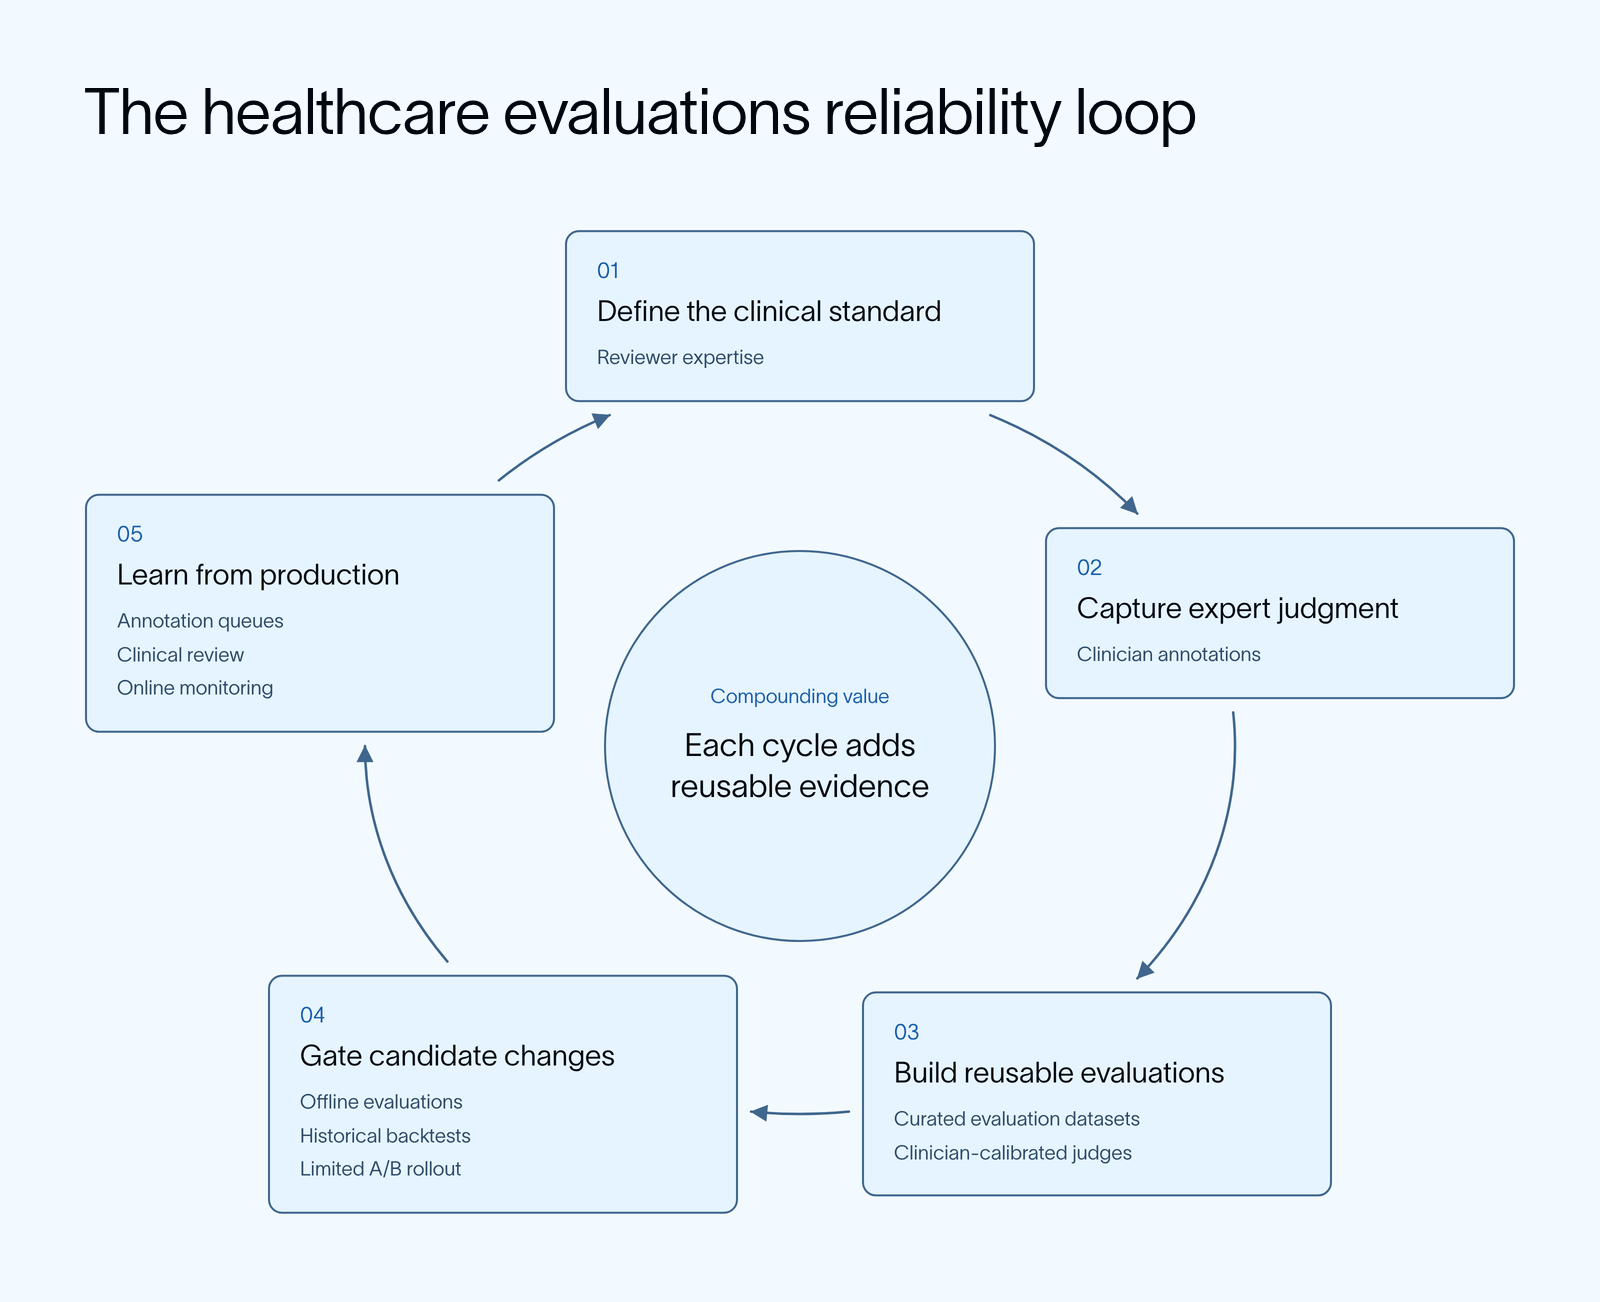
Các đội ngũ y tế đã tiếp cận thách thức này theo nhiều cách khác nhau, nhưng nhiều người có chung một nguyên tắc: họ coi việc đánh giá lâm sàng là cơ sở hạ tầng thay vì một chi phí vận hành định kỳ. Bài viết này đề cập đến cách hai tổ chức, dù xây dựng các sản phẩm AI y tế theo những hướng khác nhau, lại cùng hội tụ về các phương pháp đánh giá. Sử dụng LangSmith, họ chuyển đổi ý kiến chuyên gia thành các tài sản bền vững như tập dữ liệu được gán nhãn, các bộ đánh giá đã hiệu chuẩn và các cổng kiểm soát phát hành tự động. Mục tiêu không phải là loại bỏ sự phán đoán của con người, mà là làm cho giá trị của nó được nhân lên.
Bạn sẽ khám phá:
Những thách thức trong việc đánh giá AI trong chăm sóc sức khỏe
Các tác nhân (agent) AI trong y tế hoạt động trên nhiều quy trình công việc khác nhau, chẳng hạn như các quyết định chăm sóc bệnh nhân và ghi chép hồ sơ thăm khám.
Included Health đã xây dựng Dot, một trợ lý AI được vận hành bởi LangGraph và Deep Agents. Nó diễn giải các nhu cầu mơ hồ của thành viên, trả lời các câu hỏi về bảo hiểm và thanh toán, điều hướng mọi người đến dịch vụ chăm sóc phù hợp và phát hiện các tình huống khẩn cấp. Một câu hỏi về việc liệu một lần chụp chiếu có được bảo hiểm chi trả hay không có thể tiết lộ, sau vài lượt trao đổi, rằng thành viên đó thực sự cần nói chuyện với bác sĩ chăm sóc ban đầu. Đánh giá Dot nghĩa là vừa kiểm tra độ chính xác của nó, vừa kiểm tra xem nó có sử dụng toàn bộ ngữ cảnh của thành viên để đề xuất bước tiếp theo an toàn và phù hợp hay không.
Abridge chuyển đổi các cuộc hội thoại giữa bệnh nhân và bác sĩ thành các ghi chú lâm sàng. Với sự đồng ý của bệnh nhân, bác sĩ ghi âm lại buổi thăm khám và Abridge chuyển đổi cuộc hội thoại đó thành một ghi chú, trở thành một phần của hồ sơ sức khỏe theo thời gian và hỗ trợ việc thanh toán. Trong bối cảnh này, việc quy kết là rất quan trọng. Nếu quan sát của bệnh nhân bị trình bày thành kết luận của bác sĩ, một triệu chứng có thể trở thành một chẩn đoán cần thanh toán. Hiện tượng "ảo giác" (hallucination) tạo ra một rủi ro khác: một loại thuốc hoặc liều lượng chưa bao giờ được kê đơn có thể lọt vào hồ sơ. Một ghi chú đáng tin cậy phải bảo toàn được ai đã nói gì, nắm bắt được những gì quan trọng về mặt lâm sàng và không đưa vào bất cứ điều gì mà cuộc hội thoại không hỗ trợ.
Các hệ thống này thất bại theo những cách khác nhau, nhưng cả hai đội ngũ đều sử dụng LangSmith để giải quyết cùng một hạn chế: độ chính xác được xác định bởi một người bên ngoài đội ngũ kỹ thuật, và thời gian của người đó thường là nguồn lực khan hiếm nhất trong hệ thống.
Điều đó khiến việc đánh giá của chuyên gia vừa không thể thiếu, vừa là một nút thắt tiềm ẩn. Như đội ngũ Abridge đã nói: "niềm tin được tích lũy từng giọt nhưng mất đi từng xô". Mục tiêu là làm cho mỗi phán đoán của chuyên gia có thể tái sử dụng cho các bài kiểm tra, bản phát hành và các lần lặp lại trong tương lai.
Những khoảng trống mà đánh giá lâm sàng phải khỏa lấp
Trước khi phán đoán lâm sàng được mã hóa thành các đánh giá tự động, các đội ngũ trước tiên phải xác định chính xác những gì các chuyên gia đang đánh giá. Ba đặc điểm khiến cho việc mở rộng quy mô phán đoán này trở nên khó khăn.
Sự thật cơ sở (ground truth) hiếm khi là duy nhất. Một ghi chú lâm sàng không có một hình thức chuẩn mực duy nhất. Những gì cần có sẽ thay đổi tùy theo chuyên khoa, cuộc thăm khám và bác sĩ lâm sàng, và các chuyên gia hợp lý có thể có những ý kiến khác nhau. Các ghi chú tham chiếu rất hữu ích, nhưng việc coi một tham chiếu duy nhất là câu trả lời đúng duy nhất có thể gây bất lợi cho những biến thể hợp lệ, trong khi vẫn bỏ sót các lỗi quan trọng về mặt lâm sàng.
Việc không hành động đúng cũng quan trọng. Các đội ngũ y tế phải đánh giá liệu một hệ thống đã hành động đúng hay chưa và liệu nó có nhận ra khi nào không nên hành động hay không. Ví dụ, các chuyên gia đánh giá của Included Health kiểm tra xem các rào cản khẩn cấp có kích hoạt khi thích hợp và vẫn không hoạt động trong các trường hợp lành tính hay không. Ví dụ, Abridge kiểm tra xem tác nhân của nó có nằm trong giới hạn và chọn các công cụ mà bác sĩ lâm sàng mong đợi hay không.
Chuyên môn của người đánh giá là một phần của đặc tả kỹ thuật. Abridge xác định trước liệu một đánh giá có yêu cầu bác sĩ được cấp chứng chỉ hành nghề hay một chuyên gia cụ thể nào đó hay không. Một người đánh giá chỉ tốt khi những phán đoán hiệu chuẩn cho nó tốt.
Không điều nào trong số này khiến cho việc tự động hóa phán đoán lâm sàng trở nên bất khả thi. Nó chỉ đơn giản là xác định các yêu cầu để thực hiện điều đó một cách có trách nhiệm: sự khoan dung cho các biến thể hợp lệ, sự chú ý đến những gì đã không xảy ra và chuyên môn phù hợp đằng sau mỗi nhãn dán.
Chuyển đổi chuyên môn lâm sàng thành các tài sản bền vững
Khi các đội ngũ đã xác định được phán đoán mà họ cần bảo tồn, họ có thể bắt đầu chuyển đổi chuyên môn thành cơ sở hạ tầng. Abridge chuyển đổi ý kiến của bác sĩ lâm sàng thành các tập dữ liệu được gán nhãn và các bộ đánh giá đã hiệu chuẩn, những thứ vẫn tiếp tục hoạt động sau khi một đánh giá cá nhân kết thúc.
Abridge bắt đầu với các chế độ lỗi đã biết từ phản hồi của bác sĩ lâm sàng và người dùng. Đội ngũ xếp hạng chúng theo mức độ phổ biến và nghiêm trọng, nhóm chúng thành các danh mục như độ chính xác, tuân thủ, phong cách và tính đầy đủ, và xây dựng một bộ đánh giá riêng cho từng danh mục. Thay vì tạo ra một điểm chất lượng chung, các bộ đánh giá sẽ kiểm tra các cách cụ thể mà một ghi chú có thể bị lỗi.
Việc tiết kiệm thời gian đến từ việc tự động hóa những gì xảy ra sau khi họ đã đưa ra phán đoán của mình. Trước đây, một bác sĩ lâm sàng viết hướng dẫn chú thích và gán nhãn các cuộc thăm khám, sau đó ai đó điều chỉnh thủ công lời nhắc (prompt) của bộ đánh giá cho đến khi điểm số của nó khớp với các nhãn đó. Giờ đây, Abridge đưa cùng một hướng dẫn và ví dụ đó vào một khung tối ưu hóa lời nhắc tự động để tạo ra bộ đánh giá.
Vì không có tham chiếu đơn lẻ nào có thể nắm bắt mọi ghi chú hợp lệ, Abridge kết hợp hai phương pháp với những thế mạnh bổ sung cho nhau:
Cùng với nhau, chúng cân bằng giữa phạm vi bao phủ và độ chính xác: một phương pháp cung cấp khả năng bao phủ có thể mở rộng trên các cuộc thăm khám, trong khi phương pháp kia nắm bắt được sắc thái chuyên môn cụ thể mà đánh giá lâm sàng yêu cầu.
Một bộ đánh giá đã được tối ưu hóa vẫn phải được xác thực dựa trên các chú thích của bác sĩ lâm sàng. Align Evaluator của LangSmith cung cấp cho các đội ngũ một giao diện để so sánh hai bên và điều tra những điểm bất đồng. Abridge yêu cầu các chuyên gia chú thích giải thích các quyết định của họ, ngay cả khi kết quả đầu ra là chính xác. Những giải thích đó giúp giải quyết các mâu thuẫn và xác nhận rằng các nhãn phản ánh sự đánh giá cẩn thận.
Kết quả là một hệ thống đánh giá có thể được kiểm tra, hiệu chuẩn lại và tái sử dụng. Bằng cách biến các phán đoán cá nhân thành các bộ đánh giá bền vững, các đội ngũ dành riêng chuyên môn lâm sàng khan hiếm cho những trường hợp mang lại giá trị cao nhất. Việc đánh giá trong quá trình vận hành (production review) cung cấp các trường hợp mới và phản hồi để giữ cho các tiêu chuẩn đó luôn cập nhật.
Khép kín vòng lặp đánh giá với việc đánh giá trong quá trình vận hành
Các bộ đánh giá đã hiệu chuẩn áp dụng phán đoán mà đội ngũ đã thu thập được. Việc đánh giá trong quá trình vận hành cung cấp vòng lặp tiếp theo của phán đoán đó, tiết lộ cách hệ thống hoạt động trong các cuộc hội thoại thực tế và tạo ra bằng chứng cho những gì cần sửa chữa.
Included Health cho thấy cách bằng chứng mới đó đi vào vòng lặp. Các cuộc hội thoại đi vào hàng đợi chú thích của LangSmith, nơi các chuyên gia đánh giá lâm sàng kiểm tra xem Dot có hướng dẫn thành viên đến đúng cơ sở chăm sóc hay không, liệu các rào cản khẩn cấp của nó có hoạt động phù hợp hay không và liệu trường hợp đó có cần theo dõi thêm hay không.
Những quyết định đó trở thành các nhãn có cấu trúc được xuất sang kho dữ liệu của Included Health, nơi đội ngũ khoa học dữ liệu sử dụng chúng để xây dựng các bảng điều khiển vận hành. Chúng cũng phản hồi lại các định nghĩa kỹ năng điều khiển cách Dot điều hướng các thành viên. Mỗi đánh giá được thực hiện một lần và sử dụng ba lần.
Kết quả là một vòng lặp phản hồi mạnh mẽ. Phán đoán lâm sàng trở thành dữ liệu, dữ liệu hướng dẫn các thay đổi sản phẩm và những thay đổi đó được kiểm tra dựa trên cùng các tiêu chuẩn trước khi phát hành bản tiếp theo. Mỗi đánh giá đều đóng góp cho cả trường hợp hiện tại và hành vi tương lai của hệ thống.
Biến đánh giá thành cổng kiểm soát phát hành
Vòng lặp phản hồi mang lại hiệu quả vào thời điểm phát hành. Thay vì đánh giá mọi thay đổi ứng viên từ đầu, các đội ngũ có thể kiểm tra nó dựa trên bằng chứng mà họ đã thu thập được.
Tại Abridge, một thay đổi mô hình sẽ trải qua các giai đoạn thực tế dần dần: đánh giá ngoại tuyến (offline), kiểm tra ngược (backtesting) dựa trên các cuộc thăm khám lịch sử, thử nghiệm A/B giới hạn, phát hành đầy đủ và giám sát vận hành liên tục. Mỗi giai đoạn bổ sung một loại bằng chứng khác nhau.
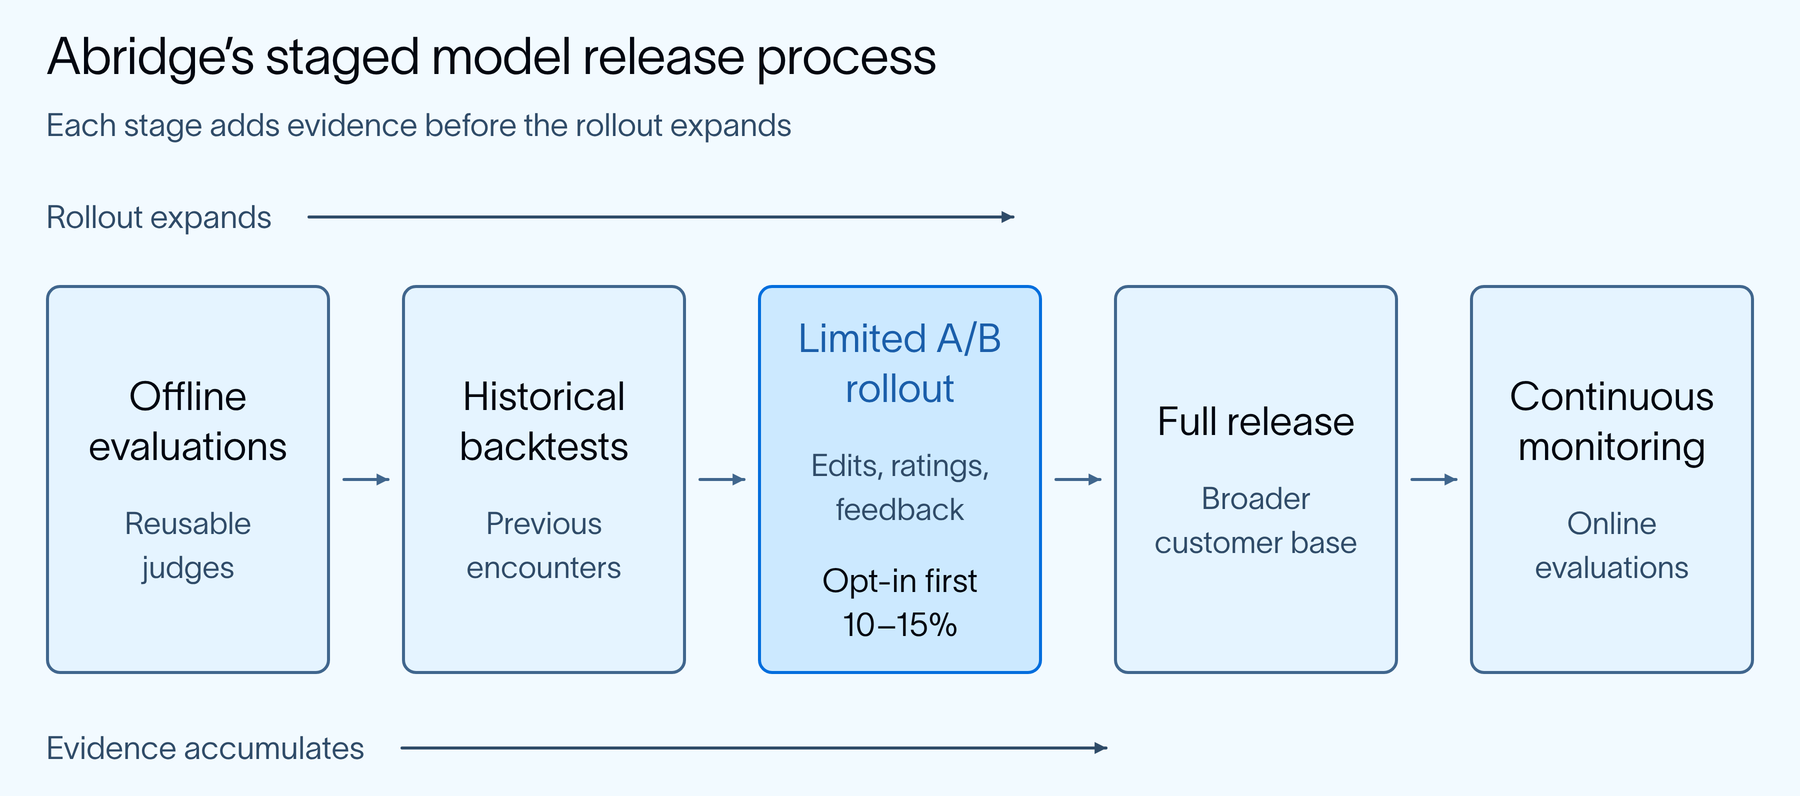
Thử nghiệm A/B là bước khác biệt nhất trong quy trình này. Một số đối tác của Abridge đồng ý trở thành 10 đến 15% khách hàng đầu tiên được đưa vào đợt triển khai âm thầm. Điều này cho phép Abridge quan sát các tín hiệu mà các bộ đánh giá tự động không thể cung cấp: liệu các bác sĩ lâm sàng có chỉnh sửa các ghi chú được tạo ra hay không, họ đánh giá chúng như thế nào và họ chia sẻ phản hồi định tính gì. Các đánh giá ngoại tuyến xác định xem một thay đổi đã sẵn sàng cho việc tiếp xúc hạn chế hay chưa; hành vi trong quá trình vận hành xác định xem việc triển khai có nên mở rộng hay không. Quy trình đó đã giảm chu kỳ phát hành của Abridge từ một hoặc hai tháng xuống còn vài ngày.
Included Health đã áp dụng nguyên tắc tương tự cho một thay đổi về kiến trúc. Việc chuyển siêu đồ thị (supergraph) của Dot sang Deep Agents đã ảnh hưởng đến bốn đội ngũ sản phẩm, tất cả đều lo ngại về các thay đổi gây lỗi. Đội ngũ đã chạy bộ mô phỏng đa lượt hiện có, xác nhận rằng hiệu suất vẫn ổn định và hoàn thành việc di chuyển trong vòng chưa đầy hai tuần mà không có sự hồi quy đáng kể nào.
Trong cả hai trường hợp, sự tự tin khi phát hành trở nên tích lũy. Thay vì phải xây dựng lại niềm tin với mỗi thay đổi, các đội ngũ có thể dựa trên bằng chứng mà họ đã thu thập được.
Đo lường độ tin cậy trong quá trình vận hành
Một chu kỳ phát hành nhanh hơn chỉ quan trọng nếu hệ thống hoạt động đáng tin cậy khi đến tay người dùng thực tế. Included Health đo lường hiệu suất trên ba khía cạnh: mức độ chấp nhận, chất lượng điều hướng và độ an toàn.
Mỗi chỉ số trả lời một câu hỏi khác nhau: Thành viên có sử dụng sản phẩm không? Nó có hướng dẫn họ đến dịch vụ chăm sóc phù hợp không? Nó có nhận ra các tình huống cần sự chú ý khẩn cấp không? Nhìn vào chúng cùng nhau mang lại cho đội ngũ một bức tranh hoàn chỉnh hơn về độ tin cậy trong quá trình vận hành.
Bài viết được AI dịch và tổng hợp tự động từ LangChain: Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.