Sản phẩm
Databricks ra mắt Lakebase Search: Tìm kiếm vector và toàn văn bản cho Postgres
(giờ Việt Nam)
Tóm tắt AI
Databricks giới thiệu Lakebase Search, tích hợp các tiện ích mở rộng lakebase_vector và lakebase_text vào Lakebase Postgres, hỗ trợ tìm kiếm vector và toàn văn bản hiệu quả trên AWS và Azure.
Chính văn · Bản dịch AI
Các hệ thống OLTP truyền thống không được xây dựng để đáp ứng nhu cầu tìm kiếm của các AI agent. Chúng đòi hỏi khả năng truy xuất dữ liệu với độ trễ thấp, độ chính xác cao trên toàn bộ dữ liệu của bạn và thường thực hiện các tìm kiếm song song quy mô lớn. Cho đến nay, để giải quyết vấn đề này, người ta phải "chắp vá" một công cụ tìm kiếm độc lập vào cơ sở dữ liệu chính thông qua đường ống ETL.
Nhưng nếu cơ sở dữ liệu OLTP của bạn có thể tự chạy khối lượng công việc tìm kiếm một cách hiệu quả thì sao?
Hôm nay, chúng tôi mang đến một công cụ tìm kiếm nhanh và có khả năng mở rộng cho Lakebase Postgres thông qua hai tiện ích mở rộng: lakebase_vector (tìm kiếm lân cận xấp xỉ có khả năng mở rộng) và lakebase_text (tìm kiếm toàn văn bản bm25). Cả hai tiện ích này đều đã khả dụng trên AWS và Azure.
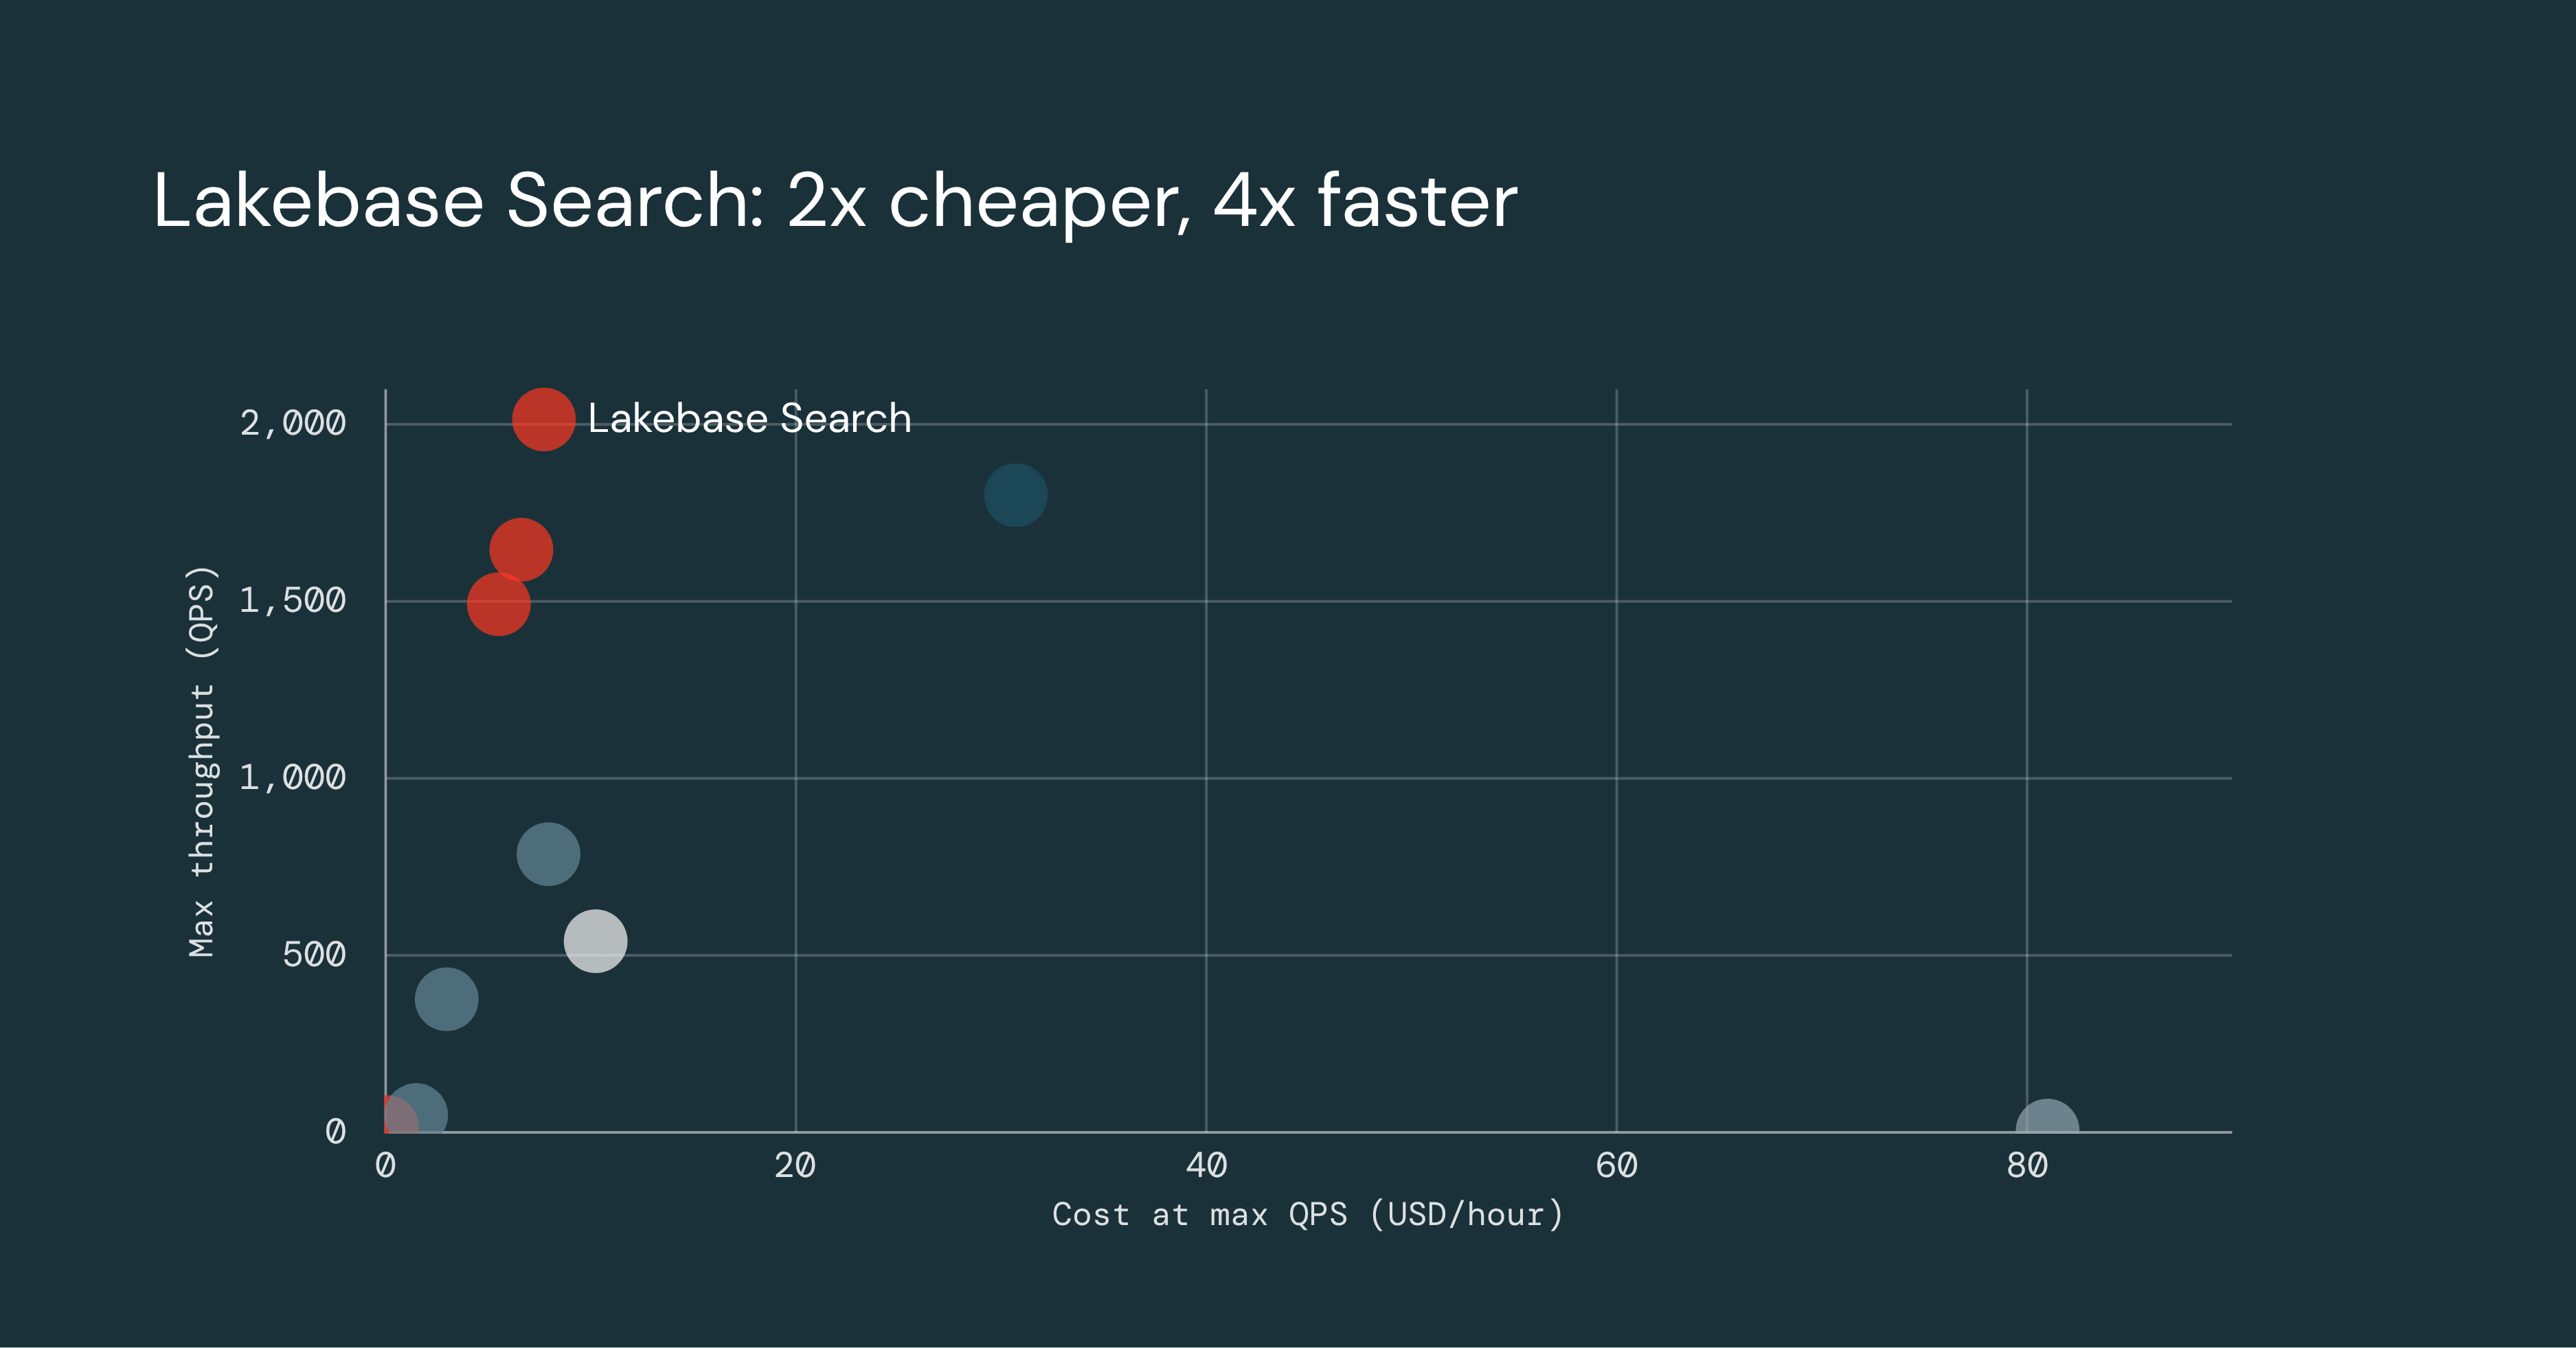
Với lakebase_vector, Postgres hiện đang ở vị thế tiên phong trong lĩnh vực tìm kiếm vector. Nó vượt trội về hiệu suất và khả năng mở rộng so với các công cụ tìm kiếm chuyên dụng. Trên chuẩn đo lường VectorDBBench 100M, nó mang lại thông lượng gấp đôi hệ thống tốt nhất tiếp theo và chi phí rẻ hơn 4 lần so với một nhà cung cấp Postgres trên đám mây sử dụng pgvector, đó là chưa tính đến khoản tiết kiệm bổ sung nhờ khả năng tự động mở rộng (autoscaling).
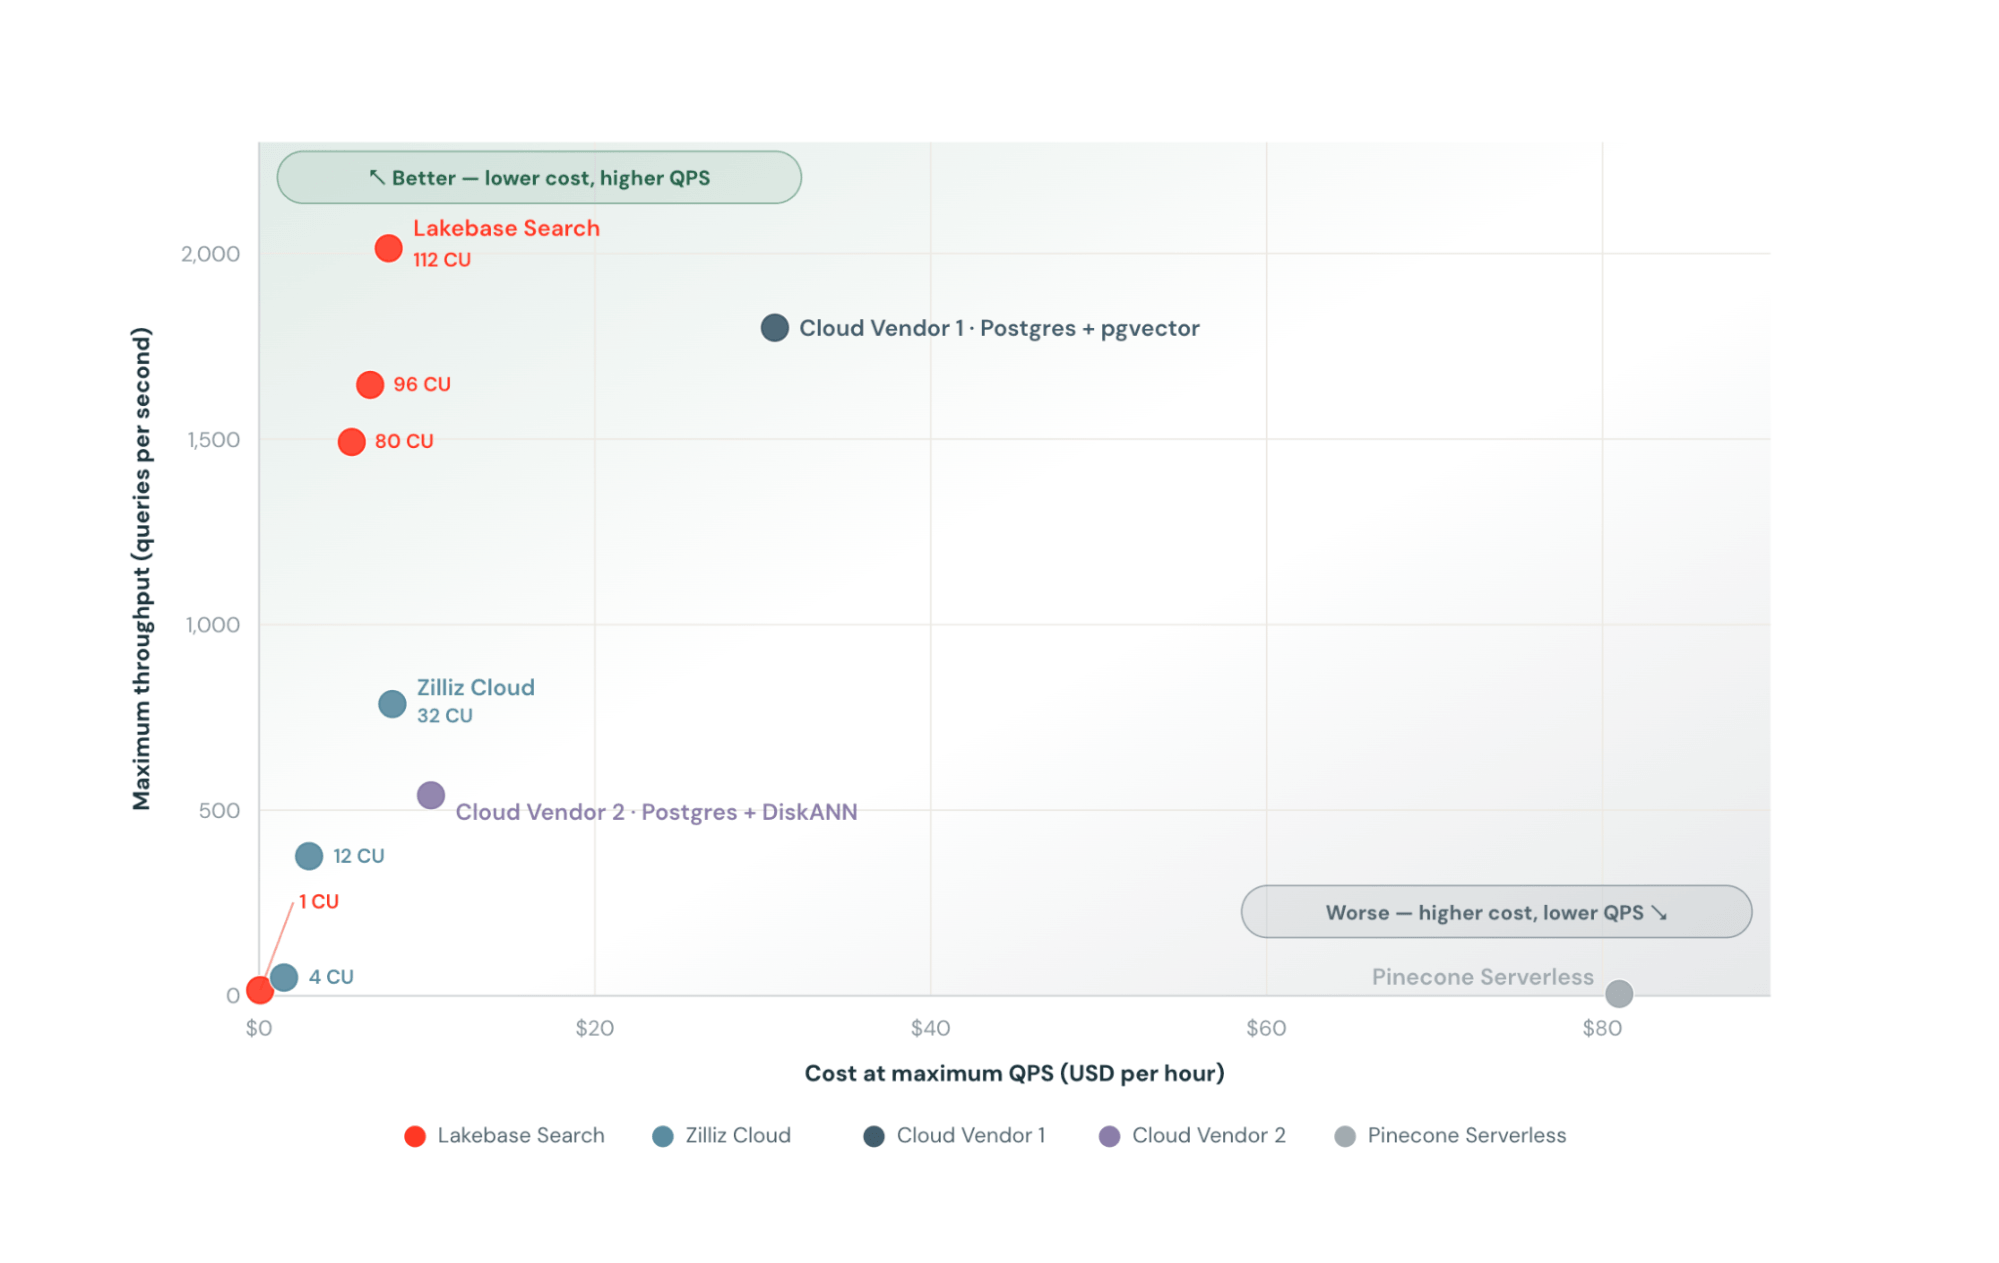
Nó duy trì hiệu suất này mà không làm giảm độ chính xác. Trong các thử nghiệm của chúng tôi, lakebase_vector đạt độ trễ P99 là 71 mili giây với tỷ lệ recall 97% (truy xuất thành công các lân cận gần nhất thực sự trong 97% trường hợp).

Lakebase Postgres hiện sở hữu các khả năng tìm kiếm hiện đại nhất, và chúng tôi đã thấy các khách hàng như Conexiom chạy tìm kiếm lai (hybrid search) với BM25 trên hơn 100 triệu hàng với mức tiêu thụ tài nguyên tính toán chỉ bằng một nửa so với thiết lập pgvector trước đây của họ. Giờ đây, họ có một cơ sở dữ liệu cho tất cả các khối lượng công việc OLTP và tìm kiếm, hoàn toàn serverless và có thể mở rộng theo nhu cầu.
Lakebase Search mang đến cho chúng tôi một cấp độ mở rộng hoàn toàn mới so với pgvector và mở khóa BM25 trong cùng một cơ sở dữ liệu serverless. Chúng tôi sử dụng Lakebase để kết nối dữ liệu với các agent của mình ở quy mô lớn. —Jordan Voves, Kiến trúc sư AI/ML tại Conexiom
Tại sao pgvector gặp giới hạn ở quy mô lớn
Đối với hầu hết người dùng Postgres, tìm kiếm bắt đầu với pgvector. Nó cho phép tìm kiếm sự tương đồng vector thông qua các thuật toán chỉ mục như HNSW và IVFFlat trên dữ liệu gốc trong Postgres, tránh được sự phức tạp của một kho lưu trữ vector riêng biệt. Trên thực tế, pgvector là tiện ích mở rộng được cài đặt nhiều nhất trong Lakebase Postgres. Chúng tôi nhận thấy 3 vấn đề phổ biến từ khách hàng khi chạy pgvector ở quy mô lớn.
Thứ nhất, chi phí tăng theo khối lượng dữ liệu chứ không phải theo mức độ sử dụng.
pgvector giữ chỉ mục trong bộ nhớ của cơ sở dữ liệu để đạt tốc độ nhanh. Vì tìm kiếm HNSW dựa trên việc duyệt đồ thị truy cập ngẫu nhiên, các truy vấn chỉ thực thi trong vài mili giây nếu mọi thứ nằm hoàn hảo trong RAM. Ngay khi chỉ mục tràn ra đĩa, các truy vấn biến thành chuỗi đọc ngẫu nhiên và hiệu suất giảm từ 10 đến 50 lần.
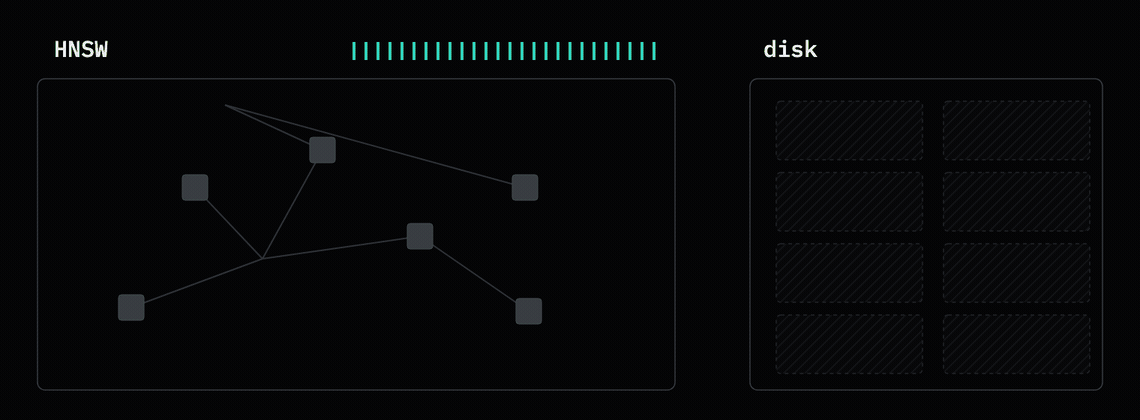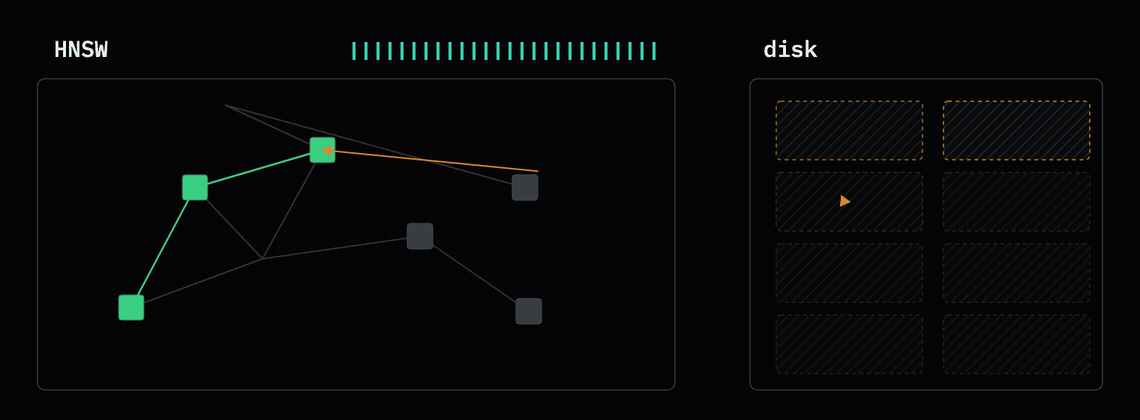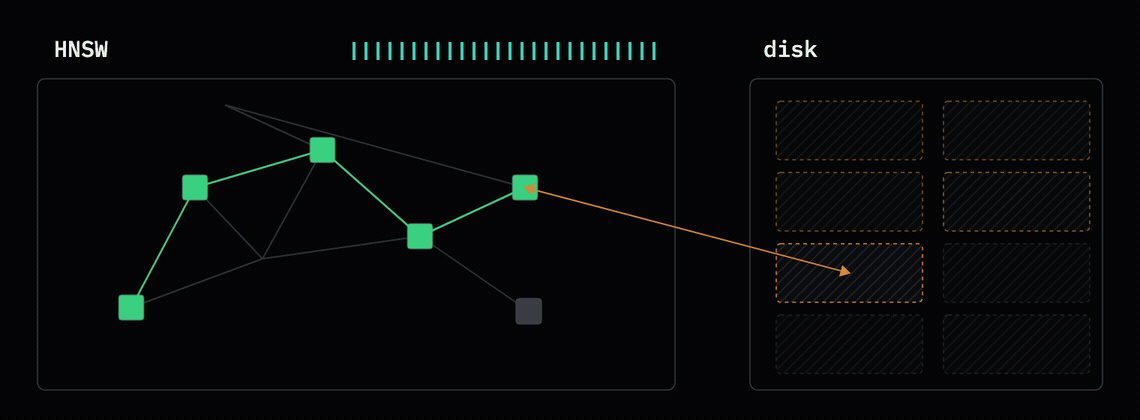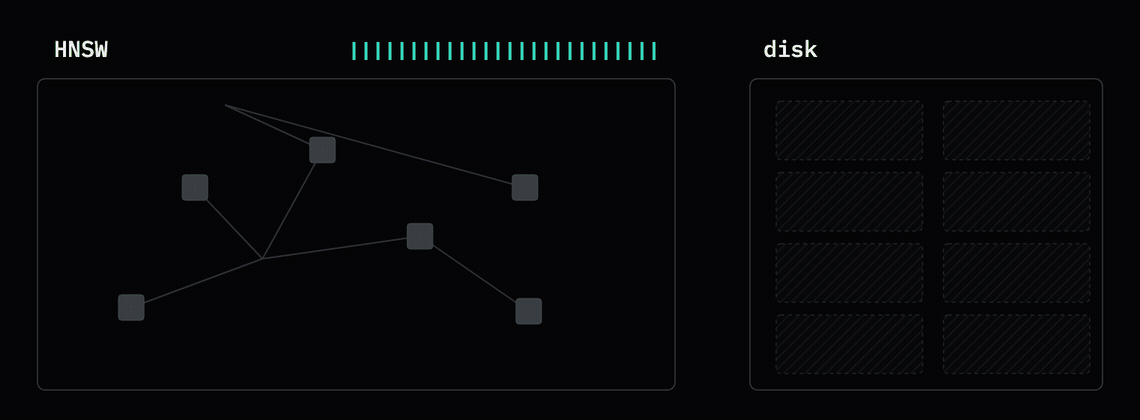
Một vector float32 768 chiều yêu cầu khoảng 3,3 KB bộ nhớ sau khi tính đến các liên kết đồ thị và chi phí quản lý của Postgres. Với 100 triệu hàng, bạn cần khoảng 330 GB RAM để giữ chỉ mục thường trú cho các truy vấn mili giây. Không có khái niệm "tập làm việc" (working set). Bạn phải cấp phát cho toàn bộ chỉ mục bất kể bạn truy vấn tất cả hay không truy vấn gì cả.
Thứ hai, việc bảo trì chỉ mục rất tốn kém và làm tắc nghẽn cơ sở dữ liệu của bạn.
Các chỉ mục Pgvector bị giới hạn bởi bộ nhớ vì đồ thị HNSW dựa trên truy cập ngẫu nhiên liên tục. Khi quá trình xây dựng tràn ra đĩa, hàng triệu thao tác I/O ngẫu nhiên sẽ làm đình trệ hiệu suất - mất gần 50 giờ để xây dựng một chỉ mục pgvector trên một instance đám mây tiêu chuẩn.
Quá trình nhập dữ liệu (ingestion) cũng chịu chung nút thắt này. Việc chèn các vector mới rất chậm và tốn kém vì mỗi lần ghi buộc pgvector phải điều hướng và sửa đổi nhiều lớp của đồ thị bằng cách tra cứu truy cập ngẫu nhiên.
Thứ hai, việc nhập dữ liệu trở nên chậm và tốn kém. HNSW dựa trên việc điều hướng đồ thị truy cập ngẫu nhiên liên tục. Nó cũng cần sửa đổi từng lớp của đồ thị. Vì vậy, chỉ mục hnsw...
Việc bảo trì liên tục làm trầm trọng thêm vấn đề. Vì HNSW thiếu khả năng tái cân bằng toàn cục, việc khôi phục chất lượng tìm kiếm đòi hỏi phải thực hiện REINDEX toàn bộ, điều này khóa bảng và chặn các lệnh ghi trong môi trường sản xuất.
Thứ ba, bạn phải đánh đổi chất lượng tìm kiếm để lấy hiệu suất.
Mỗi truy vấn pgvector chạy trên một tiến trình backend Postgres duy nhất, nghĩa là việc quét chỉ mục HNSW không bao giờ được song song hóa.
Để có tỷ lệ recall cao hơn, công cụ phải truy cập nhiều nút đồ thị hơn, kích hoạt nhiều lần đọc bộ nhớ ngẫu nhiên và so sánh khoảng cách hơn. Điều này làm tăng độ trễ và giảm QPS của bạn. Vì một tìm kiếm đơn lẻ không thể song song hóa trên các lõi, lựa chọn duy nhất của bạn để có thông lượng cao hơn là thêm nhiều kết nối hoặc bản sao đọc (read-replicas).
lakebase_vector mang đến khả năng tìm kiếm vector có thể mở rộng cho Postgres.
Nút thắt chính với pgvector là toàn bộ chỉ mục phải nằm gọn trong RAM của một máy duy nhất để đạt tốc độ nhanh. Nếu không thì sao?
Lakebase Postgres mang đến cho chúng ta một điểm khởi đầu tuyệt vời vì nó tách biệt lưu trữ khỏi tính toán. Dữ liệu bền vững nằm trong bộ lưu trữ đối tượng đám mây giá rẻ, trong khi RAM và NVMe cục bộ đóng vai trò là bộ nhớ đệm tạm thời phía trước để đọc nhanh tập dữ liệu đang làm việc. Với kiến trúc này, bộ nhớ đệm HNSW có nghĩa là một loạt các lần đọc bộ lưu trữ đối tượng ngẫu nhiên.
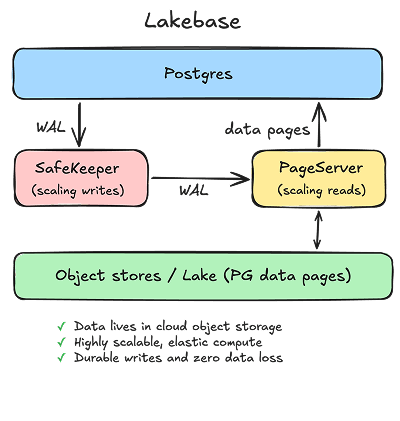
Chúng ta cần một chỉ mục nhanh cả khi được lưu trong RAM và khi ở trạng thái "lạnh" trên bộ lưu trữ đối tượng. Chúng tôi tận dụng hai ý tưởng:
- Phân cụm IVF phân cấp. Các vector được nhóm thành các cụm lưu trữ dưới dạng các khối liên tục. Một truy vấn sẽ tính điểm các tâm cụm trong bộ nhớ, sau đó chỉ đọc một vài khối tiềm năng — biến hàng trăm bước nhảy ngẫu nhiên thành một vài lần đọc tuần tự lớn.
- Lượng tử hóa nhị phân (RaBitQ). Mỗi vector được nén xuống khoảng 1 bit mỗi chiều, nhỏ hơn khoảng 32 lần so với float32. Các truy vấn quét các mã nén để chọn ra các ứng viên tiềm năng, sau đó xếp hạng lại danh sách rút gọn đó dựa trên các vector độ chính xác đầy đủ.
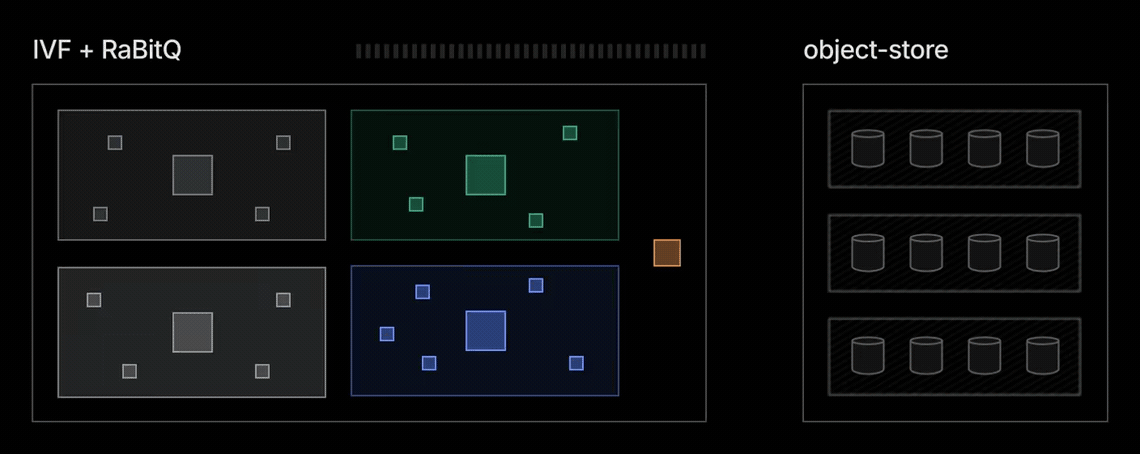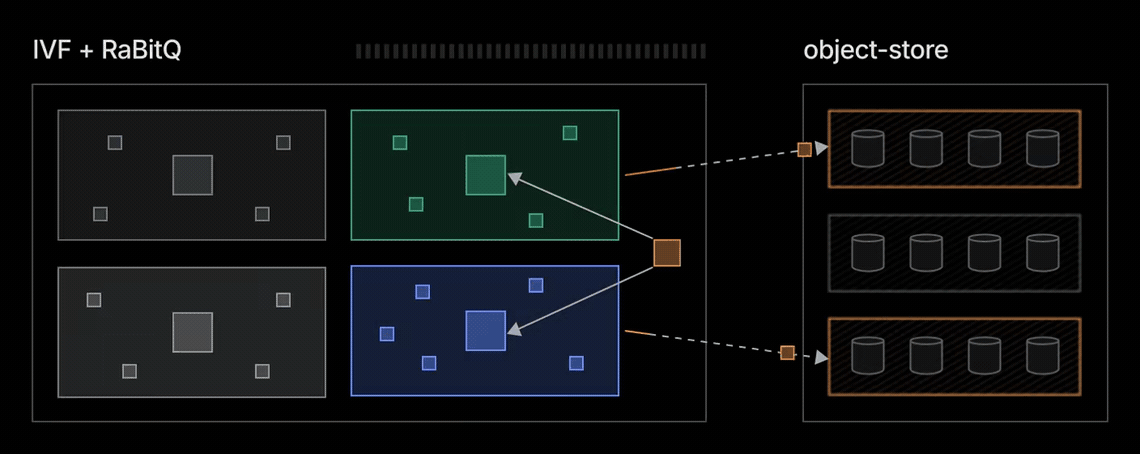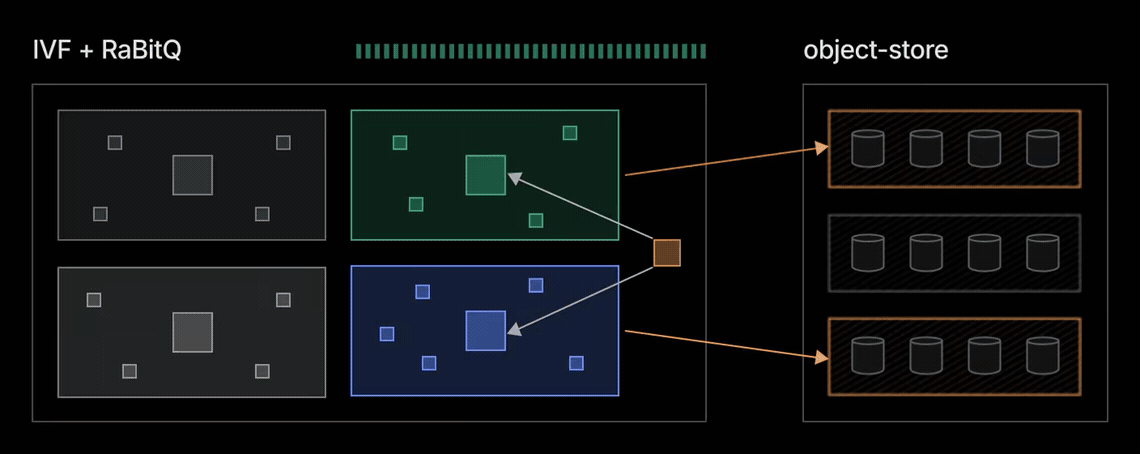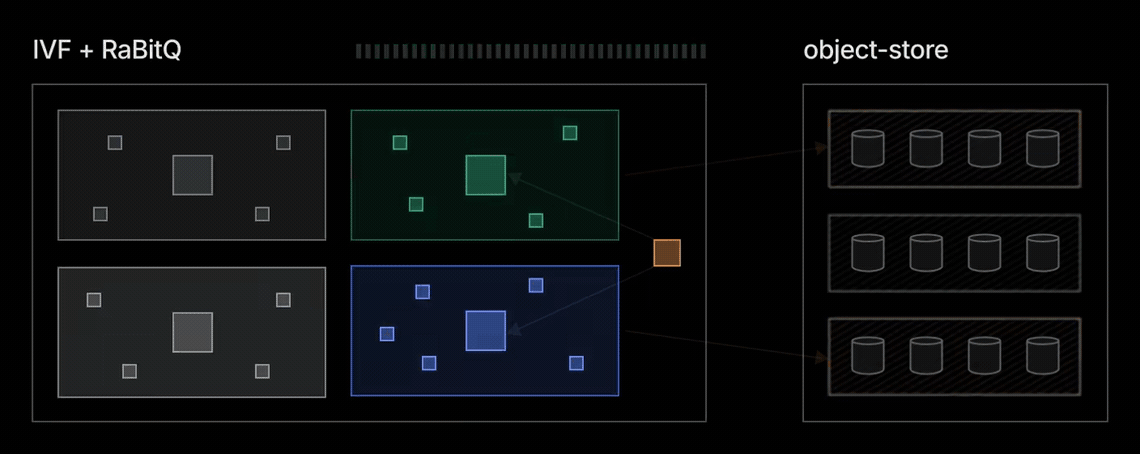
Khi được lưu trong bộ nhớ đệm, tìm kiếm hoạt động trên một dấu chân nhỏ bằng cách sử dụng các vector đã lượng tử hóa. Khi ở trạng thái lạnh, các truy vấn chỉ lấy những khối chúng cần và không cần phải duyệt toàn bộ chỉ mục. Lakebase_vector mang lại:
Chỉ trả tiền cho những gì bạn sử dụng và khả năng mở rộng về 0.
Việc tách biệt lưu trữ khỏi tính toán làm cho lakebase_vector hoàn toàn không trạng thái (stateless): một node lưu trữ dữ liệu nóng theo yêu cầu, tạm dừng về 0 khi nhàn rỗi và tiếp tục hoạt động khi có truy vấn tiếp theo.
- Khi ở trạng thái nghỉ, bạn chỉ trả tiền cho lưu trữ, mang lại chi phí cơ bản thấp để giữ các vector được lập chỉ mục trong Lakebase.
- Khởi động lạnh rất rẻ vì chỉ các mã lượng tử hóa và các khối cụ thể mà truy vấn chạm tới mới được nạp vào. P90 đo được của chúng tôi cho truy vấn đầu tiên sau khi mở rộng về 0 chỉ là 1,13 giây (100M × 768 chiều).
- Thậm chí có thể phục vụ 100 triệu vector chỉ trên 1 Đơn vị tính toán Lakebase (CU). Chỉ tập dữ liệu đang hoạt động mới cần được lưu trong bộ nhớ đệm tại các node tính toán, mang lại cho bạn một mô hình định giá phản ánh đúng mức sử dụng và hoạt động truy vấn thực tế.
Xây dựng chỉ mục nhanh, được giảm tải.
lakebase_vector xây dựng chỉ mục theo cách song song hơn. Chúng tôi huấn luyện các tâm cụm một lần trên một mẫu ngẫu nhiên nhỏ. Đây là bước duy nhất xem xét toàn bộ tập dữ liệu. Sau đó, mỗi vector được gán độc lập vào tâm cụm gần nhất của nó, được lượng tử hóa và ghi vào khối của cụm đó. Quá trình này có thể phân tán trên bao nhiêu lõi tùy thích, mở rộng theo khả năng tính toán.
Chúng tôi tiến thêm một bước bằng cách giảm tải hoàn toàn việc xây dựng chỉ mục khỏi cơ sở dữ liệu chính của bạn. Việc lưu trữ dữ liệu ở các định dạng mở cho phép kiến trúc LTAP của chúng tôi ủy quyền việc lập chỉ mục và bảo trì cho các công cụ phân tán như Spark, giúp giảm thời gian xây dựng xuống còn vài phút với khả năng tính toán song song. Hãy đón chờ nhé.
Tìm kiếm nhanh, chính xác
lakebase_vector mở rộng phạm vi tìm kiếm ứng viên với chi phí thấp bằng cách sử dụng các mã 1-bit nhỏ gọn, chỉ xếp hạng lại một danh sách rút gọn ở độ chính xác đầy đủ. Vì các khối chỉ mục độc lập với nhau, một truy vấn duy nhất có thể được xử lý song song trên các nhân CPU, mang lại khả năng truy xuất cao và độ trễ thấp cùng một lúc.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.