Tin ngành
Giải mã kiến trúc GPU Adreno X2 trên Snapdragon X2 Elite: Bước nhảy vọt về hiệu năng
(giờ Việt Nam)
Tóm tắt AI
Qualcomm nâng cấp Adreno X2-90 với 8 nhân xử lý và xung nhịp 1.85 GHz, giúp hiệu năng lý thuyết tăng gấp đôi so với thế hệ trước, dù vẫn duy trì một số hạn chế về tập lệnh tính toán.
Bản dịch AI
GPU tích hợp (iGPU) đã trở thành một thành phần quan trọng trong các chip laptop gần đây, nhờ vào nhu cầu thúc đẩy hiệu năng đồ họa tốt hơn trên các thiết bị siêu di động. Cả AMD và Intel đều đã ra mắt các triển khai iGPU ấn tượng trong những năm gần đây. Việc Qualcomm đẩy mạnh mảng laptop đòi hỏi một iGPU mạnh mẽ trong bối cảnh này, và đó là lý do Adreno X2-90 trên Snapdragon X2 Elite xuất hiện.
Adreno X2 mở rộng dựa trên nền tảng của Adreno X1 trên Snapdragon X Elite, nhưng mang đến một kiến trúc cải tiến hướng tới thông lượng cao hơn. Các Shader Processor (SP) đóng vai trò là khối xây dựng cơ bản cho GPU Adreno của Qualcomm. Mỗi SP chứa một cặp Micro Shader Processor Texture Processor (uSPTPs), bao gồm các đơn vị thực thi, tệp thanh ghi và bộ nhớ đệm kết cấu (texture cache) riêng. Ở cấp độ cao hơn, Qualcomm nhóm các cặp SP thành các lát (slices). Một phần X2-90 được kích hoạt đầy đủ có tám SP được nhóm thành bốn lát, so với sáu SP trong ba lát trên Adreno X1. Qualcomm cũng đã tăng tốc độ xung nhịp từ 1,5 lên 1,85 GHz. Một GPU lớn hơn với xung nhịp cao hơn sẽ gây áp lực nhiều hơn lên hệ thống con bộ nhớ, vì vậy Qualcomm đã tăng kích thước bộ nhớ đệm và băng thông trên toàn bộ hệ thống phân cấp bộ nhớ.
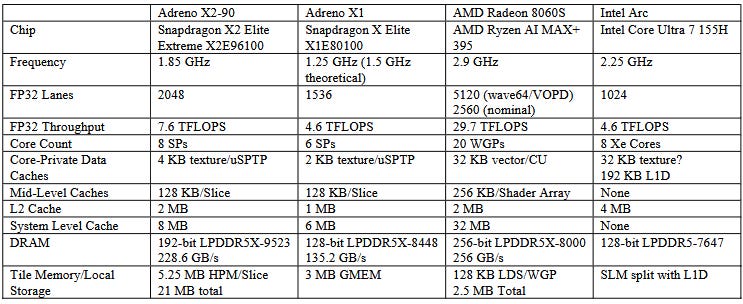
Với tất cả những thay đổi này, Adreno X2 có thông lượng tính toán lý thuyết gần gấp đôi so với người tiền nhiệm. Nó bị lu mờ bởi iGPU cao cấp nhất của AMD, vốn vượt trội hơn về mọi mặt. Chip “Strix Point” tiêu chuẩn hơn của AMD có thể là một sự so sánh phù hợp hơn, nhưng tôi không có sẵn nó trên tay, vì vậy tôi sẽ thực hiện so sánh hiệu năng trên một loạt các thiết bị thú vị. Xin gửi lời cảm ơn đặc biệt đến ASUS vì đã cung cấp chiếc Zenbook A16 để thử nghiệm.
Dòng Adreno của Qualcomm theo truyền thống nhấn mạnh vào thông lượng cao cho các thao tác FP32 và FP16 cơ bản. Các uSPTP của Adreno X2 tiếp tục nhấn mạnh điều đó, với 128 làn FP32 dường như được sắp xếp thành hai phân vùng đơn vị thực thi. FP16 được hưởng lợi từ việc thực thi tốc độ gấp đôi như trên nhiều GPU hiện đại.
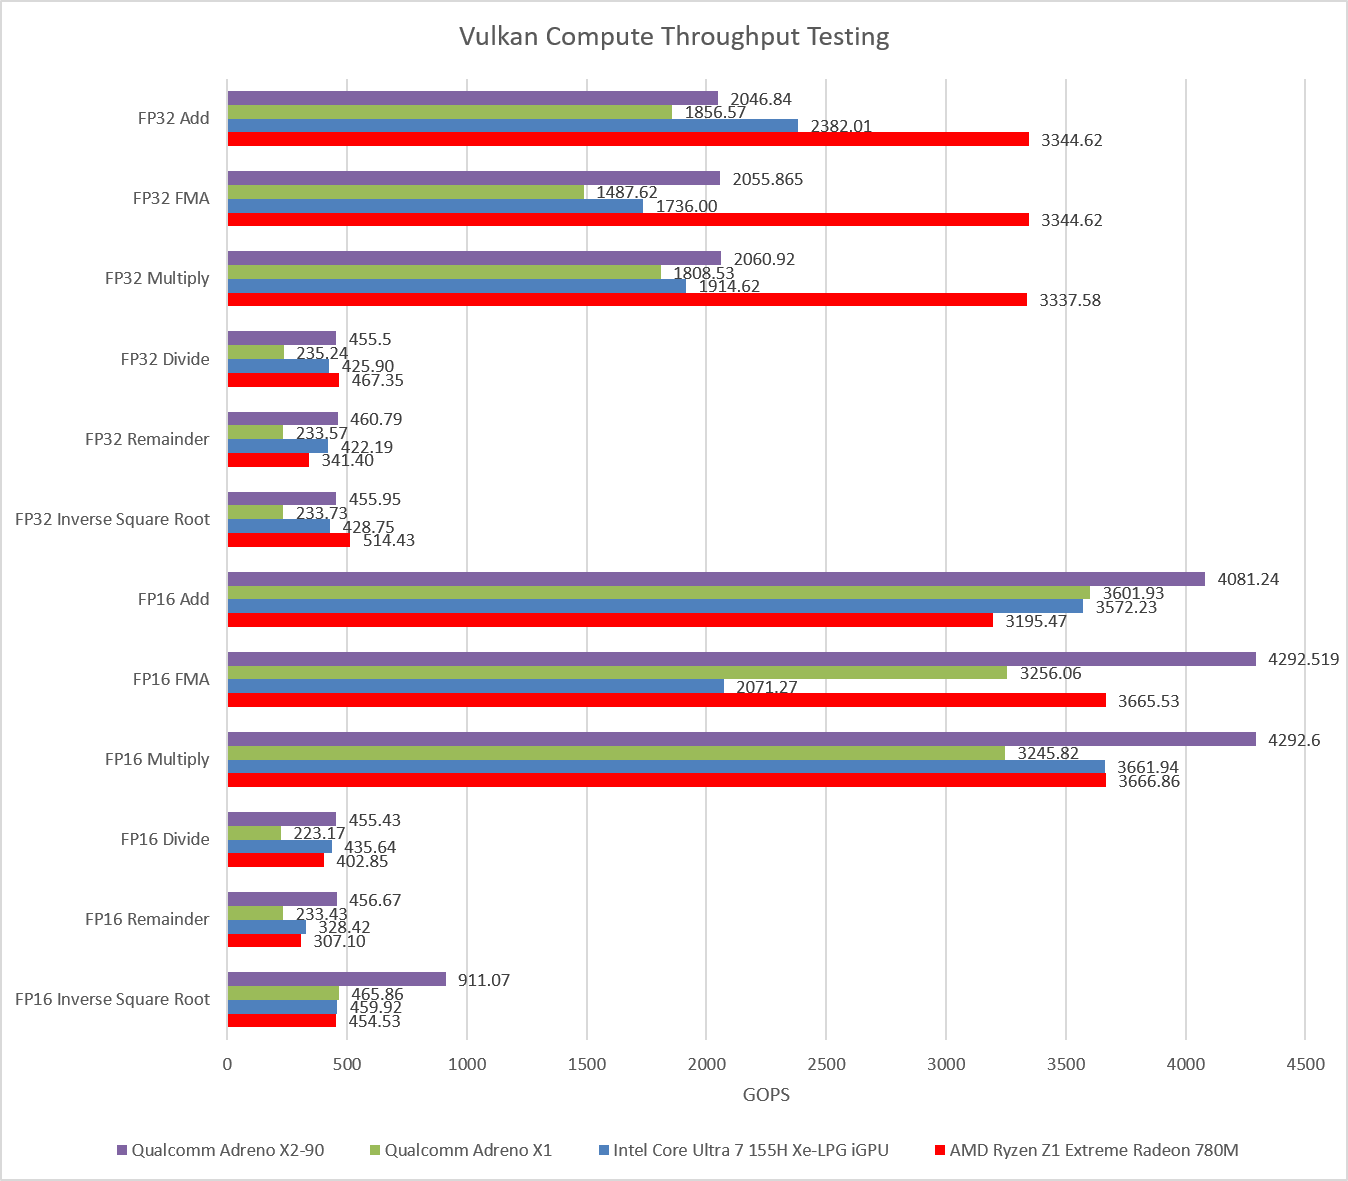
Các loại lệnh khác không nhất thiết có cùng thông lượng cao, nhưng Adreno X2 đã cải thiện so với người tiền nhiệm ở một số lĩnh vực. Các phép cộng INT32 dường như thực thi ở tốc độ tối đa, mặc dù khó đạt được thông lượng lý thuyết trên chúng so với các thao tác FP32. Các phép nhân số nguyên 32-bit thực thi ở tốc độ một nửa, điều này tương đương tốt với kiến trúc GPU của Intel và AMD, và phù hợp với Nvidia. Hiệu năng số nguyên nhìn chung là một cải tiến lớn so với tình trạng khá kém trên Adreno X1, nơi ngay cả các thao tác số nguyên cơ bản cũng thực thi ở tốc độ dưới một nửa. Các đơn vị INT32 tốt hơn cũng giúp ích cho hiệu năng số nguyên 64-bit, vì GPU thực hiện chúng bằng cách sử dụng nhiều thao tác INT32. Giống như các GPU Adreno trước đây, Adreno X2 thiếu hỗ trợ FP64.
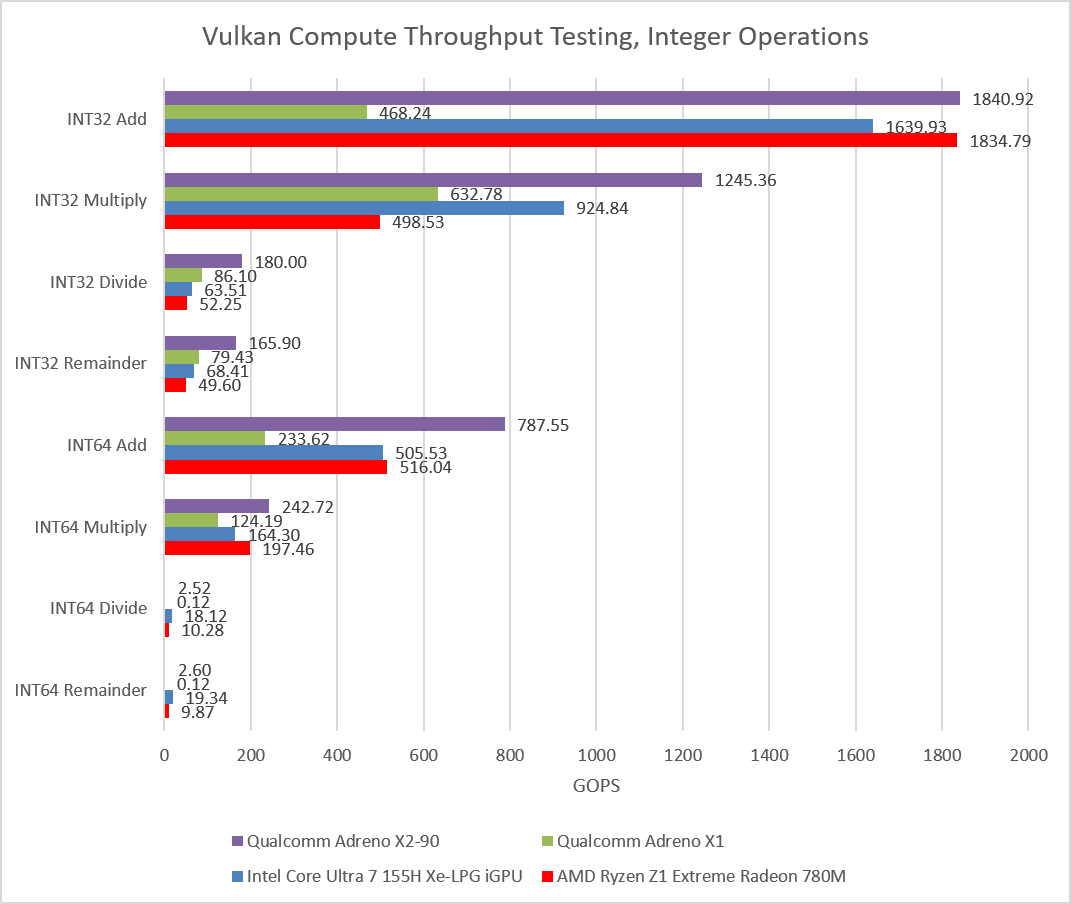
Thử nghiệm với bộ công cụ dựa trên Vulkan của Nemes cho thấy những cải thiện đáng kể về tính toán so với Adreno X1. Adreno X2 cũng so sánh tốt với các iGPU cũ hơn. Radeon 780M của AMD có thể đạt được thông lượng FP32 cao hơn nếu AMD có thể sử dụng các lệnh thao tác kép VOPD hoặc chế độ wave64, nhưng Adreno X2 cũng không quá xa ngay cả trong trường hợp đó. Tuy nhiên, Adreno X2 dường như cần rất nhiều công việc đang thực hiện để đạt được thông lượng tính toán lý thuyết, ngay cả khi so sánh với các GPU lớn hơn như Strix Halo của AMD.
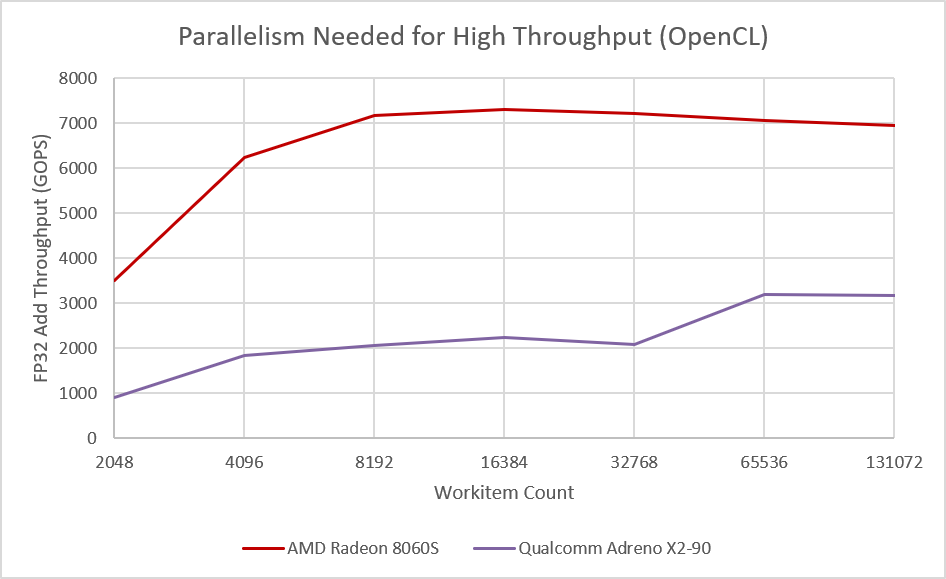
Thử nghiệm OpenCL với các kích thước dispatch khác nhau cho thấy Adreno X2 có thể đạt vượt mức TFLOPS với các phép cộng FP32, hoặc 6 TFLOPS với các phép nhân-cộng. Adreno X2 chỉ cần thêm khoảng 8 lần tính song song để đạt được thông lượng tối đa. Thử nghiệm thêm với OpenCL với các dispatch lớn cho thấy Adreno X2 tiến gần đến thông lượng lý thuyết trong các thao tác dấu phẩy động. Tuy nhiên, thông lượng INT32 hầu như không cải thiện so với Vulkan.
Adreno X2 vẫn thiếu khả năng tính toán nhân-cộng hợp nhất (FMA) phần cứng giống như người tiền nhiệm. FMA tránh làm tròn trung gian giữa phép nhân và phép cộng, giúp giảm sai số số học. Việc yêu cầu điều đó bằng cách sử dụng hàm tích hợp fma của OpenCL dẫn đến thông lượng rất kém. Các GPU của AMD, Intel và Nvidia đều có phần cứng FMA gốc và có thể cung cấp hành vi FMA mà không bị giảm thông lượng.
Mỗi uSPTP của Adreno X2 có 128 KB dung lượng tệp thanh ghi, giảm từ 192 KB trên Adreno X1. Thiết kế tệp thanh ghi thường khó khăn vì chúng phải cung cấp băng thông cực lớn để cung cấp cho các đơn vị vector rộng của GPU. Các tệp thanh ghi nhỏ hơn có thể đã cho phép Qualcomm tăng tốc độ xung nhịp trong khi vẫn kiểm soát được điện năng và diện tích. Adreno X2 cũng loại bỏ chế độ wave128 của Adreno X1 và chỉ hỗ trợ wave64. Kích thước wave nhỏ hơn có thể giúp dung lượng tệp thanh ghi sử dụng hiệu quả hơn vì mỗi luồng có thể phân bổ nhiều thanh ghi hơn trước khi ảnh hưởng đến khả năng chiếm dụng lý thuyết.
Với sự thay đổi về dung lượng tệp thanh ghi, khả năng chiếm dụng của Adreno X2 sẽ hoạt động giống như Adreno 730.
Qualcomm không tiết lộ khả năng chiếm dụng lý thuyết của Adreno X2, nhưng tôi đã cố gắng đoán bằng cách chạy thử nghiệm độ trễ DRAM với các kích thước dispatch khác nhau và cùng một mẫu truy cập được sử dụng trên tất cả các workitem. Nếu GPU có thể giữ tất cả các workitem đang chạy, độ trễ sẽ không cao hơn nhiều so với một workitem đơn lẻ. Tuy nhiên, việc hết các khe wave sẽ buộc một số workitem phải đợi cho đến khi một workitem khác hoàn thành và khe wave của nó trống, làm tăng thời gian chạy quan sát được.
Tôi nghi ngờ mỗi phân vùng uSPTP của Adreno X2 có khoảng từ 6 đến 8 khe wave, với 8 là con số khả thi hơn. Độ trễ bắt đầu tăng với dispatch 12288 workitem (6x wave64 trên mỗi phân vùng uSPTP), và tăng hơn gấp đôi khi đi từ 16384 lên 18432 workitem.
Qualcomm cũng không tiết lộ dung lượng bộ nhớ đệm lệnh, nhưng thử nghiệm cơ bản với các vòng lặp ngày càng lớn cho thấy thông lượng từ một luồng đơn lẻ vẫn ở mức cao với tối đa 8192 câu lệnh cộng FP32 trong vòng lặp. Các con số thông lượng tuyệt đối cho thấy Adreno X2 không thể phát hành kép các phép cộng FP32 từ một luồng đơn lẻ, có thể là do mỗi luồng wave64 bị khóa vào một phân vùng uSPTP duy nhất. Thông lượng vẫn ở mức hợp lý ở các dấu chân lệnh lớn hơn.
Adreno X2 có hệ thống phân cấp bộ nhớ được tăng cường so với người tiền nhiệm, nhưng vẫn tiếp tục kế thừa các tính năng hệ thống con bộ nhớ kiểu Adreno khiến nó trở nên khác biệt so với các GPU hiện đại khác. Các uSPTP tiếp tục có các bộ nhớ đệm kết cấu không phục vụ các truy cập bộ nhớ toàn cục tính toán. Các bộ nhớ đệm kết cấu này hiện có kích thước 4 KB, nhưng vẫn còn rất nhỏ. Bộ nhớ đệm kết cấu nhỏ nhất mà tôi từng thấy bên ngoài các GPU Adreno của Qualcomm là bộ nhớ 8 KB trên Terascale của AMD.
Các truy cập bộ nhớ toàn cục đi thẳng đến các bộ nhớ đệm cụm (cluster caches) 128 KB của Adreno X2. Các truy cập bộ nhớ đệm cụm có độ trễ cao hơn một chút so với các lần truy cập bộ nhớ đệm kết cấu, nhưng vẫn ở mức hợp lý theo nghĩa tuyệt đối. Tuy nhiên, điều đó có nghĩa là Qualcomm có độ trễ tối thiểu cao hơn cho các truy cập bộ nhớ toàn cục so với AMD. Khoảng cách đặc biệt rộng nếu AMD có thể thực hiện các tối ưu hóa vô hướng (scalar optimizations). Qualcomm không có hệ thống phân cấp bộ nhớ đệm vô hướng riêng biệt. Ngay cả khi tôi sử dụng loại bộ nhớ hằng số, nó dường như được hỗ trợ bởi cùng một bộ nhớ đệm cụm. Bộ nhớ đệm cụm hoạt động tốt về mặt băng thông và có thể cung cấp 64B/chu kỳ cho mỗi uSPTP.
Một bộ nhớ đệm L2 2 MB nằm sau các bộ nhớ đệm cụm và khớp với L2 2 MB của AMD trên Strix Halo và Strix Point. Độ trễ L2 khá tốt và tốt hơn của AMD. Dung lượng L2 nhỏ so với những gì Intel đã làm, nhưng Qualcomm có bộ nhớ đệm cấp hệ thống để bắt các lỗi L2, khiến chúng ít phụ thuộc hơn vào dung lượng L2. Strix Halo của AMD sử dụng một chiến lược tương tự.
Băng thông L2 dường như cao hơn một chút so với 1 TB/s, hoặc chỉ hơn 32B/chu kỳ trên mỗi uSPTP. Giống như các bộ nhớ đệm cấp trên trên nhiều GPU, bộ nhớ đệm cụm của Adreno X2 là write-through (ghi xuyên qua) hoặc chỉ đọc. Các lần ghi đi đến L2, nơi phục vụ chúng ở khoảng một nửa tốc độ đọc.
Các thao tác nguyên tử (atomic operations) thường được xử lý tại L2 vì đó là cấp bộ nhớ đệm đầu tiên được chia sẻ trên toàn bộ GPU. Adreno X2 cung cấp thông lượng khá cho các phép cộng nguyên tử INT32. Tính mỗi phép cộng là hai truy cập 4B (đọc-sửa-ghi) cho băng thông hiệu dụng 632,64 GB/s.
Thử nghiệm độ trễ giữa các luồng bằng cách sử dụng atomic_cmpxchg trên bộ nhớ toàn cục cho thấy hiệu năng tuyệt vời từ Adreno X2 và là một cải tiến lớn so với Adreno X1. Độ trễ “lõi đến lõi” trên Adreno X2 ngang bằng với các kiến trúc GPU mới nhất của AMD và tốt hơn so với iGPU trên Meteor Lake của Intel.
Bộ nhớ đệm cấp hệ thống (SLC) 8 MB của Snapdragon X2 Elite có độ trễ khá cao ở mức hơn 200 ns, hoặc cao hơn khoảng 150 ns so với độ trễ truy cập L2. Băng thông SLC dường như vào khoảng 380 GB/s, cao hơn một cách thoải mái so với băng thông DRAM. Radeon 8060S cao cấp của AMD có cả băng thông cao hơn và độ trễ thấp hơn đối với SLC 32 MB của nó.
Đối với DRAM, Qualcomm có một thiết lập khá mạnh mẽ với cấu hình 192-bit LPDDR5X-9523. Tôi có thể nhận được hơn 150 GB/s băng thông DRAM từ GPU. Điều đó tốt hơn những gì một thiết lập LPDDR5X 128-bit điển hình có thể đạt được, nhưng vẫn dưới 70% so với lý thuyết. Một điểm tích cực tiềm năng ở đó là nhu cầu băng thông của GPU không thể gây áp lực lên các truy cập phía CPU ở mức độ tương tự như các triển khai iGPU khác, nơi iGPU có thể chiếm một phần lớn hơn băng thông DRAM lý thuyết.
Tình trạng độ trễ DRAM của Adreno X2 hơi lạ. Độ trễ ổn định ở mức khoảng 274 ns với kích thước thử nghiệm vừa phải, nhưng tăng vọt khi phạm vi thử nghiệm vượt quá 64 MB. Thử nghiệm với bước nhảy 128B làm tăng gấp đôi dung lượng bộ nhớ đệm cụm rõ ràng, cho thấy bộ nhớ đệm cụm của Adreno X2 có các dòng 64B. Dung lượng L2 rõ ràng vẫn không thay đổi cho đến khi độ dài bước nhảy vượt quá 4 KB, sau đó các bước nhảy lớn hơn đẩy cả L2 và các điểm uốn 64 MB ra ngoài. Cách giải thích của tôi là Adreno X2 có L2 được định địa chỉ ảo và sử dụng các trang 4 KB để dịch địa chỉ với TLB 16K mục nhập được đặt sau L2. Độ trễ cao ở kích thước thử nghiệm lớn ngụ ý hình phạt lỗi TLB L2 rất cao. Độ trễ truy cập DRAM thô, không bao gồm các hình phạt dịch địa chỉ, có khả năng nằm quanh con số 274 ns hợp lý đó. Tuy nhiên, các ứng dụng thực hiện các truy cập với tính cục bộ kém trên một phạm vi bộ nhớ lớn có thể gặp phải độ trễ cao hơn nhiều.
Qualcomm có lịch sử lâu đời trong việc áp dụng kết xuất lát (tiled rendering), và Adreno X2 tăng gấp đôi điều đó với một khối lưu trữ trên chip khổng lồ 21 MB có tên là “Adreno High Performance Memory”. HPM này thực hiện cùng chức năng như GMEM (Graphics Memory) trong các GPU Adreno trước đây, và giữ các mục tiêu kết xuất để chứa trạng thái lát trung gian trong khi một lát đang được raster hóa. Để so sánh, Adreno X1 có 3 MB GMEM, trong khi Adreno 730 của Snapdragon 8+ Gen 1 có 2 MB GMEM. Qualcomm cho biết họ đã định cỡ HPM để xử lý các khung hình QHD+. Một khung hình 1440P với 32 bit mỗi pixel (RGBA, 8 bit mỗi kênh) sẽ chiếm 14,7 MB. ASUS đã trang bị cho Zenbook A16 một màn hình OLED 2880x1800. Thực hiện phép tính tương tự sẽ cho ra 20,7 MB mỗi khung hình, vừa đủ để chứa trong HPM.
Thay vì thực hiện kết xuất lát theo nghĩa truyền thống với khoảng một chục lát mỗi khung hình, Qualcomm dường như đang tung ra một cú lừa bằng cách cố gắng biến toàn bộ màn hình thành một lát. Kết xuất lát đi kèm với những điểm không hiệu quả tiềm ẩn. Ví dụ, một hình tam giác chồng lên hai lát sẽ phải đi qua bộ raster hóa hai lần, tạo thêm công việc cho bộ raster hóa. Khi một lát hoàn thành, các khe wave có thể bắt đầu trống trên mảng shader. GPU có thể có thêm công việc pixel khả dụng, nhưng phải giữ lại vì toàn bộ mục đích của kết xuất lát là tuần tự hóa quy trình raster hóa ở cấp độ lát. Những điểm không hiệu quả tiềm ẩn đó đột nhiên biến mất nếu toàn bộ màn hình là một lát. Đồng thời, Qualcomm vẫn sẽ có lợi thế là có thể chứa trạng thái lát trung gian trong bộ nhớ trên chip. Tất nhiên, một bộ nhớ đệm lớn có thể làm điều này một cách tự nhiên, nhưng một bộ nhớ đệm đòi hỏi thêm điện năng và diện tích cho các mảng thẻ và trạng thái.
HPM là một bước đi tuyệt vời nếu các ứng dụng tuân thủ API raster hóa thông thường, nhưng tôi lo ngại rằng khả năng áp dụng của HPM có thể bị hạn chế đối với tính toán mục đích chung. Mặc dù raster hóa vẫn là nền tảng của chơi game trên PC và có khả năng sẽ tiếp tục như vậy trong tương lai gần, quy trình raster hóa hiện đại đôi khi bao gồm một thành phần tính toán. Các công cụ kết xuất mới hơn thường có các tính năng tận dụng tính toán, như Nanite của Unreal Engine 5. HPM không vô dụng trong các tình huống này, vì Qualcomm có thể phân bổ một phần HPM để sử dụng làm scratchpad do phần mềm quản lý. Sau đó, HPM có thể đảm nhận vai trò tương tự như Local Data Share của AMD hoặc Shared Memory của Nvidia.
Tôi đã cố gắng xem GPU có thể chạy bao nhiêu nhóm công việc (workgroups) cùng lúc với các lượng bộ nhớ cục bộ OpenCL khác nhau được phân bổ. Từ các thử nghiệm đó, Adreno X2 chỉ có vẻ có khả năng phân bổ 1 MB HPM làm bộ nhớ cục bộ. Các phân bổ bộ nhớ cục bộ không phải là lũy thừa của hai làm giảm con số đó hơn nữa. 1 MB bộ nhớ cục bộ không tệ đối với một GPU có kích thước như Adreno X2. Adreno X1 chỉ có thể phân bổ 384 KB bộ nhớ cục bộ trên toàn bộ GPU. Radeon 8060S của AMD có 2,5 MB Local Data Share (LDS) trên toàn bộ GPU, điều này hợp lý khi xem xét kích thước lớn hơn của nó. Tuy nhiên, việc có 21 MB lưu trữ và chỉ có thể sử dụng một phần nhỏ trong đó để tính toán không mang lại cảm giác tuyệt vời.
Độ trễ bộ nhớ cục bộ cải thiện so với Adreno X1, điều này rất ấn tượng vì HPM lớn gấp bảy lần GMEM của Adreno X1. Tuy nhiên, các GPU mới nhất của AMD, Intel và Nvidia vẫn cung cấp độ trễ tốt hơn cho bộ nhớ cục bộ. Dễ dàng thực hiện điều đó hơn khi các truy cập không phải đi qua kết nối liên thông GPU.
Độ trễ giữa các luồng thông qua bộ nhớ cục bộ cũng cải thiện trên Adreno X2. Nhưng một lần nữa, LDS riêng của lõi trên các GPU mới nhất của AMD lại nhanh hơn.
Các phép cộng nguyên tử trên bộ nhớ cục bộ thường có thông lượng cao hơn so với các phép cộng qua bộ nhớ toàn cục, vì hầu hết các GPU đều có các ALU nguyên tử chuyên dụng được triển khai tại các phiên bản bộ nhớ cục bộ trên mỗi lõi. Đó không phải là trường hợp của Adreno X2, vốn có khả năng duy trì 32 phép cộng nguyên tử INT32 mỗi chu kỳ trên toàn bộ GPU, hoặc 4 mỗi chu kỳ trên cơ sở SP. Để so sánh, RDNA3.5 của AMD có thể thực hiện 32 phép cộng nguyên tử INT32 mỗi chu kỳ tại Local Data Share của mỗi WGP. Xe-LPG của Intel trong Meteor Lake cũng cung cấp thông lượng cao, với 16 phép cộng nguyên tử INT32 mỗi chu kỳ Xe Core.
Thử nghiệm băng thông bộ nhớ cục bộ cho thấy HPM có thể cung cấp băng thông nhiều như bộ nhớ đệm kết cấu hoặc bộ nhớ đệm cụm của GPU.
Phần mềm thông thường sử dụng các API sao chép để lấy dữ liệu đến và đi từ GPU. Với clEnqueueReadBuffer và clEnqueueWriteBuffer của OpenCL, việc sao chép dữ liệu sang GPU nhanh hơn nhiều so với chiều ngược lại. Các GPU Adreno trước đây cũng hoạt động như vậy. Thật kỳ lạ, việc ghim khối lượng công việc vào các lõi khác nhau làm thay đổi băng thông đo được, nhưng chỉ ảnh hưởng đến việc di chuyển từ bộ nhớ CPU sang GPU. Qualcomm có thể đang sử dụng một lõi CPU để thực hiện việc truyền, thay vì giảm tải việc di chuyển dữ liệu cho các công cụ DMA như nhiều GPU khác.
Các API mới hơn có thể cho phép hành vi zero-copy. API Shared Virtual Memory (SVM) của OpenCL là một ví dụ, và cũng duy trì các địa chỉ ảo giống nhau để cho phép mã CPU và GPU sử dụng cùng các con trỏ. Adreno X2 quảng cáo hỗ trợ các nguyên tử với SVM, nghĩa là CPU và GPU về lý thuyết có thể trao đổi dữ liệu trong khi kernel GPU đang chạy. Tuy nhiên, tôi không thể khiến GPU và CPU nhìn thấy các lần ghi của nhau bằng các thao tác nguyên tử.
Tôi đã có thể thử nghiệm với chia sẻ chi tiết (fine grained sharing), cho phép CPU nhìn thấy các lần ghi của GPU sau khi kernel GPU kết thúc. Làm cho các lần ghi hiển thị giữa CPU và GPU đủ nhanh để cho thấy Qualcomm không sao chép toàn bộ bộ đệm thử nghiệm 256 MB dưới nền. Tuy nhiên, chi phí khởi chạy và đồng bộ hóa kernel cao hơn so với các nền tảng khác, đặc biệt nếu thử nghiệm được chạy từ E-Core.
FluidX3D mô phỏng hành vi chất lỏng bằng phương pháp lattice Boltzmann (LBM), và trong lịch sử là một khối lượng công việc đầy thách thức đối với các GPU Adreno. FluidX3D sử dụng các thao tác FMA trong cấu hình mặc định của nó, dẫn đến hiệu năng kém trên Adreno so với hầu hết mọi thứ khác. FluidX3D có thể được sửa đổi để sử dụng cài đặt “legacy_fma”, sử dụng các thao tác nhân-cộng thay vì nhân-cộng hợp nhất. Nhưng ngay cả với sửa đổi đó, Adreno X2 vẫn gặp khó khăn. Nó thoái lui so với Adreno X1, và cách xa các iGPU thế hệ trước.
Bài viết được AI dịch và tổng hợp tự động từ Chips and Cheese. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.