Sản phẩm
vLLM ra mắt vllm-metal v0.28.0: Hỗ trợ phục vụ suy luận đồng thời trên Apple Silicon
(giờ Việt Nam)
Tóm tắt AI
vLLM chính thức phát hành vllm-metal v0.28.0, mang bộ lập lịch V1, paged KV cache và server tương thích OpenAI lên chip Apple Silicon thông qua MLX và Metal.
Chính văn · Bản dịch AI
Việc suy luận cục bộ trên Mac khá đơn giản cho đến khi nhiều yêu cầu chồng chéo lên nhau. Khi đó, thời gian tạo token đầu tiên (TTFT), mức tăng bộ nhớ và kiểm soát tiếp nhận trở thành các vấn đề về phục vụ thay vì vấn đề thực thi mô hình. vllm-metal mang bộ lập lịch, bộ nhớ đệm KV phân trang và máy chủ tương thích OpenAI của vLLM lên Apple Silicon, với MLX và Metal đảm nhận việc thực thi.
Bản phát hành chính thức đầu tiên của chúng tôi, v0.28.0, đã đồng bộ hóa cách đánh số phiên bản của vllm-metal với vLLM gốc. Nó giới thiệu tính năng dự đoán đa token theo lô (MTP), hỗ trợ GGUF và mô hình lai, cùng khả năng prefill nhanh hơn trên M5. Bạn có thể cài đặt v0.29.0 bằng Homebrew.
vllm-metal kết nối với vLLM gốc. vLLM cung cấp bộ lập lịch V1, quản lý khối KV phân trang, prefill theo đoạn, lấy mẫu và giao diện tương thích OpenAI với tính năng streaming và phân tích cú pháp gọi công cụ. mlx_lm cung cấp các triển khai mô hình; MLX thực thi chúng.
Ở cấp độ mô hình, vllm-metal tái sử dụng các lớp weight loading, RMSNorm, linear, MoE và MLP của mlx_lm mà không thay đổi. Các lớp này xử lý từng token một cách độc lập, vì vậy chúng chạy trên trục token đã đóng gói mà không cần biết ranh giới yêu cầu. Attention cần các ranh giới đó, vì vậy vllm-metal thay thế attention mặc định bằng một kernel Metal phân trang có độ dài biến thiên (varlen). Do đó, hầu hết mã dành riêng cho mô hình của plugin nằm trong một lớp duy nhất.
Khởi chạy máy chủ tương thích OpenAI
Trên Apple Silicon với macOS 15 trở lên, hãy cài đặt bản phát hành ổn định bằng Homebrew:
brew tap vllm-project/vllm-metal https://github.com/vllm-project/vllm-metal
brew install vllm-project/vllm-metal/vllm-metal
Homebrew quản lý Python và các phần phụ thuộc. Chạy vllm trực tiếp để khởi chạy mô hình:
# --gpu-memory-utilization sets the serving memory budget; see below.
vllm serve Qwen/Qwen3.5-0.8B --gpu-memory-utilization 0.5

# 64 GB Macs: the 27B hybrid
# vllm serve mlx-community/Qwen3.8-27B-4bit --gpu-memory-utilization 0.7

# Speculative decoding: Gemma 4 with its MTP assistant
# vllm serve google/gemma-4-E4B-it --gpu-memory-utilization 0.5 \
#   --max-model-len 16384 --no-async-scheduling \
#   --speculative-config '{"method":"mtp","model":"mlx-community/gemma-4-E4B-it-assistant-bf16","num_speculative_tokens":1}'
Xem ma trận mô hình để biết thêm các mô hình khác và hướng dẫn cài đặt cho các phương thức cài đặt khác.
Máy chủ sử dụng API OpenAI:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3.5-0.8B",
       "messages": [{"role": "user", "content": "Say hi"}]}'
Bất kỳ thứ gì chấp nhận URL cơ sở tương thích OpenAI đều có thể trỏ đến http://localhost:8000/v1, bao gồm cả các tác nhân lập trình (coding agents); tài liệu vLLM có đề cập đến thiết lập Claude Code và Codex.
Thiết lập ngân sách bộ nhớ có thể dự đoán được
Trình bảo vệ bộ nhớ của vllm-metal cho phép bạn đặt ngân sách suy luận bằng --gpu-memory-utilization, để lại khoảng trống cho macOS và các ứng dụng của bạn. Giống như vLLM gốc, nó chạy một lượt khởi động (warmup) để tính toán trọng số mô hình, các kích hoạt (activations) và bộ đệm tạm thời trước khi phân bổ ngân sách còn lại cho bộ nhớ đệm KV cố định. Nó cũng giới hạn bộ đệm có thể tái sử dụng của MLX để ngăn bộ nhớ tích tụ trong quá trình phục vụ. Các yêu cầu không vừa với vùng KV sẽ đợi cho đến khi có trang trống.
Truy vấn đóng gói và KV phân trang
Trong các lô có đệm (padded batches) của mlx_lm, các truy vấn attention có hình dạng [B, H, T_max, D]: mọi yêu cầu đều nhận được độ dài truy vấn dài nhất trong lô. scaled_dot_product_attention của MLX không có giao diện cho độ dài biến thiên (varlen).
vllm-metal duy trì bước mô hình thống nhất của vLLM V1 cho prefill theo đoạn và giải mã (decode). Nó đóng gói mọi token truy vấn đã lập lịch vào [total_q, H, D], với cu_seqlens đánh dấu ranh giới yêu cầu và chạy bước hỗn hợp trong một lần chuyển tiếp mô hình.
KV được tách biệt: mlx_lm giữ một bộ nhớ đệm [B, H, T, D] liên tục, trong khi vllm-metal lưu trữ KV trong các trang có kích thước cố định được định địa chỉ bởi bảng khối theo từng yêu cầu. Các yêu cầu được tiếp nhận có thể tăng lên mà không cần định hình lại bộ nhớ đệm có đệm.
Prefill và decode sử dụng các chiến lược tạo lô khác nhau:
| Engine | Prefill attention | Decode batching | KV |
|---|---|---|---|
| Lily | gọi theo từng prompt | yêu cầu đơn lẻ | liên tục |
| Uzu | gọi theo từng prompt | yêu cầu đơn lẻ | liên tục |
| oMLX | gọi theo từng prompt | theo lô | liên tục |
| Splash | gọi theo từng prompt | theo lô, tối đa 4 | phân trang |
| mlx_lm | có đệm | theo lô | liên tục |
| llama.cpp | mặt nạ trên các khe | theo lô + prefill | ô cố định |
| vllm-metal | đóng gói, cu_seqlens | theo lô + prefill | phân trang |
Prefill attention mô tả cách các truy vấn prompt đi vào kernel attention: riêng biệt, có đệm đến độ dài chung hoặc được nối lại. Decode batching xử lý nhiều yêu cầu trong một bước mô hình; “+ prefill” bao gồm các token prompt trong lô đó. KV mô tả lưu trữ logic: bộ đệm liên tục, ô token riêng lẻ hoặc khối token.
Trên Qwen3.6-35B-A3B ở định dạng 4-bit, chúng tôi đã so sánh các lô gồm tám yêu cầu với tổng cộng khoảng 6.000 token prompt và 20 token đầu ra mỗi yêu cầu. Lô A có độ dài prompt tương tự; lô B có một prompt dài hơn. Bảng báo cáo thời gian thực hiện lô tính bằng giây, với độ dài prompt được làm tròn.
| Lô | Token prompt | mlx_lm | oMLX | llama.cpp | vllm-metal |
|---|---|---|---|---|---|
| A | 750 × 8 | 4.52 | 7.32 | 5.29 | 3.87 |
| B | 3,000 + 430 × 7 | 10.99 | 7.22 | 5.33 | 3.64 |
| Thay đổi | +143% | −1% | +1% | −6% |
Việc đóng gói (packing) cũng giữ các tác vụ không đồng nhất trong cùng một lô. Trong một bước suy luận, một yêu cầu có thể đóng góp một token giải mã, một yêu cầu khác đóng góp token cuối cùng cộng với số lượng bản nháp cụ thể, và một yêu cầu khác đóng góp một đoạn prefill. Một tensor truy vấn [B, H, T_max, D] phải đệm các hàng đó về cùng một độ rộng hoặc chia nhỏ chúng qua các lần chuyển tiếp (forwards). Thay vào đó, vllm-metal nối các cửa sổ lại thành [total_q, H, D] và xác thực chúng trong một lần chuyển tiếp của mô hình mục tiêu.
Kernel Metal chuyển đổi kernel Triton thống nhất của vLLM, được mô tả trong Giải phẫu của một Triton Attention Kernel, sang các GPU của Apple, bao gồm cả việc tìm kiếm nhị phân mà mỗi threadgroup thực hiện trên cu_seqlens để xác định yêu cầu nào sở hữu token truy vấn của nó.
Phục vụ đồng thời dưới tải tác nhân (agent load)
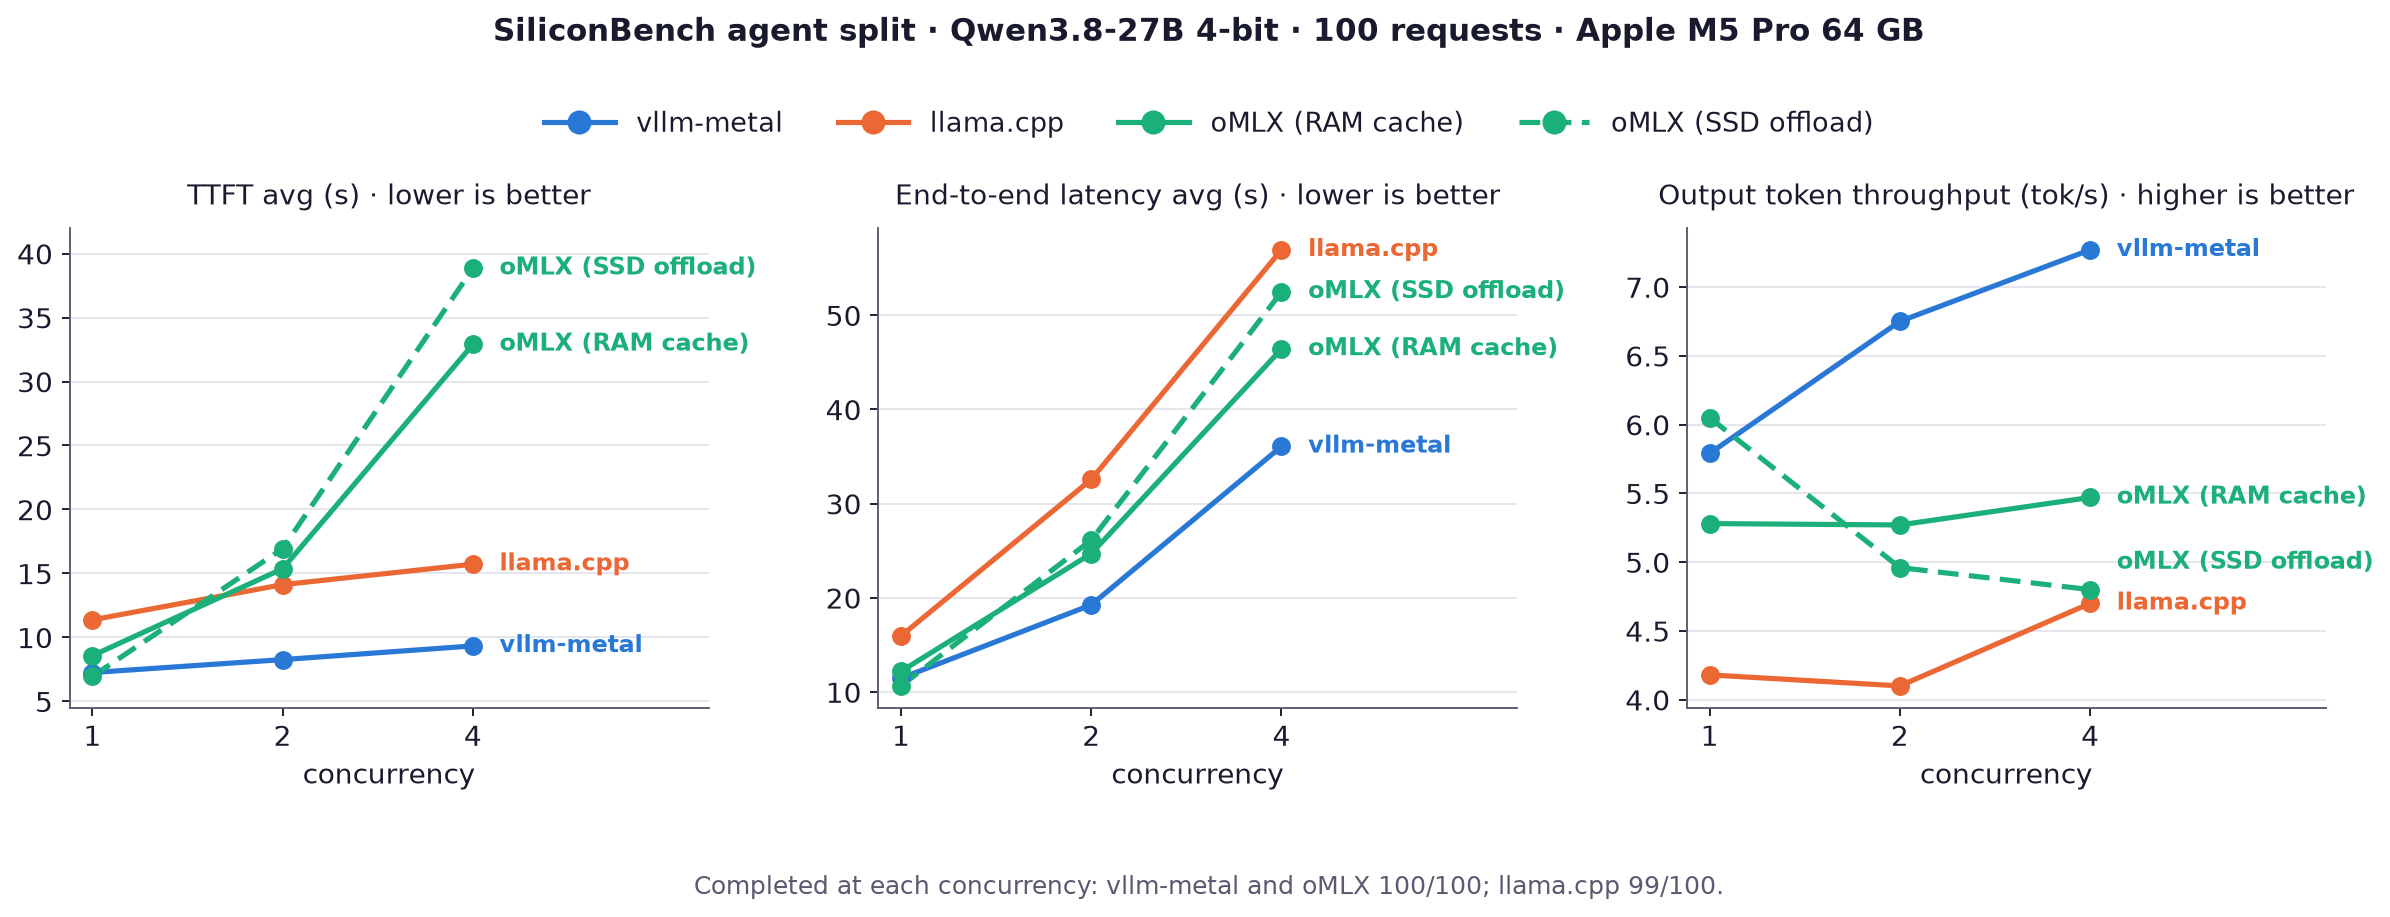
Nhiều tác nhân hoặc phiên lập trình có thể gửi yêu cầu mô hình cùng một lúc. Chúng tôi đã đo lường điều này với phân đoạn tác nhân của SiliconBench: 100 lời nhắc đa lượt với khoảng 4,6K token đầu vào mỗi lượt, trên một chiếc M5 Pro với 64 GB bộ nhớ. Cả ba so sánh mô hình đều sử dụng trọng số 4-bit.
Bài báo SiliconBench cung cấp đánh giá rộng hơn về chín công cụ phục vụ trên Apple Silicon, bao gồm tốc độ, mức sử dụng bộ nhớ và độ trung thực của đầu ra.
Mỗi mức độ đồng thời bắt đầu với một máy chủ mới. oMLX được hiển thị với bộ nhớ đệm SSD mặc định và bộ nhớ đệm chỉ dùng RAM; cả hai đều bắt đầu ở trạng thái trống. Phụ lục cung cấp các cấu hình phục vụ, và chú thích hình ảnh báo cáo số lượng hoàn thành.
Qwen3.8-27B
vllm-metal có TTFT và độ trễ end-to-end thấp nhất ở mức đồng thời 2 và 4. oMLX với SSD offload dẫn đầu ở mức đồng thời 1.
Gemma 4 E4B
Đối với Gemma 4 E4B, chúng tôi mở rộng phạm vi quét lên mức đồng thời 16 và bao gồm cả vllm-metal với trình soạn thảo MTP của nó.
vllm-metal giữ TTFT thấp trong suốt quá trình quét này. llama.cpp sử dụng bốn khe máy chủ mặc định của nó.
Qwen3.6-35B-A3B
Qwen3.6-35B-A3B có tổng cộng 35B tham số với 3B tham số hoạt động trên mỗi token. Nó kết hợp các lớp mixture-of-experts với attention tiêu chuẩn và gated-delta-net (GDN) linear attention.
Ở mức đồng thời 4, vllm-metal và oMLX với bộ nhớ đệm RAM có thông lượng và độ trễ end-to-end gần tương đương nhau, với khoảng cách lớn hơn về TTFT. Đường biểu diễn của mlx_lm chỉ bao gồm một phần nhỏ các yêu cầu mà nó đã hoàn thành.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ vLLM Blog chính thức. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.