Sản phẩm
Microsoft mã nguồn mở TauGrid: Giải pháp Kubernetes tối ưu cho khối lượng công việc AI trên GPU
(giờ Việt Nam)
Tóm tắt AI
Microsoft vừa ra mắt TauGrid, bộ công cụ mã nguồn mở giúp đơn giản hóa việc quản lý, điều phối và giám sát các tác vụ AI trên GPU trong môi trường Kubernetes chỉ với một lần cài đặt Helm.
Bản dịch AI
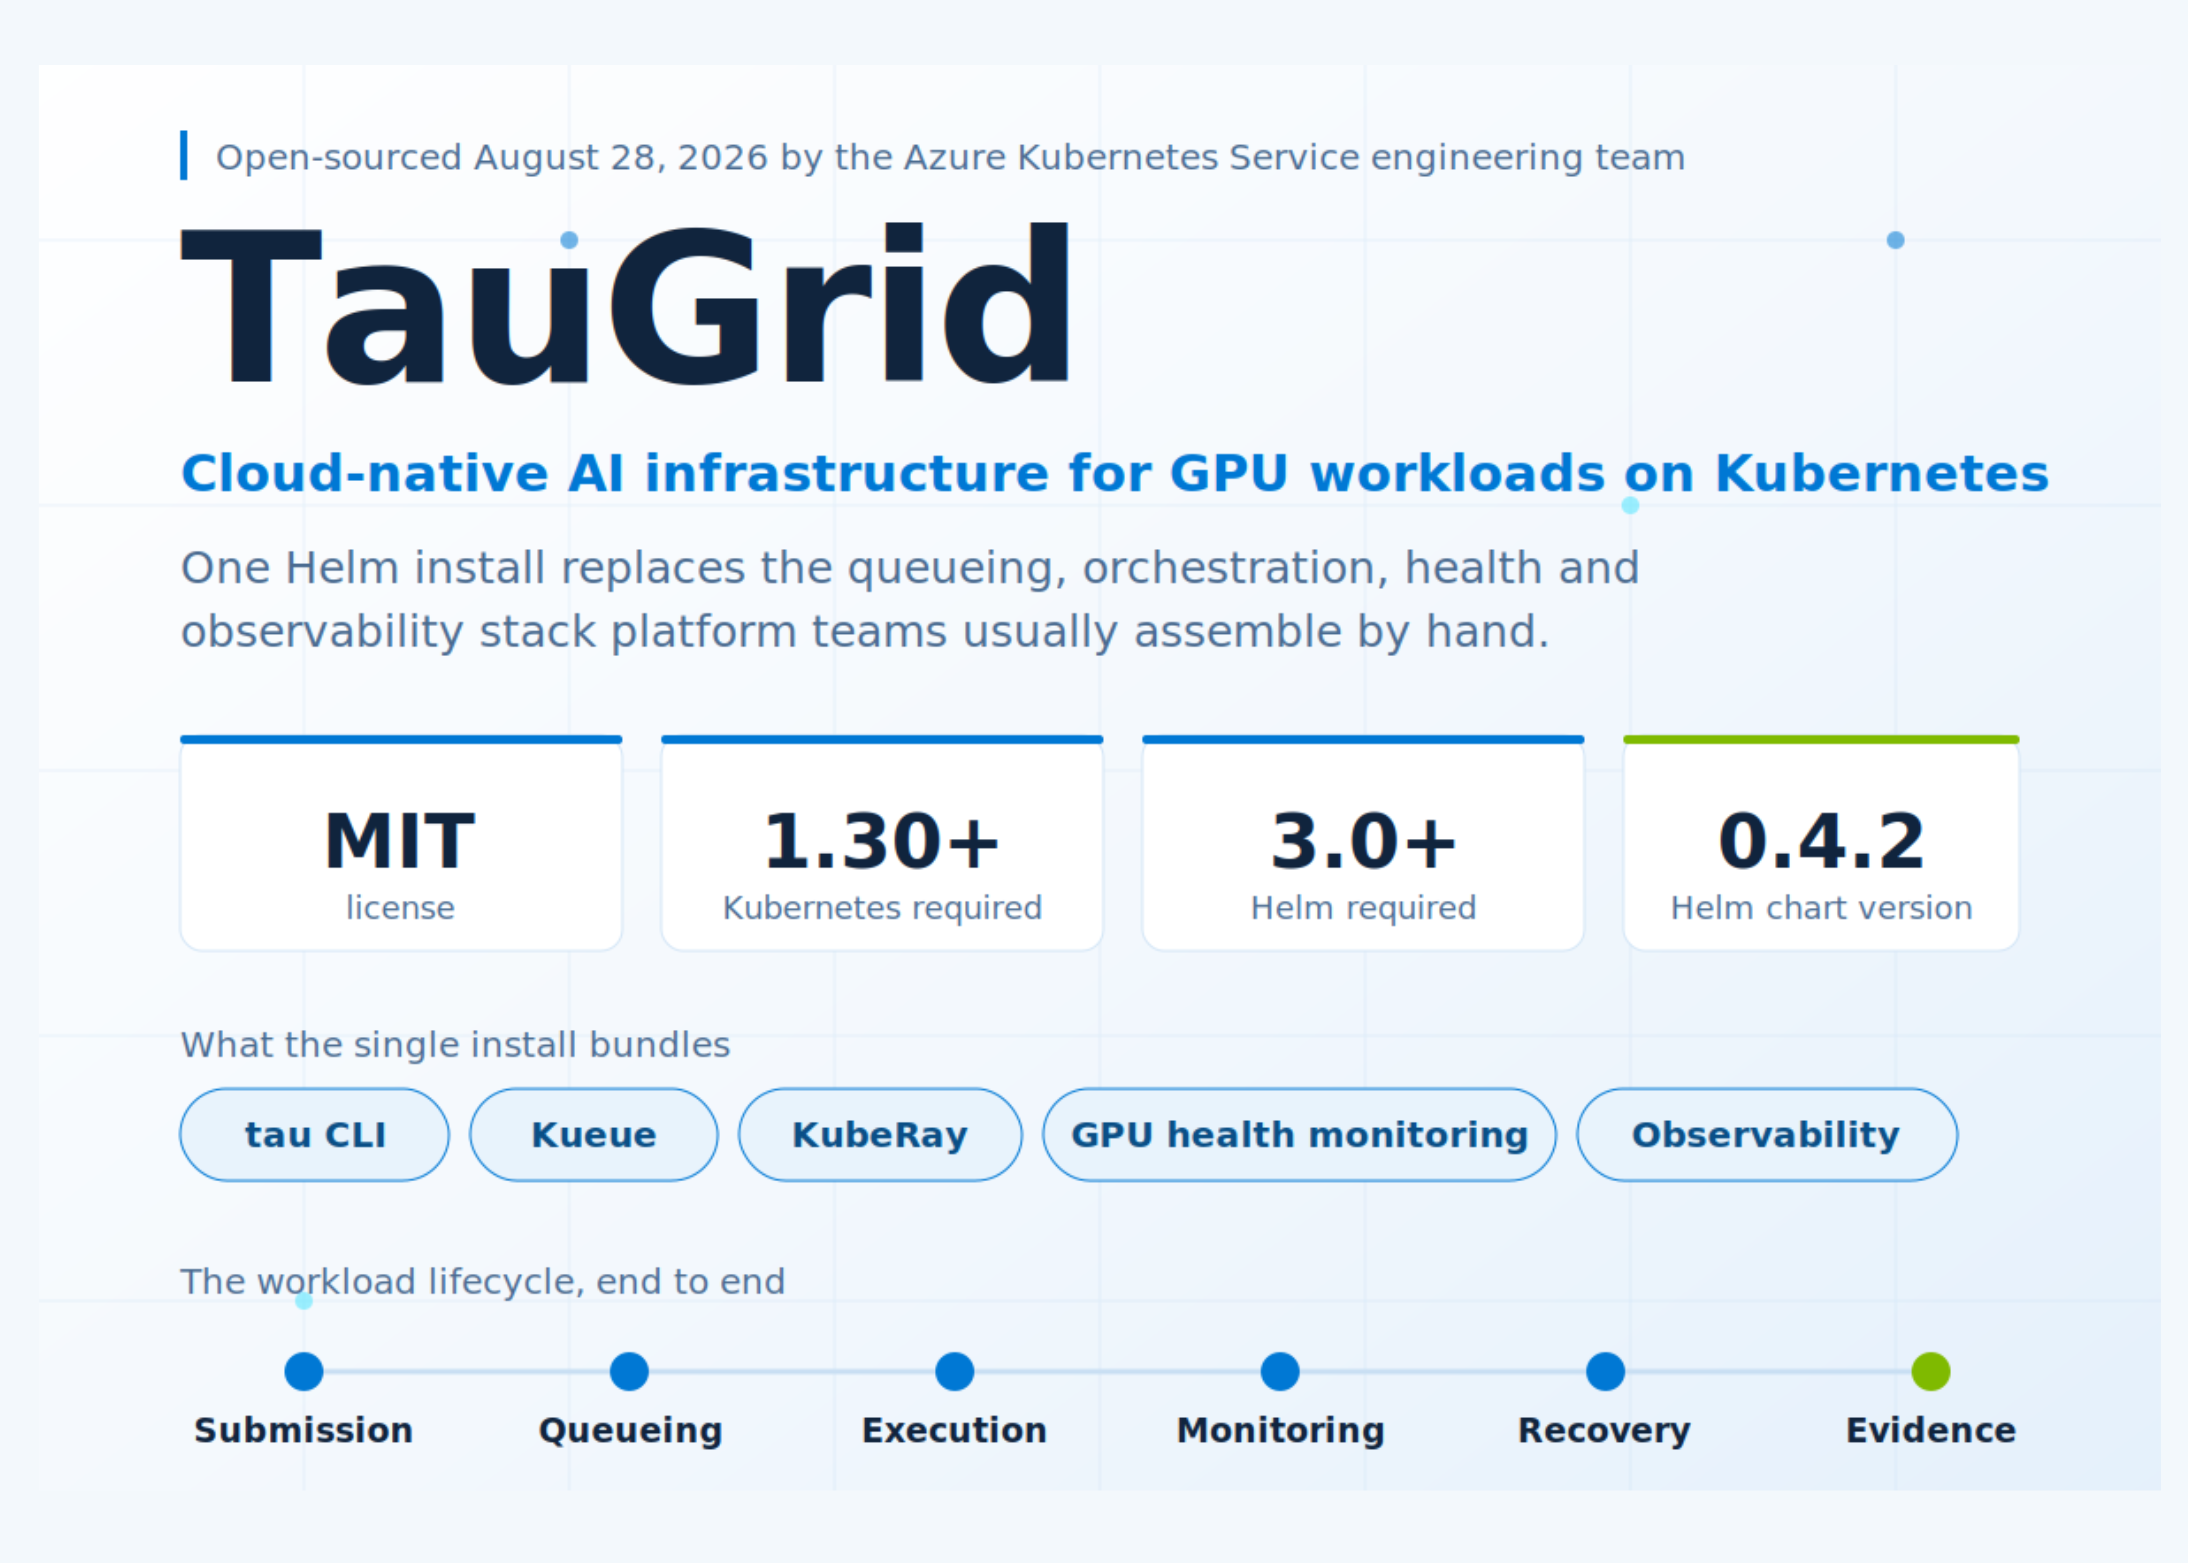
Các đội ngũ nền tảng (platform teams) vận hành AI trên Kubernetes hiếm khi chỉ chạy một tác vụ duy nhất. Họ phải vận hành một hệ thống hàng đợi, môi trường thực thi phân tán, kiểm tra sức khỏe node GPU, bảng điều khiển (dashboard) và một lớp các tập lệnh gửi tác vụ để kết nối tất cả lại với nhau. Đội ngũ kỹ thuật của Azure Kubernetes Service đã mã nguồn mở TauGrid, giúp đơn giản hóa toàn bộ công việc lắp ghép đó chỉ bằng một lần cài đặt Helm.
Nó có thể triển khai được không? Có, TauGrid được cấp phép theo giấy phép MIT, với các container image và Helm chart được xuất bản dưới dạng OCI artifact công khai trên Microsoft Container Registry. Các điều kiện tiên quyết bao gồm một cụm Kubernetes 1.30+ có các node GPU, kubectl và Helm 3.0 trở lên.
TauGrid là gì?
TauGrid là một nền tảng tự lưu trữ (self-hosted) để chạy các khối lượng công việc AI trên Kubernetes. Nó kết hợp năm thành phần mà các đội ngũ nền tảng thường phải tích hợp thủ công: CLI tau, hệ thống xếp hàng và tiếp nhận khối lượng công việc thông qua Kueue, điều phối cụm Ray thông qua KubeRay, giám sát sức khỏe GPU ở cấp độ node, và khả năng quan sát (observability) cụm cũng như khối lượng công việc.
Sự phân chia trách nhiệm là điểm mấu chốt trong thiết kế. Các đội ngũ nền tảng quản lý không gian làm việc (workspaces), hàng đợi, cấu hình tính toán, lưu trữ, định danh và khả năng quan sát. Các nhà nghiên cứu làm việc từ một kho lưu trữ và CLI, sau đó gửi khối lượng công việc mà không cần cấu hình trực tiếp trên Kubernetes. Cơ sở mã nguồn chủ yếu được viết bằng Go.
Cách một tác vụ vận hành trong hệ thống
Một khối lượng công việc được mô tả trong tệp tau.yaml. Ví dụ về huấn luyện GPU do Microsoft công bố chạy một tác vụ PyTorch trên một GPU A100 duy nhất:
Khi thực hiện lệnh tau run, TauGrid sẽ phân giải chính sách nền tảng, tạo ra một Kubernetes Job hoặc KubeRay RayJob, và gửi nó thông qua Kueue. Sáu giai đoạn mà Microsoft ghi lại bao gồm: gửi tác vụ, xếp hàng, thực thi, giám sát, phục hồi và lưu trữ bằng chứng. Phục hồi bao gồm việc thử lại, tiếp tục từ điểm kiểm tra (checkpoint) và chẩn đoán lỗi. Các bản ghi bằng chứng lưu lại siêu dữ liệu, cấu hình, nhật ký, số liệu, điểm kiểm tra và lịch sử thực thi của khối lượng công việc, giúp cho quá trình chạy có thể tái lập và kiểm toán sau này.
Khi nhiều đội ngũ cùng chia sẻ một cụm, các tác vụ của họ sẽ nằm trong một Kueue ClusterQueue chung. Kueue tiếp nhận từng tác vụ dựa trên hạn ngạch và mức độ ưu tiên, sau đó Kubernetes sẽ đặt chúng lên các GPU đang hoạt động ổn định.
Hướng dẫn tương tác
Dung lượng cài đặt
Việc cài đặt được thực hiện thông qua một Helm chart được tải trực tiếp từ MCR:
Các image chính chủ được cung cấp tại mcr.microsoft.com/aks/ai-runtime/ cho Tau, Cổng thông tin TauGrid và bộ điều khiển cốt lõi tau. Microsoft khuyến nghị nên ghim các phiên bản theo tag hoặc mã băm (digest) bất biến thay vì sử dụng latest. CLI được cài đặt từ GitHub Releases trên Linux và macOS, với trình cài đặt PowerShell cho Windows amd64; trình cài đặt sẽ xác minh checksum của bản phát hành và không sửa đổi biến môi trường PATH.
Có hai chi tiết vận hành quan trọng đối với bất kỳ ai đánh giá công cụ này bên ngoài Azure. Thứ nhất, theo mặc định, TauGrid không gửi dữ liệu đo từ xa (telemetry) cho Microsoft và tính năng xuất dữ liệu từ xa sẽ bị tắt trừ khi người vận hành cấu hình đích đến. Thứ hai, một số tích hợp vẫn còn đặc thù với Azure, đáng chú ý nhất là khả năng quan sát thông qua Azure Data Explorer. Mục tiêu được đặt ra là hỗ trợ Kubernetes trên đám mây và tại chỗ (on-premises) mà không phụ thuộc vào Azure, và các đóng góp cho mục tiêu này luôn được hoan nghênh.
Những điểm chính cần lưu ý
Hãy xem qua Blog Kỹ thuật AKS và Azure/taugrid trên GitHub. Mọi công lao đều thuộc về nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit ML 150k+ thành viên của chúng tôi cũng như đăng ký nhận Bản tin. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, Trang Hugging Face, Phát hành sản phẩm hoặc Hội thảo trực tuyến, v.v. của bạn? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng Truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy (machine learning) và học sâu (deep learning) một cách chuẩn xác về mặt kỹ thuật nhưng vẫn dễ hiểu đối với đông đảo công chúng. Nền tảng này tự hào với hơn 2 triệu lượt xem mỗi tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.