Ngành
Databricks: Kết nối dữ liệu và AI trong chuỗi giá trị sản xuất
(giờ Việt Nam)
Tóm tắt AI
Databricks giới thiệu giải pháp hợp nhất dữ liệu chuỗi giá trị sản xuất trên nền tảng Data and AI, giúp loại bỏ các quy trình ETL thủ công và truy vấn dữ liệu trực tiếp từ hệ thống nguồn thông qua kiến trúc Lakehouse.
Chính văn · Bản dịch AI
Một lỗi sản xuất hiếm khi chỉ thuộc về một hệ thống duy nhất. Sự gia tăng đột biến phế phẩm có thể liên quan đến cài đặt máy móc, lô hàng từ nhà cung cấp, sự cố logistics hoặc một vấn đề tái diễn đã được ghi lại trong hệ thống quản lý chất lượng. Tuy nhiên, dữ liệu cần thiết để điều tra vấn đề này thường bị phân mảnh giữa các nhà máy, các phòng ban chức năng và các hệ thống khác nhau.
Hơn 50 năm trước, tầm nhìn của Tiến sĩ Joseph Harrington về Sản xuất Tích hợp Máy tính (CIM) đã nhận ra rằng sản xuất phụ thuộc vào luồng thông tin kết nối xuyên suốt các chức năng. Ngày nay, tầm nhìn đó đang trở nên thực tế khi dữ liệu và AI kết nối các giai đoạn trong chuỗi giá trị sản phẩm.
Những câu hỏi khó nhất trong sản xuất là những câu hỏi liên quan đến nhiều giai đoạn:
- Lô hàng nào của nhà cung cấp đã được sử dụng cho các sản phẩm bị ảnh hưởng?
- Lỗi này đã từng xuất hiện trước đây chưa? Hành động khắc phục có hiệu quả không?
- Những khách hàng hoặc trường hợp dịch vụ nào có thể bị ảnh hưởng?
Để trả lời bất kỳ câu hỏi nào trong số này, cần phải kết nối dữ liệu từ các hệ thống vốn không được thiết kế để tương tác với nhau. Các nhà sản xuất không cần thêm những báo cáo rời rạc. Họ cần một luồng thông tin kết nối xuyên suốt chuỗi giá trị sản phẩm, đi kèm với quản trị và bối cảnh kinh doanh để biến thông tin đó thành hữu dụng. Đây là vai trò mà một Nền tảng Dữ liệu và AI hiện đại có thể đảm nhận.
Chuỗi giá trị sản phẩm trong sản xuất là gì?
Chuỗi giá trị sản phẩm là trình tự các chức năng từ đầu đến cuối, chuyển đổi nguyên liệu thô và ý tưởng thành sản phẩm được giao đến khách hàng và được hỗ trợ tại hiện trường. Nó kết nối nghiên cứu và phát triển (R&D) và kỹ thuật, thu mua, sản xuất và chất lượng, bán hàng và tiếp thị, cùng dịch vụ hậu mãi và hiện trường. Mỗi giai đoạn có mục tiêu, đội ngũ và hệ thống vận hành riêng:
- Nghiên cứu và phát triển (R&D) và kỹ thuật làm việc với Quản lý Vòng đời Sản phẩm (PLM), Thiết kế hỗ trợ bằng máy tính (CAD), Kỹ thuật hỗ trợ bằng máy tính (CAE) và mô phỏng, dữ liệu thử nghiệm, yêu cầu và Định mức nguyên vật liệu (BOM) kỹ thuật.
- Thu mua làm việc với hệ thống Hoạch định nguồn lực doanh nghiệp (ERP) về thu mua, quy trình từ nguồn đến thanh toán (source-to-pay), hợp đồng, rủi ro nhà cung cấp và cổng thông tin nhà cung cấp.
- Sản xuất và chất lượng làm việc với Hệ thống điều hành sản xuất (MES), dữ liệu Kiểm soát giám sát và thu thập dữ liệu (SCADA)/Bộ điều khiển logic lập trình được (PLC), hệ thống lưu trữ dữ liệu quy trình (process historians), Hệ thống quản lý chất lượng (QMS)/Hệ thống quản lý thông tin phòng thí nghiệm (LIMS) và các hệ thống bảo trì.
- Logistics và chuỗi cung ứng làm việc với Hoạch định nguồn lực doanh nghiệp (ERP), Hệ thống quản lý kho (WMS), Hệ thống quản lý vận tải (TMS), các hệ thống lập kế hoạch, Trao đổi dữ liệu điện tử (EDI) và viễn thông.
- Bán hàng và tiếp thị làm việc với Quản lý quan hệ khách hàng (CRM), Cấu hình-Giá-Báo giá (CPQ), định giá, quản lý đại lý, tự động hóa tiếp thị và thương mại điện tử.
- Hậu mãi và dịch vụ hiện trường làm việc với quản lý dịch vụ, bảo hành, lập kế hoạch phụ tùng dịch vụ, dữ liệu sản phẩm kết nối, chẩn đoán và hệ thống quản lý yêu cầu (tickets).
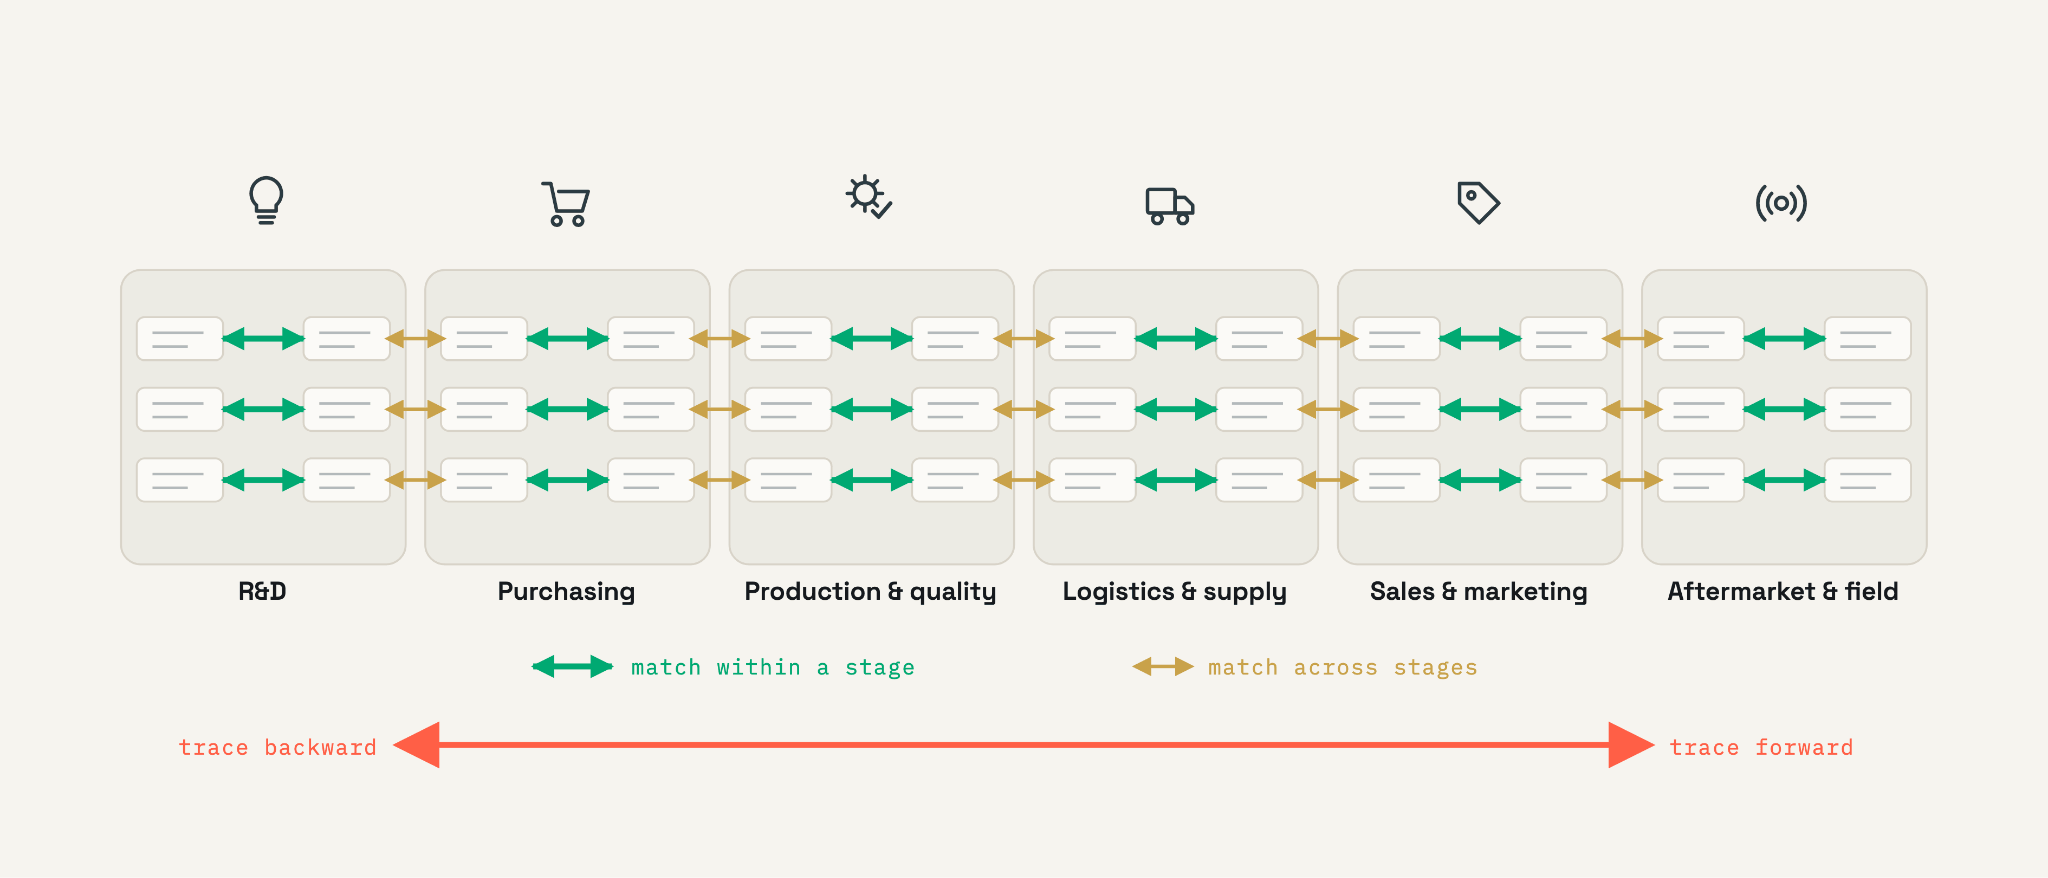
Mỗi giai đoạn tạo ra dữ liệu vận hành có giá trị. Cơ hội lớn hơn đến từ việc kết nối một phát hiện ở phần này của chuỗi với một hành động ở phần khác: một vấn đề chất lượng được tìm thấy trong sản xuất sẽ được điều tra thông qua hồ sơ logistics và nhà cung cấp, hoặc một cảnh báo từ nhà cung cấp sẽ được truy xuất đến mọi sản phẩm đã nhận vật liệu bị ảnh hưởng.
Tại sao ranh giới hệ thống lại là vấn đề thực sự
Khi mọi giai đoạn của chuỗi giá trị bị cô lập, một câu hỏi liên giai đoạn trở thành một dự án thủ công gồm các yêu cầu (tickets), xuất dữ liệu và đối chiếu. Khi dữ liệu có thể truy cập như một hệ thống được quản trị thống nhất, câu hỏi đó chỉ đơn giản là một truy vấn.
Ví dụ 1: Một kỹ sư chất lượng nhà máy cần trả lời ba câu hỏi:
- Sự gia tăng đột biến phế phẩm là do lô hàng, máy móc hay thiết lập, và nó có còn đang tiếp diễn không?
- Chúng ta đã từng thấy lỗi này trước đây chưa, và biện pháp khắc phục có hiệu quả không?
- Tại sao một nhà máy lại có tỷ lệ phế phẩm của cùng một linh kiện cao hơn hẳn nhà máy khác?
Mỗi câu hỏi bao trùm nhiều hệ thống: hồ sơ Hệ thống điều hành sản xuất (MES), dữ liệu từ hệ thống lưu trữ quy trình, dữ liệu nhà cung cấp và Quản lý chất lượng nhà cung cấp (SQM), lịch sử Hệ thống quản lý chất lượng (QMS), hồ sơ Tám kỷ luật (8D) và thường là nhiều thực thể nhà máy khác nhau. Ngày nay, để trả lời mỗi câu hỏi, người ta phải tạo yêu cầu, xuất dữ liệu thủ công và dựa vào một vài chuyên gia.
Ví dụ 2: Một chuyên viên phân tích thu mua cần trả lời ba câu hỏi:
- Những linh kiện quan trọng nào phụ thuộc vào một nhà cung cấp duy nhất hiện đang bị gắn cờ rủi ro giao hàng?
- Hiệu suất về chất lượng và thời gian giao hàng của một nhà cung cấp có đang giảm sút trong các đơn hàng gần đây không?
- Nếu một nhà cung cấp gặp sự cố, những sản phẩm, nhà máy và đơn hàng đang mở nào sẽ bị ảnh hưởng?
Mỗi câu hỏi bao trùm nhiều hệ thống: hồ sơ thu mua và quy trình từ nguồn đến thanh toán của Hoạch định nguồn lực doanh nghiệp (ERP), hợp đồng, nguồn cấp dữ liệu rủi ro nhà cung cấp và cổng thông tin nhà cung cấp. Ngày nay, để trả lời mỗi câu hỏi có thể trở thành một dự án nhỏ gồm các yêu cầu, kiến thức chuyên gia và xuất dữ liệu thủ công.
Việc tập hợp các nguồn dữ liệu vận hành đó sẽ loại bỏ sự ma sát này. Kết nối chuỗi giá trị lại một lần, quản trị nó một lần và sử dụng một định danh chung—số sê-ri, số lô hoặc mã linh kiện—làm khóa liên kết, và khả năng truy xuất nguồn gốc sẽ trở thành một truy vấn. Sáu câu hỏi, một nhu cầu cốt lõi: kết nối dữ liệu giữa các hệ thống vốn không được thiết kế để kết nối với nhau và tin tưởng vào kết quả. Bốn khả năng của nền tảng sẽ biến điều đó thành hiện thực.
Cách Databricks kết nối dữ liệu sản xuất
Không yêu cầu di chuyển dữ liệu gây gián đoạn
Một chuỗi giá trị kết nối không yêu cầu một cuộc di chuyển gây gián đoạn đối với mọi hệ thống nguồn. Dữ liệu có thể được sao chép khi đó là lựa chọn phù hợp, hoặc có thể giữ nguyên tại chỗ và vẫn có thể truy vấn được.
Với Chia sẻ mở không sao chép và Lakehouse Federation, các tổ chức có thể truy cập dữ liệu trong các hệ thống nguồn mà không cần tạo thêm đường ống trích xuất, chuyển đổi và tải (ETL) hoặc bản sao cho mỗi trường hợp sử dụng. Khi việc phản chiếu (mirroring) là phù hợp, các trình kết nối và lưu trữ đối tượng đám mây cung cấp một lộ trình có khả năng mở rộng để đưa dữ liệu vào lakehouse.
Nền tảng Dữ liệu và AI của Databricks mang lại sự linh hoạt này cùng với các khả năng mà các đội ngũ sản xuất cần: phân tích lịch sử trên dữ liệu sản xuất, chất lượng và cung ứng; xử lý độ trễ thấp cho dữ liệu đo từ xa của máy móc và phương tiện; và các ứng dụng có thể đọc và ghi các bản ghi riêng lẻ một cách nhanh chóng.
Bốn khả năng mà các ví dụ dựa vào
Tập hợp hoặc liên kết dữ liệu nguồn mà không cần di chuyển gây gián đoạn: Câu hỏi của kỹ sư chất lượng bao trùm các hồ sơ MES, lưu trữ quy trình, nhà cung cấp và SQM, QMS và 8D trên các thực thể nhà máy; câu hỏi của chuyên viên phân tích thu mua bao trùm thu mua ERP, hợp đồng và nguồn cấp dữ liệu rủi ro nhà cung cấp. Với Chia sẻ mở không sao chép và Lakehouse Federation, dữ liệu đó có thể được truy vấn tại chỗ và phản chiếu thông qua các trình kết nối khi sao chép là lựa chọn tốt hơn. Dù bằng cách nào, không cần thêm bản sao ETL mới cho mỗi câu hỏi.
Điều phối và tinh chỉnh: Cả hai ví dụ đều kết nối với các bảng vàng (gold tables) đã được quản trị, thay vì các bản trích xuất thô. Lakeflow giúp các đội ngũ xây dựng, lập lịch và giám sát các đường ống biến dữ liệu đầu vào thô thành dữ liệu đáng tin cậy, sẵn sàng cho phân tích, thường thông qua các lớp Bronze, Silver và Gold.
Quản trị dữ liệu và AI: Unity Catalog là mặt phẳng kiểm soát duy nhất cho dữ liệu được sao chép và liên kết: một mô hình cấp quyền, truy xuất nguồn gốc đầy đủ và khả năng khám phá bao trùm dữ liệu, mô hình và các AI agent, nhờ đó cùng một bề mặt được quản trị có thể giải đáp cho cả hai ví dụ. Unity Gateway cho phép bạn kiểm soát quyền truy cập, chi phí và khả năng quan sát AI trên các agent, công cụ, mô hình và MCP.
Khả năng của Agent: Được xây dựng trên nền tảng quản trị này, Genie One là một cộng sự AI kết nối với dữ liệu của bạn, Agent Bricks giúp xây dựng các AI agent dựa trên dữ liệu doanh nghiệp, và Genie App Builder cho phép bất kỳ ai cũng có thể tạo agent và ứng dụng bằng ngôn ngữ tự nhiên. Kỹ sư và chuyên viên phân tích có thể đặt câu hỏi bằng ngôn ngữ thông thường và nhận được câu trả lời dựa trên các định nghĩa mà doanh nghiệp công nhận, đây cũng là chủ đề của hai phần tiếp theo.
Nguyên tắc thiết kế thực tiễn rất đơn giản: tập hợp dữ liệu ở nơi tạo ra giá trị, liên kết dữ liệu ở nơi việc sao chép không hợp lý và quản trị cả hai thông qua cùng một mặt phẳng kiểm soát. Kết quả là một phương thức làm việc xuyên suốt các loại hình và giai đoạn dữ liệu sản xuất mà không cần tạo ra các kho dữ liệu biệt lập mới cho mỗi trường hợp sử dụng phân tích hoặc AI.
Nâng cao năng lực dữ liệu – làm cho dữ liệu trở nên hữu ích với nhiều người hơn là chỉ các chuyên gia
Giá trị của một nền tảng chỉ nằm ở những người có thể sử dụng nó. Trong nhiều tổ chức sản xuất, chỉ một nhóm nhỏ chuyên gia hiểu được các hệ thống đặc thù của nhà máy, trong khi người dùng nghiệp vụ phải chờ đợi các báo cáo hoặc dữ liệu xuất ra.
Năng lực dữ liệu phát triển khi mọi người có thể thực hiện theo một lộ trình thực tế: tìm kiếm dữ liệu liên quan, hiểu các định nghĩa đáng tin cậy, phân tích dữ liệu, đặt câu hỏi bằng ngôn ngữ tự nhiên, xây dựng các agent hoặc ứng dụng được quản trị và chia sẻ các tài sản đó với người khác. Không phải ai cũng cần trở thành kỹ sư dữ liệu mới có thể tham gia. Sự phát triển đó tuân theo sáu bước được trình bày dưới đây.

Công nghệ chỉ là một phần của sự thay đổi. Đào tạo, cộng đồng thực hành và mạng lưới những người tiên phong giúp mỗi bộ phận phát triển sự tự tin và chia sẻ các mô hình có thể tái sử dụng. Một bề mặt dữ liệu chung, được quản trị cung cấp cho các cộng đồng đó một nền tảng cụ thể để làm việc: các định nghĩa được chia sẻ, từ vựng chung và các câu trả lời có thể tái sử dụng giữa các nhóm.
Cách thức hoạt động của "Talk to Data" trong sản xuất (và lý do tại sao nó đòi hỏi ngữ nghĩa được quản trị)
Cách nhanh nhất để nâng cao năng lực dữ liệu là cho phép mọi người trò chuyện với dữ liệu của họ: không cần học ngôn ngữ truy vấn, không cần gửi yêu cầu hỗ trợ và không cần chờ đợi báo cáo. Phân tích bằng ngôn ngữ tự nhiên có thể hạ thấp rào cản tiếp cận dữ liệu, nhưng giao diện hội thoại là chưa đủ. Câu trả lời phải dựa trên các định nghĩa mà doanh nghiệp công nhận.
Ví dụ: Mua hàng
Một câu hỏi như “Những linh kiện quan trọng nào phụ thuộc vào một nhà cung cấp hiện đang bị gắn cờ rủi ro giao hàng?” có thể đòi hỏi kiến thức về các tiêu đề bảng, phép nối (join) và quy tắc nghiệp vụ đặc thù của SAP. Một chuyên viên phân tích mua hàng không nên cần phải trở thành chuyên gia dữ liệu mới có thể điều tra vấn đề này.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.