Tin ngành
AINews: 6 bản sao của Jev xuất hiện chỉ trong 2 ngày
(giờ Việt Nam)
Tóm tắt AI
Sự bùng nổ của các bản sao Jev chỉ sau 48 giờ cho thấy tốc độ sao chép công nghệ đáng kinh ngạc trong cộng đồng AI hiện nay.
Bản dịch AI
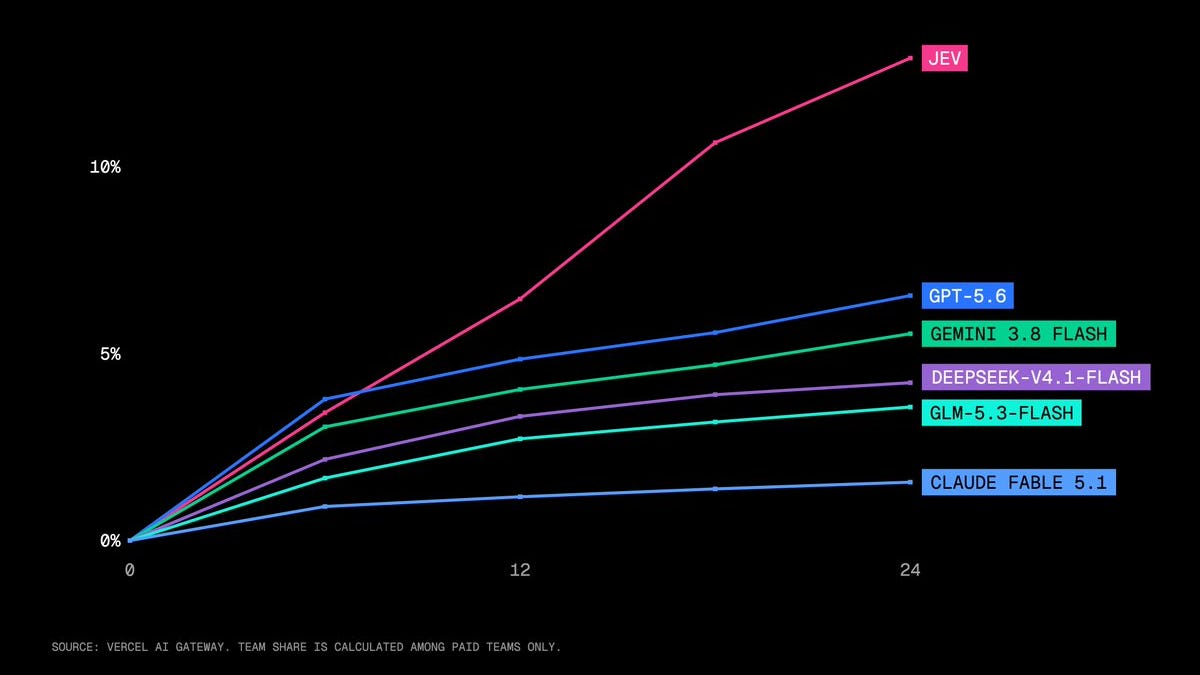
Chúng tôi đã đưa tin về sự kiện ra mắt của Jev vào thứ Tư, và họ đã hoàn toàn chiếm lĩnh dòng thời gian (timeline) với 36 triệu lượt xem video ra mắt chỉ trong hai ngày (để so sánh, kết quả Navier Stokes của OpenAI đạt 74 triệu lượt xem, và Fable 5 của Anthropic đạt 57 triệu lượt xem).

Vercel@vercel
Jev được áp dụng nhanh hơn bất kỳ mô hình nào khác trong lịch sử AI Gateway. Trong ngày đầu tiên, @typesafeai đã tiếp cận được khoảng 13% các nhóm, gấp 2 lần so với dòng GPT-5.6 và gấp 6 lần so với Fable 5.1.

10:34 Tối · 18 tháng 9, 2026 · 21,3 nghìn lượt xem
15 lượt trả lời · 18 lượt đăng lại · 220 lượt thích
Vì nó không phải là mã nguồn mở, nên nó đã khơi gợi vô số suy đoán, các bản demo và ví dụ tuyệt vời, những lời chỉ trích từ các "Schmidhuber" khó tính cùng những nhận định tiêu cực, điều này tất nhiên chỉ càng làm tăng thêm sự cường điệu.
Dưới đây là danh sách. Những dự đoán hợp lý nhất là ModernBert và Diffusion:
Laya: 421 triệu tham số, bộ mã hóa ModernBERT-large với hai lớp transformer bổ sung để chấm điểm các tùy chọn do người dùng cung cấp, sử dụng PPO trên các embedding chuỗi để xuất ra các quỹ đạo chuyển đổi từng bước (xác suất từ 0.0 đến 1.0).
khó chịu vì không được công nhận; tuyên bố RLCD mà không có bằng chứng xác đáng
độ tin cậy dựa trên entropy, không được hiệu chuẩn
DiffusionGemmaJev: tiếp cận vấn đề này từ nền tảng mô hình Diffusion. Khá sát với các kết quả benchmark.
Bespoke Nimble: Tinh chỉnh LoRA của Qwen3.5-9B, sử dụng phương pháp chọn lọc dữ liệu đối kháng (contrastive data curation). (gần đạt nhưng thấp hơn một chút trên các benchmark)
SemIf (trước đây là OpenJev) (HF): Backbone Qwen3.5 4B và 35B nhân quả (causal) với một bộ phân loại NLI ba lớp nhỏ trên token cuối cùng. So sánh với Laya.
Jevlike: Mô hình chú ý tùy chọn (option-attention) nhẹ với embedding 40K byte. Mỗi ứng viên trở thành một truy vấn đọc từ một biểu diễn ngữ cảnh chung, sau đó nhận được một điểm số.
Kev-0.5B: Bộ chuyển đổi LoRA + một đầu đọc nhỏ phía trên Qwen2.5-0.5B.
Tất nhiên, không có đủ người thảo luận về khía cạnh dữ liệu, vốn được thừa nhận là 100% tổng hợp (synthetic).
Tin tức AI từ 17/9/2026 đến 18/9/2026. Chúng tôi đã kiểm tra 12 subreddit, 544 tài khoản Twitter và không có thêm Discord nào khác. Trang web của AINews cho phép bạn tìm kiếm tất cả các số báo trước đây. Xin nhắc lại, AINews hiện là một phần của Latent Space. Bạn có thể chọn bật/tắt tần suất nhận email!
Mô hình quyết định, Định tuyến và Làn sóng "Jev"
Các mô hình phân biệt (discriminative models) đã nổi lên như một nguyên hàm hệ thống mới: Cuộc thảo luận kỹ thuật lớn nhất xoay quanh Jev, một mô hình quyết định phi tạo sinh (non-generative) được định vị là sự bổ sung "System 1" nhanh chóng cho các LLM. @ankrgyl cho biết nó hiện đã có sẵn dưới dạng mô hình đánh giá trong Braintrust với chi phí chấm điểm thấp hơn khoảng 400 lần so với các thiết lập trước đây, trong khi @gabepereyra nhấn mạnh các trường hợp sử dụng xác suất hiệu chuẩn như định tuyến, chọn trích dẫn, leo thang (escalation) và các quyết định vận hành pháp lý. Góc nhìn kiến trúc hơn đến từ @hxiao, người lập luận rằng Jev có thể kéo các tác vụ gọi công cụ, định tuyến và các quyết định theo kiểu MCP từ các LM tạo sinh nhỏ về phía các mô hình phân biệt; @signulll đã đẩy ý tưởng này đi xa hơn, định hình lớp này như một lớp phán đoán trên thiết bị với chi phí biên gần bằng không dành cho thông báo, tùy biến giao diện người dùng và các quyết định dựa trên cảm biến.
Các bản tái tạo mở và bản sao hệ sinh thái xuất hiện ngay lập tức: @madiator đã phát hành Bespoke Nimble, một công thức "Jev mở" được xây dựng từ tinh chỉnh LoRA của Qwen3.5-9B sử dụng phương pháp chọn lọc dữ liệu đối kháng tổng hợp và giải mã có ràng buộc. Trên bộ đánh giá được tuyển chọn của nó, Qwen cơ sở đã cải thiện từ 66% lên 90%, so với 93% của Jev, với hiệu suất được báo cáo là 100ms trên H100 và khả năng sử dụng cục bộ. Ở phân khúc nhỏ hơn, @jaredpalmer đã phát hành Kev-0.5B, một mô hình nhỏ giống Jev dựa trên Qwen2.5-0.5B có thể chạy trên MacBook Pro. Phản ứng chia làm hai luồng dựa trên kinh nghiệm trước đó: @MParakhin lưu ý rằng những người dùng sau thời ChatGPT coi nó như một sự khai sáng, trong khi những người làm ML trước thời GPT lại cảm thấy bối rối hơn trước sự cường điệu này. Câu hỏi thực chất do @abacaj đặt ra là hoàn toàn đúng đắn: rất nhiều bản demo nhấn mạnh vào tốc độ hơn là chất lượng, và vẫn chưa có tiêu chuẩn benchmark nào cho danh mục này.
Những tích hợp thuyết phục đầu tiên nằm trong các quy trình làm việc trên trình duyệt/máy tính: @levie đã demo Jev phân loại các báo cáo sự cố của Box vào các lộ trình leo thang; @ndrezn đã trình diễn việc sử dụng trình duyệt với LangChain + Jev và nhận thấy nó rất mạnh trong các tác vụ như trò chơi Wikipedia và các quy trình làm việc có cấu trúc như "gấp quần áo"; @cline đã phát hành một plugin cung cấp cho Jev một trình duyệt trong Cline. @hwchase17 đã gọi việc sử dụng trình duyệt là ứng dụng Jev tốt nhất mà anh ấy từng thấy cho đến nay. Tóm lại: điều này trông giống một câu chuyện về kiểm soát quy trình làm việc hơn là một câu chuyện về chatbot.
Công cụ cho Agent, Khung mã hóa (Coding Harnesses) và Tiêu chuẩn Claude Code
AGENTS.md đã tạo được động lực thực sự như một quy ước liên công cụ: Cập nhật sản phẩm có tín hiệu cao nhất ở đây là @trq212 thông báo rằng Claude Code v2.1.277 hiện kiểm tra AGENTS.md khi không có CLAUDE.md, với hỗ trợ chuyển đổi ở cấp cấu hình. Điều đó thực sự công nhận AGENTS.md như một tiêu chuẩn mới nổi thay vì chỉ là một quy ước cho một công cụ duy nhất, và @simonw ngay lập tức ghi nhận lợi ích thực tế: ít tệp shim hơn chỉ để trỏ định dạng này sang định dạng khác.
Thiết kế khung (Harness design) đang trở thành một biến số hạng nhất trong hiệu suất và chi phí của agent lập trình: @pidotdev đã làm nổi bật phân tích "Harness Tax" cho thấy rằng một bộ công cụ đơn giản—đọc, viết, chỉnh sửa, bash—có thể đạt đến biên Pareto về hiệu suất benchmark trong khi giảm chi tiêu không cần thiết. Liên quan đến điều này, @_akhaliq đã chỉ ra bài báo "An Empirical Study of Harness Design for Coding Agents", nhấn mạnh rằng kết quả benchmark ngày càng được định hình bởi cấu trúc khung, thiết lập ngữ cảnh, ngân sách lượt thực hiện và khả năng của công cụ thay vì chỉ là mô hình cơ sở. Điều này nhất quán với lập luận "nhà máy phần mềm" của @dexhorthy rằng các nhóm vẫn cần đọc mã và thiết kế có chủ đích giao diện giữa người và agent.
Lựa chọn mô hình trong các hệ thống phần mềm đang phân tách: Một số chuyên gia đã mô tả sự phân chia giữa "tiên phong cho lập kế hoạch, giá rẻ cho thực thi". @TheAhmadOsman tóm tắt một stack bao gồm GPT 5.6 Sol XHigh cho lập kế hoạch, GLM 5.3 Flash cho triển khai và DeepSeek V4.1 Flash cho các tác vụ khác. @kylebrussell báo cáo một đường ống tri thức nội bộ chuyển từ Opus → Sonnet → GLM 5.2 → GLM 5.3 Flash, cắt giảm chi tiêu khoảng hai bậc độ lớn kể từ mùa xuân. Trong khi đó, @theo lập luận rằng trong lập trình thực tế, lợi ích từ các mô hình mạnh hơn như Fable và Astra không chỉ là chất lượng mã, mà là sự gia tăng năng suất tinh tế hơn trong thực thi và lặp lại.
Benchmark, Tự cải thiện đệ quy (Recursive Self-Improvement) và Khả năng toán học
Thảo luận về RSI đã trở nên chính xác hơn về những gì thực sự là "đệ quy": @TheTuringPost đưa ra một phân loại hữu ích: AI cải thiện mã hoặc phương pháp đào tạo không tự thân nó là hoàn toàn đệ quy nếu vòng lặp cải thiện xung quanh vẫn cố định. Ngưỡng quan trọng là khi AI có thể sửa đổi không chỉ nội bộ mô hình, mà còn cả chiến lược tìm kiếm, tạo trải nghiệm, công cụ nghiên cứu và chính quy trình cải thiện. Khung đó liên kết tốt với cập nhật RSI-Exam của @HuaxiuYaoML, nơi GPT-6-astra vẫn đứng số 1 với 0.5126, Fable 5.1 đứng thứ 2 với 0.4813, và chưa có mô hình nào đạt đến tham chiếu chuẩn frontier-calibrated.
Các benchmark toán học tiếp tục bị các mô hình tiên phong chinh phục, nhưng cách diễn giải vẫn còn nhiều sắc thái: @EpochAIResearch báo cáo rằng một bài toán mở khác của FrontierMath đã được giải quyết trong một phiên tương tác với GPT-6 Astra. Riêng biệt, @SAIRfoundation đã ra mắt Open Math Model, giới thiệu các mô hình và công cụ mở cho toán học được định hình bởi cộng đồng nghiên cứu. Đối lập với câu chuyện "khả năng kiểm chứng giải thích sức mạnh toán học", @steve47285 đã chia sẻ lập luận rằng dữ liệu tiền huấn luyện, chứ không chỉ cấu trúc phần thưởng có thể kiểm chứng, mới là lý do chính khiến các LLM giỏi toán và lập trình. Điểm meta từ @sarahcat21 rất đáng lưu tâm: chúng ta cần không chỉ các benchmark tốt hơn, mà còn cần các công cụ bảo trì và kiểm toán benchmark tốt hơn.
Các benchmark sử dụng máy tính vẫn còn xa mới bão hòa: @ValsAI đã ra mắt CUA-Bench, kiểm tra việc sử dụng bàn phím/chuột thời gian thực trên 6 trò chơi (với 3 trò chơi được giữ kín) như một đại diện cho các tác vụ khó với con người nhưng dễ với máy. Các con số theo dõi từ @ValsAI cho thấy điều này vẫn thực sự khó: tất cả các mô hình tiên phong đều ghi điểm dưới 20%. Song song đó, @trycua đã mã nguồn mở CUA-S1-FORMS, mô hình đầu tiên trong một gia đình các mô hình sử dụng máy tính "System One" nhỏ. Hướng đi này rất đáng chú ý: các vòng lặp hành động thời gian thực, thích ứng dựa trên video và học tập liên tục, không chỉ là lập kế hoạch thuần văn bản.
Hạ tầng, Hệ thống đào tạo và Kiến trúc mô hình
Hạ tầng đào tạo ngữ cảnh dài và quy mô lớn vẫn là các mặt trận tối ưu hóa tích cực: @Azaliamirh đã phát hành Turbo-dLLM, một thư viện mã nguồn mở để đào tạo các LLM khuếch tán (diffusion LLMs) ở quy mô lớn, báo cáo tốc độ nhanh gấp 2,48 lần ở ngữ cảnh 512K và 7,59 lần ở ngữ cảnh 1M trên 8x H100 thông qua Context-Sharded Block Parallelism. Điều đó phù hợp với sự chú ý của các chuyên gia vào các chế độ triệu token: @andrew_n_carr đã ghi nhận sự gia tăng chất lượng mạnh mẽ ở DeepSeek V4.1 Flash sau khi mở rộng ngữ cảnh lên 1 triệu token, lập luận rằng các agent rất "đói" ngữ cảnh.
Các cuộc tranh luận về phân loại kiến trúc vẫn còn tồn tại: @ahatamiz1 lập luận rằng lĩnh vực này đang lạm dụng SSM làm nhãn cho bất kỳ mô hình tuyến tính nào. Đề xuất của ông là sử dụng RNN tuyến tính làm thuật ngữ bao trùm, với SSM là một phân họ, phân biệt các hệ thống như Mamba2 với họ GDN trên cơ sở rằng GDN hoạt động giống như một bước gradient trên hàm mất mát hồi quy cục bộ hơn là một ODE rời rạc. Đối với các kỹ sư theo dõi các lựa chọn thay thế mô hình chuỗi cho transformer, đây là một sự làm sạch danh pháp hữu ích thay vì chỉ là sự pedantry (cầu kỳ tiểu tiết).
Việc thực thi chương trình thần kinh cục bộ/cạnh (edge/local) cũng có một cập nhật đáng chú ý: @yuntiandeng mô tả ProgramAsWeights, nơi các nhà phát triển chỉ định một hàm AI bằng tiếng Anh, biên dịch nó một lần, sau đó chạy một chương trình thần kinh nhỏ cục bộ trên CPU khi tắt Wi-Fi. Mã và mô hình đều công khai. Điều này nằm ở vị trí thú vị gần với cuộc trò chuyện về Jev: cả hai đều hướng tới các artifact suy luận nhỏ hơn, chuyên biệt, có thể chạy cục bộ thay vì các mô hình chat phổ quát ngày càng lớn hơn.
Robotics, Thị giác, Âm thanh và Truyền thông tạo sinh
Các bản phát hành dữ liệu robotics mở có nội dung đặc biệt thực chất: @adamrasb đã công bố bản phát hành ABC đầy đủ, bao gồm mã, hơn 400 giờ dữ liệu mô phỏng trên 24 tác vụ và 5.850 tập đánh giá chính sách được dán nhãn. Trong một bài đăng đồng hành chi tiết hơn, @redstone_hong mô tả ABC-130K là tập dữ liệu điều khiển từ xa (teleop) mở lớn nhất cho đến nay: 3.500 giờ, hơn 130 nghìn tập, 195 tác vụ, được thu thập trên một thiết lập hai tay trị giá 8 nghìn đô la, với phần cứng mở, mã đào tạo, mô phỏng và đánh giá. Khoa học cơ sở bao gồm tương quan sim-to-real r = 0.91 về tiến độ tác vụ và các nghiên cứu về số liệu ngoại tuyến, luật mở rộng và điều kiện hóa.
Astra đang xuất hiện trên khắp các đánh giá và sản phẩm, đặc biệt là cho thị giác: @skalskip92 báo cáo GPT-6 Astra là mô hình thị giác mạnh nhất mà Roboflow đã thử nghiệm trên các tác vụ phát hiện, phân đoạn, gợi ý hộp, đếm, suy luận và video. Sự đánh đổi vẫn là đáng kể: cài đặt "nỗ lực cao" đã cải thiện khả năng phát hiện từ 82,1% lên 83,6% mAP@50 nhưng chi phí mỗi hình ảnh tăng gần gấp đôi từ 0,050 đô la lên 0,101 đô la và độ trễ từ 11 giây lên 32 giây (chi tiết). Roboflow cũng đã tích hợp Astra vào Auto Annotate.
Giọng nói và đồng bộ môi (lip-sync) đã có những bản phát hành benchmark mạnh mẽ: @ArtificialAnlys báo cáo Grok Voice Transcribe 2.0 đạt 2,7% WER trên các bản ghi phát trực tuyến cuối cùng ở 0,49 giây sau khi kết thúc giọng nói, cải thiện từ 3,9% so với phiên bản tiền nhiệm trong khi vẫn giữ giá ở mức 0,20 đô la/giờ phát trực tuyến và 0,10 đô la/giờ không phát trực tuyến. Về phía video, @fal đã ra mắt H3 Max Lip Sync, tuyên bố đứng số 1 về cả tốc độ và chất lượng trong các đánh giá của mình với thời gian tạo trung bình là 11 giây, và @isidentical cho biết mô hình này được xây dựng bằng cách đẩy RL khuếch tán vào một tác vụ đồng bộ môi có thể kiểm chứng.
Bài viết được AI dịch và tổng hợp tự động từ Latent Space. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.