Quan điểm
Học giả Princeton: Dự báo rủi ro diệt vong từ AI thiếu tin cậy để làm căn cứ chính sách
(giờ Việt Nam)
Tóm tắt AI
Các học giả từ Princeton cảnh báo rằng các con số ước tính rủi ro diệt vong (p(doom)) từ AI hiện nay thiếu cơ sở khoa học, gây nguy hiểm nếu dùng để hoạch định chính sách. Họ kêu gọi tập trung vào các vấn đề AI thực tế thay vì các suy đoán mang tính giả thuyết.
Chính văn · Bản dịch AI
Hơn hai năm trước, chúng tôi đã viết một bài phân tích chi tiết về p(doom) và lập luận rằng tác dụng chính của nó là hợp thức hóa những trực giác và nỗi sợ mơ hồ thông qua vỏ bọc định lượng. Bài luận này vẫn còn nguyên tính thời sự ngày nay khi các luận điệu về p(doom) đang thúc đẩy diễn ngôn công chúng và sự chú ý của chính sách ở mức độ chưa từng có. Không có gì ngạc nhiên khi các ước tính xác suất về rủi ro hiện hữu của AI ngày nay cũng chẳng hề chặt chẽ hơn so với những ước tính từ năm 2024. Do đó, chúng tôi đăng lại bài viết này.
Chúng ta cần làm rõ những điều chúng tôi không nói.
- Chúng tôi không nói rằng các nhà dự báo (hay những người cố gắng định lượng rủi ro hiện hữu của AI - AI x-risk) có ý định gây hiểu lầm. Thật không may, chúng tôi cho rằng kết quả mang lại vẫn gây hiểu lầm.
- Nhìn chung, việc định lượng các dự báo là điều tốt. Trên thực tế, Arvind đã và đang đóng vai trò cố vấn cho Longitudinal Expert AI Panel của Viện Nghiên cứu Dự báo (Forecasting Research Institute), một nỗ lực mà ông cho là cực kỳ giá trị. Như bài luận đã làm rõ, tính bất khả thi trong việc xây dựng các mô hình định lượng hữu ích chỉ đặc thù đối với các dự báo về AI x-risk, chứ không phải đối với dự báo nói chung.
- Mục tiêu của chúng tôi ở đây không phải là cố gắng thúc ép những người ủng hộ an toàn AI ngừng giao tiếp bằng các thuật ngữ xác suất (ngay cả khi cố gắng, chúng tôi cũng không thành công). Thay vào đó, hy vọng của chúng tôi khi xuất bản bài viết này là để những người tiếp nhận các xác suất này — đặc biệt là các nhà hoạch định chính sách — nhận ra rằng, không giống như hầu hết các dự báo định lượng khác mà chúng ta gặp phải, chúng không phải là kết quả của một mô hình hoặc phương pháp đã được kiểm chứng.
Mặc dù vậy, chúng tôi cho rằng toàn bộ văn hóa p(doom) là biểu tượng cho một quan điểm cụ thể về an toàn AI, vốn tập trung vào rủi ro hiện hữu và siêu trí tuệ theo cách gây phản tác dụng đối với một khái niệm an toàn rộng lớn hơn. Trong vài ngày tới, chúng tôi sẽ xuất bản một bài luận tiếp theo để đưa ra lập luận đó và ủng hộ một phong trào an toàn "cởi mở" (big tent).
Bài luận gốc xuất hiện bên dưới.
Các chính phủ nên coi trọng mối đe dọa về rủi ro hiện hữu từ AI đến mức nào, khi mà các nhà nghiên cứu vẫn thiếu sự đồng thuận? Một mặt, các rủi ro hiện hữu (x-risks) tất yếu mang tính suy đoán: đến khi có bằng chứng cụ thể thì có lẽ đã quá muộn. Mặt khác, các chính phủ phải ưu tiên — suy cho cùng, họ không quá lo lắng về rủi ro hiện hữu từ các cuộc xâm lăng của người ngoài hành tinh.
Cộng đồng an toàn AI dựa rất nhiều vào việc dự báo xác suất tuyệt chủng của nhân loại do AI (trong một khung thời gian nhất định) để cung cấp thông tin cho việc ra quyết định và chính sách. Ví dụ, một ước tính 10% trong vài thập kỷ rõ ràng là đủ cao để vấn đề này trở thành ưu tiên hàng đầu của xã hội.
Luận điểm chính của chúng tôi là các dự báo về AI x-risk quá thiếu tin cậy để có thể hữu ích cho chính sách, và trên thực tế là gây hiểu lầm nghiêm trọng.
Nếu hai chúng tôi dự đoán xác suất 80% người ngoài hành tinh sẽ đổ bộ xuống Trái đất trong mười năm tới, liệu bạn có coi trọng khả năng này không? Tất nhiên là không. Bạn sẽ yêu cầu xem bằng chứng của chúng tôi. Dù điều này có vẻ hiển nhiên, nhưng dường như nó đã bị lãng quên trong cuộc tranh luận về AI x-risk rằng các xác suất tự thân chúng không mang lại thẩm quyền. Xác suất thường được rút ra từ một phương pháp có cơ sở, vì vậy chúng ta có xu hướng nhận thức sai lệch mạnh mẽ khi coi các ước tính rủi ro định lượng là hợp lệ hơn các ước tính định tính. Nhưng hoàn toàn có khả năng các xác suất đó chẳng là gì ngoài những phỏng đoán. Hãy ghi nhớ điều này trong suốt bài luận này (và rộng hơn là trong cuộc tranh luận về AI x-risk).
Nếu chúng tôi dự đoán tỷ lệ cược cho giải đua ngựa Kentucky Derby, chúng tôi không cần đưa ra lý do — bạn có thể chấp nhận hoặc bỏ qua. Nhưng nếu một nhà hoạch định chính sách thực hiện các hành động dựa trên xác suất do một nhà dự báo đưa ra, họ tốt hơn hết là phải có khả năng giải thích những xác suất đó cho công chúng (và lời giải thích đó phải đến từ chính nhà dự báo). Sự biện minh là yếu tố thiết yếu đối với tính chính danh của chính phủ và việc thực thi quyền lực. Một nguyên tắc cốt lõi của nền dân chủ tự do là nhà nước không nên hạn chế quyền tự do của người dân dựa trên những niềm tin gây tranh cãi mà những người có lý trí có thể bác bỏ.
Giải thích đặc biệt quan trọng khi các chính sách đang được xem xét gây tốn kém, và thậm chí còn quan trọng hơn khi những chi phí đó được phân bổ không đồng đều giữa các bên liên quan. Một ví dụ điển hình là việc hạn chế phát hành công khai các mô hình AI. Liệu các chính phủ có thể thuyết phục những người và công ty được hưởng lợi từ các mô hình mở rằng họ nên hy sinh vì một rủi ro tương lai mang tính suy đoán?
Mục đích chính của bài luận này là phân tích xem liệu có bất kỳ sự biện minh nào cho bất kỳ ước tính xác suất x-risk cụ thể nào đã được trích dẫn trong cuộc tranh luận chính sách hay không. Chúng tôi không phản đối việc dự báo AI x-risk như một hoạt động học thuật, và các dự báo có thể hữu ích cho các công ty và những người ra quyết định tư nhân khác. Chúng tôi chỉ đặt câu hỏi về việc sử dụng nó trong bối cảnh chính sách công.
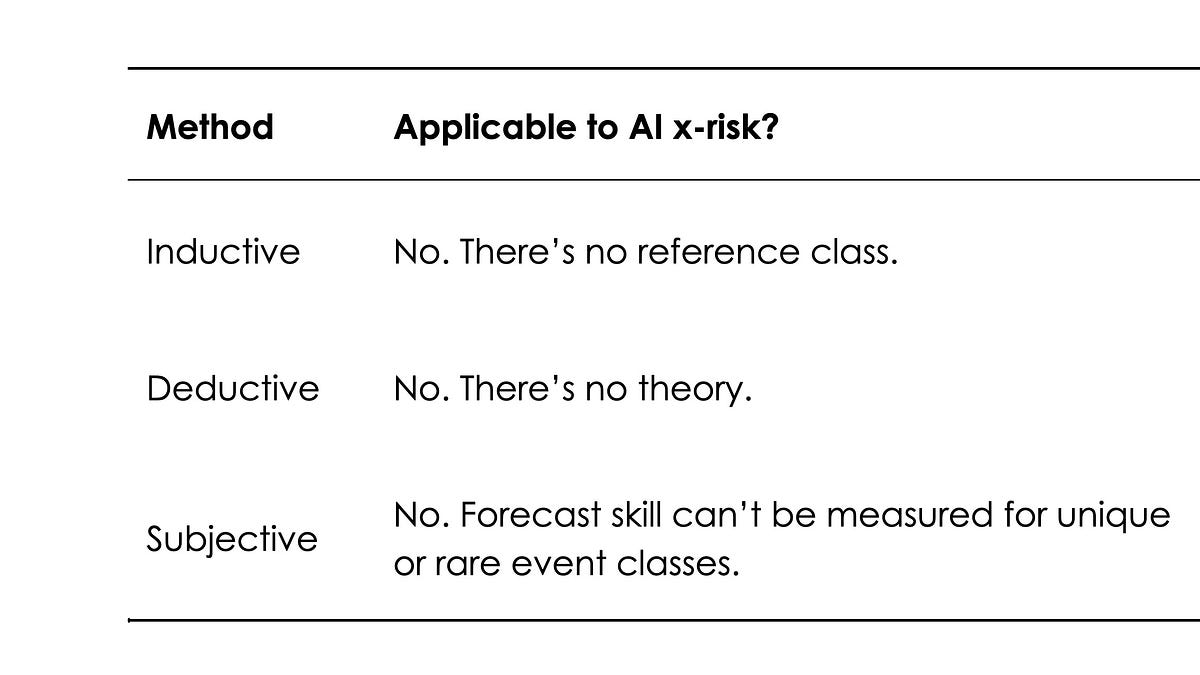
Về cơ bản chỉ có ba cách đã biết mà một nhà dự báo có thể cố gắng thuyết phục người hoài nghi: ước tính xác suất quy nạp, diễn dịch và chủ quan. Chúng tôi xem xét từng cách trong các phần sau. Cả ba đều yêu cầu các bên đồng ý về một số giả định cơ bản về thế giới (bản thân chúng không thể chứng minh được). Ba phương pháp này khác nhau về cách thức thực nghiệm và logic mà theo đó ước tính xác suất được rút ra từ tập hợp các giả định đó.
Hầu hết các ước tính rủi ro đều mang tính quy nạp: chúng dựa trên các quan sát trong quá khứ. Ví dụ, các công ty bảo hiểm dựa trên dữ liệu từ các vụ tai nạn trong quá khứ của những người lái xe tương tự để dự đoán rủi ro tai nạn xe hơi của một cá nhân. Tập hợp các quan sát được sử dụng để ước tính xác suất được gọi là lớp tham chiếu (reference class). Một lớp tham chiếu phù hợp cho bảo hiểm xe hơi có thể là tập hợp những người lái xe sống cùng thành phố. Nếu nhà phân tích có thêm thông tin về cá nhân đó, chẳng hạn như tuổi tác hoặc loại xe họ lái, lớp tham chiếu có thể được tinh chỉnh thêm.
Đối với rủi ro hiện hữu từ AI, không có lớp tham chiếu nào, vì đó là một sự kiện không giống bất kỳ sự kiện nào khác. Cần làm rõ rằng đây là vấn đề về mức độ, không phải về bản chất. Không bao giờ có một lớp tham chiếu "đúng" rõ ràng để sử dụng, và việc lựa chọn lớp tham chiếu trong thực tế phụ thuộc vào trực giác của nhà phân tích.
Độ chính xác của các dự báo phụ thuộc vào mức độ tương đồng giữa quá trình tạo ra sự kiện được dự báo và quá trình tạo ra các sự kiện trong lớp tham chiếu, vốn có thể được xem như một phổ. Để dự đoán kết quả của một hệ thống vật lý như tung đồng xu, kinh nghiệm quá khứ là một hướng dẫn có độ tin cậy cao. Tiếp theo, đối với tai nạn xe hơi, các ước tính rủi ro có thể thay đổi khoảng 20% dựa trên tập dữ liệu quá khứ được sử dụng — đủ tốt cho các công ty bảo hiểm.
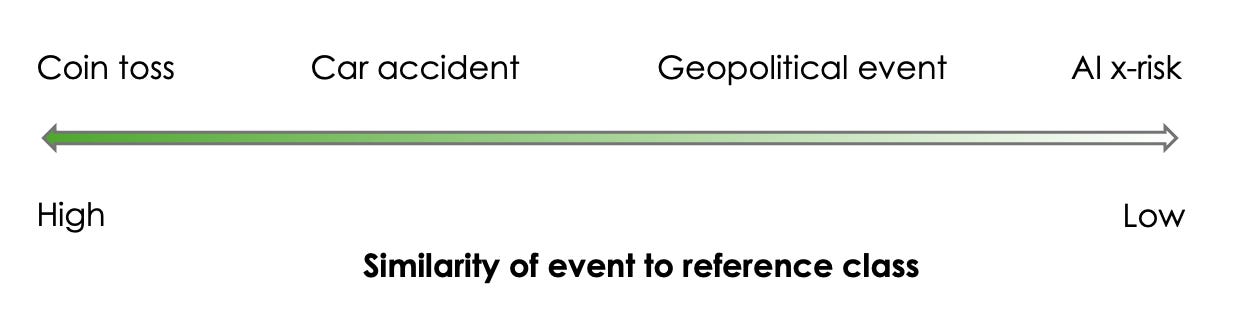
Xa hơn trên phổ này là các sự kiện địa chính trị, nơi việc lựa chọn lớp tham chiếu trở nên mơ hồ hơn nữa. Chuyên gia dự báo Philip Tetlock giải thích: “Grexit có vẻ là một trường hợp độc nhất vô nhị (sui generis), vì chưa có quốc gia nào rời khỏi Eurozone tính đến năm 2015, nhưng nó cũng có thể được xem là một ví dụ khác của một lớp so sánh rộng hơn, chẳng hạn như các thất bại trong đàm phán, hoặc một lớp hẹp hơn, như các quốc gia rút khỏi các thỏa thuận quốc tế, hoặc hẹp hơn nữa là các vụ cưỡng ép chuyển đổi tiền tệ.” Ông tiếp tục bảo vệ quan điểm rằng ngay cả những sự kiện Thiên nga đen tưởng chừng như sự sụp đổ của Liên Xô hay Mùa xuân Ả Rập cũng có thể được mô hình hóa như các thành viên của các lớp tham chiếu, và rằng suy luận quy nạp vẫn hữu ích ngay cả đối với loại sự kiện này.
Trong phổ của Tetlock, những sự kiện này đại diện cho “đỉnh cao” của tính độc nhất. Khi nói đến các sự kiện địa chính trị, điều đó có thể đúng. Nhưng ngay cả những sự kiện đó cũng ít độc nhất hơn nhiều so với sự tuyệt chủng do AI. Chỉ cần nhìn vào các nỗ lực tìm kiếm lớp tham chiếu cho rủi ro hiện hữu (x-risk) từ AI: sự tuyệt chủng của động vật (như một lớp tham chiếu cho sự tuyệt chủng của con người), các biến đổi toàn cầu trong quá khứ như cách mạng công nghiệp (như một lớp tham chiếu cho sự biến đổi kinh tế xã hội từ AI), hoặc các tai nạn gây thương vong hàng loạt (như một lớp tham chiếu cho các tai nạn gây thảm họa toàn cầu). Hãy thực tế đi. Không điều nào trong số đó cho chúng ta biết bất cứ điều gì về khả năng phát triển AI siêu thông minh hoặc mất kiểm soát đối với AI đó, vốn là những nguồn gốc chính gây ra sự không chắc chắn cho việc dự báo rủi ro hiện hữu từ AI.
Tóm lại, sự tuyệt chủng của con người do AI là một kết quả quá xa vời so với bất cứ điều gì đã xảy ra trong quá khứ đến mức chúng ta không thể sử dụng các phương pháp quy nạp để “dự đoán” xác suất. Tất nhiên, chúng ta có thể rút ra những hiểu biết định tính từ các đột phá kỹ thuật trong quá khứ cũng như các sự kiện thảm khốc trước đây, nhưng rủi ro từ AI khác biệt đến mức các ước tính định lượng thiếu đi sự biện minh cần thiết để có tính chính danh trong việc hoạch định chính sách.
Trong tác phẩm The Adventure of the Six Napoleons của Conan Doyle — cảnh báo tiết lộ nội dung! — Sherlock Holmes tuyên bố trước khi bắt đầu theo dõi rằng xác suất bắt được nghi phạm chính xác là hai phần ba. Điều này có vẻ khó hiểu — làm thế nào bất cứ điều gì liên quan đến hành vi con người lại có thể được gán cho một xác suất chính xác về mặt toán học?
Hóa ra Holmes đã suy luận ra chuỗi sự kiện cơ bản dẫn đến hành vi quan sát được có vẻ thất thường của nghi phạm: nghi phạm đang tìm kiếm một cách có phương pháp một viên ngọc được biết là giấu bên trong một trong sáu bức tượng bán thân của Napoleon thuộc sở hữu của những người khác nhau ở London và vùng phụ cận. Các chi tiết không quá quan trọng, nhưng mấu chốt là cả nghi phạm lẫn các thám tử đều không biết nó nằm trong bức tượng nào trong sáu bức tượng đó, và mọi thứ khác về hành vi của nghi phạm đều (được giả định là) hoàn toàn có thể dự đoán được. Do đó, sự không chắc chắn có thể định lượng một cách chính xác.
Vấn đề là nếu chúng ta có một mô hình về thế giới mà chúng ta có thể dựa vào, chúng ta có thể ước tính rủi ro thông qua suy luận logic, ngay cả khi không dựa vào các quan sát trong quá khứ. Tất nhiên, bên ngoài các kịch bản hư cấu, thế giới không gọn gàng như vậy, đặc biệt là khi chúng ta muốn dự phóng xa vào tương lai.
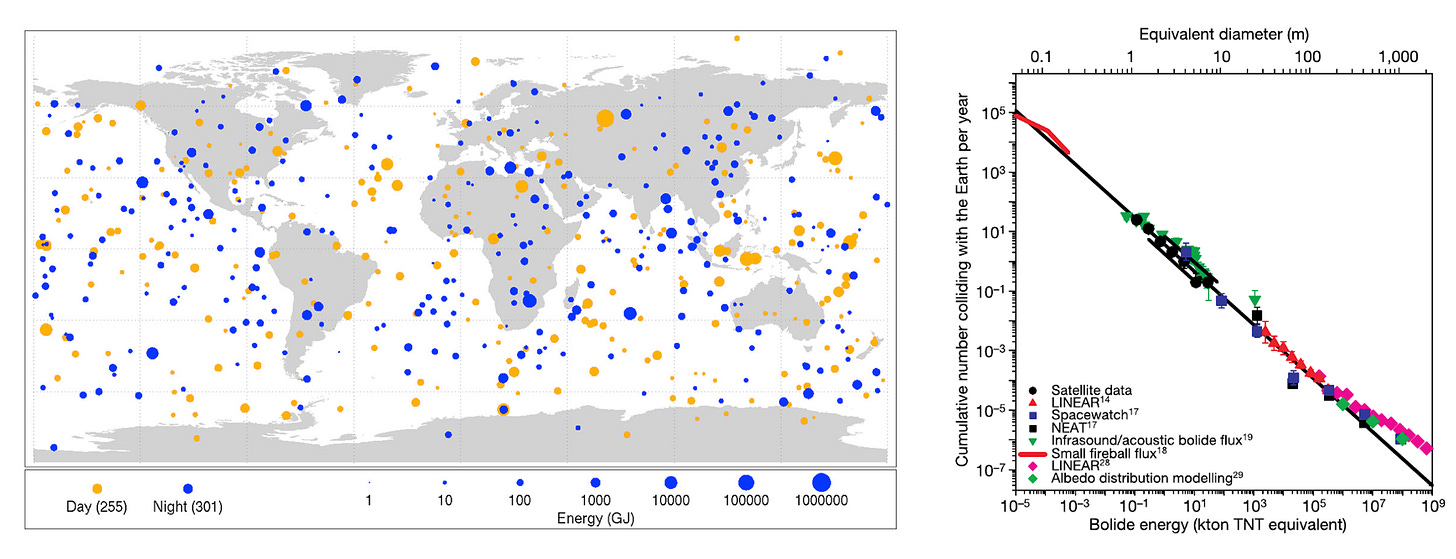
Khi nói đến rủi ro hiện hữu (x-risk), có một ngoại lệ thú vị đối với quy tắc chung rằng chúng ta không có các mô hình suy diễn — đó là va chạm tiểu hành tinh. Sự kết hợp giữa ước tính rủi ro quy nạp và suy diễn cho phép chúng ta ước tính xác suất của rủi ro hiện hữu, chỉ vì chúng ta đang nói về một hệ thống vật lý thuần túy. Hãy dành một phút để xem xét cách thức này hoạt động, vì điều quan trọng là phải nhận ra rằng các phương pháp này không thể khái quát hóa cho các loại rủi ro hiện hữu khác.
Chìa khóa nằm ở khả năng mô hình hóa mối quan hệ giữa kích thước của tiểu hành tinh (chính xác hơn là năng lượng va chạm) và tần suất va chạm. Vì chúng ta đã quan sát hàng ngàn vụ va chạm nhỏ, chúng ta có thể ngoại suy để suy ra tần suất của các vụ va chạm lớn chưa từng được quan sát trực tiếp. Chúng ta cũng có thể ước tính ngưỡng gây ra thảm họa toàn cầu.
Với AI, các ẩn số liên quan đến tiến bộ công nghệ và quản trị thay vì một hệ thống vật lý, vì vậy không rõ làm thế nào để mô hình hóa nó một cách toán học. Tuy nhiên, mọi người đã thử. Ví dụ, để dự đoán các yêu cầu tính toán của một AGI giả định, một vài công trình giả định rằng một hệ thống AI sẽ yêu cầu số lượng tính toán tương đương với não người, và tiếp tục đưa ra các giả định về số lượng tính toán mà não người yêu cầu. Những giả định này mong manh hơn nhiều so với những giả định liên quan đến mô hình hóa tiểu hành tinh, và không điều nào trong số đó giải quyết được câu hỏi về việc mất kiểm soát.
Nếu không có các lớp tham chiếu hoặc lý thuyết có căn cứ, các dự báo nhất thiết phải là “xác suất chủ quan”, nghĩa là những phỏng đoán dựa trên sự đánh giá của người dự báo. Không có gì ngạc nhiên khi các con số này thay đổi theo các bậc độ lớn.
Ước tính xác suất chủ quan không giải quyết được nhu cầu phải có cơ sở quy nạp hoặc suy diễn cho các ước tính xác suất. Nó chỉ đơn giản là tránh việc người dự báo phải giải thích ước tính của họ. Việc giải thích có thể khó khăn do khả năng hạn chế của con người trong việc giải thích lý luận trực giác của chính mình, dù là quy nạp, suy diễn hay kết hợp cả hai. Về cơ bản, nó cho phép người dự báo nói: “mặc dù tôi chưa trình bày phương pháp của mình, bạn có thể tin tưởng ước tính này vì thành tích của tôi” (chúng tôi giải thích trong phần tiếp theo tại sao điều này vẫn thất bại đối với việc dự báo rủi ro hiện hữu từ AI). Nhưng cuối cùng, thiếu cả cơ sở quy nạp lẫn suy diễn, tất cả những gì người dự báo có thể làm là bịa ra một con số, và những con số bịa đặt đó hoàn toàn không nhất quán.

Hãy xem xét Giải đấu Thuyết phục về Rủi ro Hiện hữu (XPT) do Viện Nghiên cứu Dự báo thực hiện vào cuối năm 2022, mà chúng tôi cho là bài tập dự báo rủi ro hiện hữu công phu và được thực hiện tốt nhất cho đến nay. Nó liên quan đến nhiều nhóm người dự báo khác nhau, bao gồm các chuyên gia AI và chuyên gia dự báo (“siêu dự báo viên” trong hình). Đối với các chuyên gia AI, mức cao (phân vị thứ 75) của các ước tính về rủi ro tuyệt chủng do AI vào năm 2100 là 12%, ước tính trung vị là 3% và mức thấp (phân vị thứ 25) là 0,25%. Đối với các chuyên gia dự báo, ngay cả mức cao (phân vị thứ 75) cũng chỉ là 1%, trung vị chỉ là 0,38% và mức thấp (phân vị thứ 25) gần như không thể phân biệt được với số không trên biểu đồ. Nói cách khác, dự báo ở phân vị thứ 75 của chuyên gia AI và dự báo ở phân vị thứ 25 của siêu dự báo viên khác nhau ít nhất 100 lần.
Tất cả những ước tính này đều đến từ những người có chuyên môn sâu về chủ đề này và đã tham gia vào một giải đấu kéo dài hàng tháng, nơi họ cố gắng thuyết phục lẫn nhau! Nếu phạm vi dự báo này vẫn chưa đủ cực đoan, hãy nhớ rằng toàn bộ bài tập này được thực hiện bởi một nhóm tại một thời điểm. Chúng ta có thể nhận được những con số khác nếu giải đấu được lặp lại ngày hôm nay, nếu các câu hỏi được đặt ra theo cách khác, v.v.
Điều đáng nói nhất là hãy nhìn vào những lý lẽ mà các chuyên gia dự báo đưa ra, vốn được trình bày rất chi tiết trong báo cáo. Họ không sử dụng các mô hình định lượng, đặc biệt là khi suy xét về khả năng xảy ra các kết quả tồi tệ nếu AI mạnh mẽ được phát triển. Phần lớn, các chuyên gia dự báo đang tham gia vào kiểu suy đoán giống như người bình thường khi thảo luận về AI siêu thông minh. Có lẽ AI sẽ chiếm quyền kiểm soát các hệ thống quan trọng thông qua khả năng thuyết phục siêu phàm đối với các nhà vận hành hệ thống. Có lẽ AI sẽ tìm cách hạ nhiệt độ toàn cầu vì điều đó giúp máy tính chạy nhanh hơn, và vô tình xóa sổ nhân loại. Hoặc có lẽ AI sẽ tìm kiếm tài nguyên trong không gian thay vì trên Trái đất, vì vậy chúng ta không cần phải quá lo lắng. Không có gì sai với những suy đoán như vậy. Nhưng chúng ta cần làm rõ rằng khi nói đến rủi ro hiện hữu (x-risk) từ AI, các chuyên gia dự báo không dựa trên bất kỳ kiến thức, bằng chứng hay mô hình đặc biệt nào khiến cho linh cảm của họ đáng tin cậy hơn của bạn, của chúng tôi hay của bất kỳ ai khác.
Thuật ngữ siêu dự báo bắt nguồn từ nghiên cứu kéo dài 20 năm của Philip Tetlock về dự báo (ông cũng là một trong những người tổ chức XPT). Các siêu dự báo viên thường được đào tạo về các phương pháp cải thiện dự báo, chẳng hạn như bằng cách tích hợp thông tin đa dạng và giảm thiểu các thiên kiến tâm lý. Những phương pháp này đã được chứng minh là hiệu quả trong các lĩnh vực như địa chính trị. Nhưng dù có được đào tạo đến đâu cũng sẽ không dẫn đến những dự báo tốt nếu không có nhiều bằng chứng hữu ích để dựa vào.
Ngay cả khi các chuyên gia dự báo có các mô hình định lượng đáng tin cậy (thực tế là không), họ vẫn phải tính đến những "ẩn số chưa biết", đó là khả năng chính mô hình đó có thể sai. Như triết gia về rủi ro hiện hữu Nick Bostrom giải thích: "Sự không chắc chắn và khả năng sai sót trong các đánh giá rủi ro bậc một của chúng ta tự thân nó là một yếu tố mà chúng ta phải đưa vào các phân bổ xác suất sau khi đã cân nhắc mọi khía cạnh. Yếu tố này thường chiếm ưu thế trong các rủi ro có xác suất thấp nhưng hậu quả cao — đặc biệt là những rủi ro liên quan đến các hiện tượng tự nhiên chưa được hiểu rõ, động lực xã hội phức tạp, công nghệ mới, hoặc những rủi ro khó đánh giá vì các lý do khác."
Đây là một quan điểm hợp lý, và các chuyên gia dự báo rủi ro hiện hữu từ AI thực sự rất lo lắng về sự không chắc chắn trong đánh giá rủi ro. Nhưng một hệ quả của điều này là đối với những người tuân theo nguyên tắc đó, các dự báo chắc chắn chỉ là những phỏng đoán thay vì là kết quả của một mô hình — xét cho cùng, không mô hình nào có thể được sử dụng để ước tính xác suất rằng chính mô hình đó bị sai, hoặc rủi ro sẽ là bao nhiêu nếu mô hình đó sai.
Tóm lại, các dự báo chủ quan về rủi ro AI khác biệt nhau theo từng bậc độ lớn. Nhưng nếu chúng ta có thể đo lường thành tích của các chuyên gia dự báo, có lẽ chúng ta có thể sử dụng điều đó để tìm ra chuyên gia nào đáng tin cậy. Trái ngược với hai phương pháp trước đây để biện minh cho các ước tính rủi ro (quy nạp và diễn dịch), chuyên gia dự báo không cần phải giải thích ước tính của họ, mà thay vào đó biện minh dựa trên kỹ năng đã được chứng minh của họ trong việc dự đoán các kết quả khác trong quá khứ.
Điều này đã được chứng minh là vô giá trong lĩnh vực các sự kiện địa chính trị, và cộng đồng dự báo dành rất nhiều nỗ lực cho việc đo lường kỹ năng. Có nhiều cách để đánh giá kỹ năng dự báo, chẳng hạn như hiệu chuẩn (calibration), điểm Brier, điểm logarit, hoặc điểm Peer được sử dụng trên trang web thi dự báo Metaculus.
Nhưng bất kể phương pháp nào được sử dụng, khi nói đến rủi ro hiện hữu, có rất nhiều rào cản trong việc đánh giá kỹ năng dự báo đối với các xác suất chủ quan: thiếu lớp tham chiếu, tỷ lệ cơ bản thấp và tầm nhìn thời gian dài. Hãy cùng xem xét từng yếu tố này.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ AI as Normal Technology. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.