Tin ngành
Nunchux AI ra mắt VC-Attention: Nhân xử lý chú ý giúp tăng tốc mô hình Video Diffusion mà không cần huấn luyện lại
(giờ Việt Nam)
Tóm tắt AI
Nunchux AI giới thiệu VC-Attention, giải pháp tối ưu hóa nhân chú ý (attention kernel) với độ chính xác thấp, giúp khắc phục lỗi lượng tử hóa và nút thắt softmax trong các mô hình Video Diffusion Transformer.
Bản dịch AI
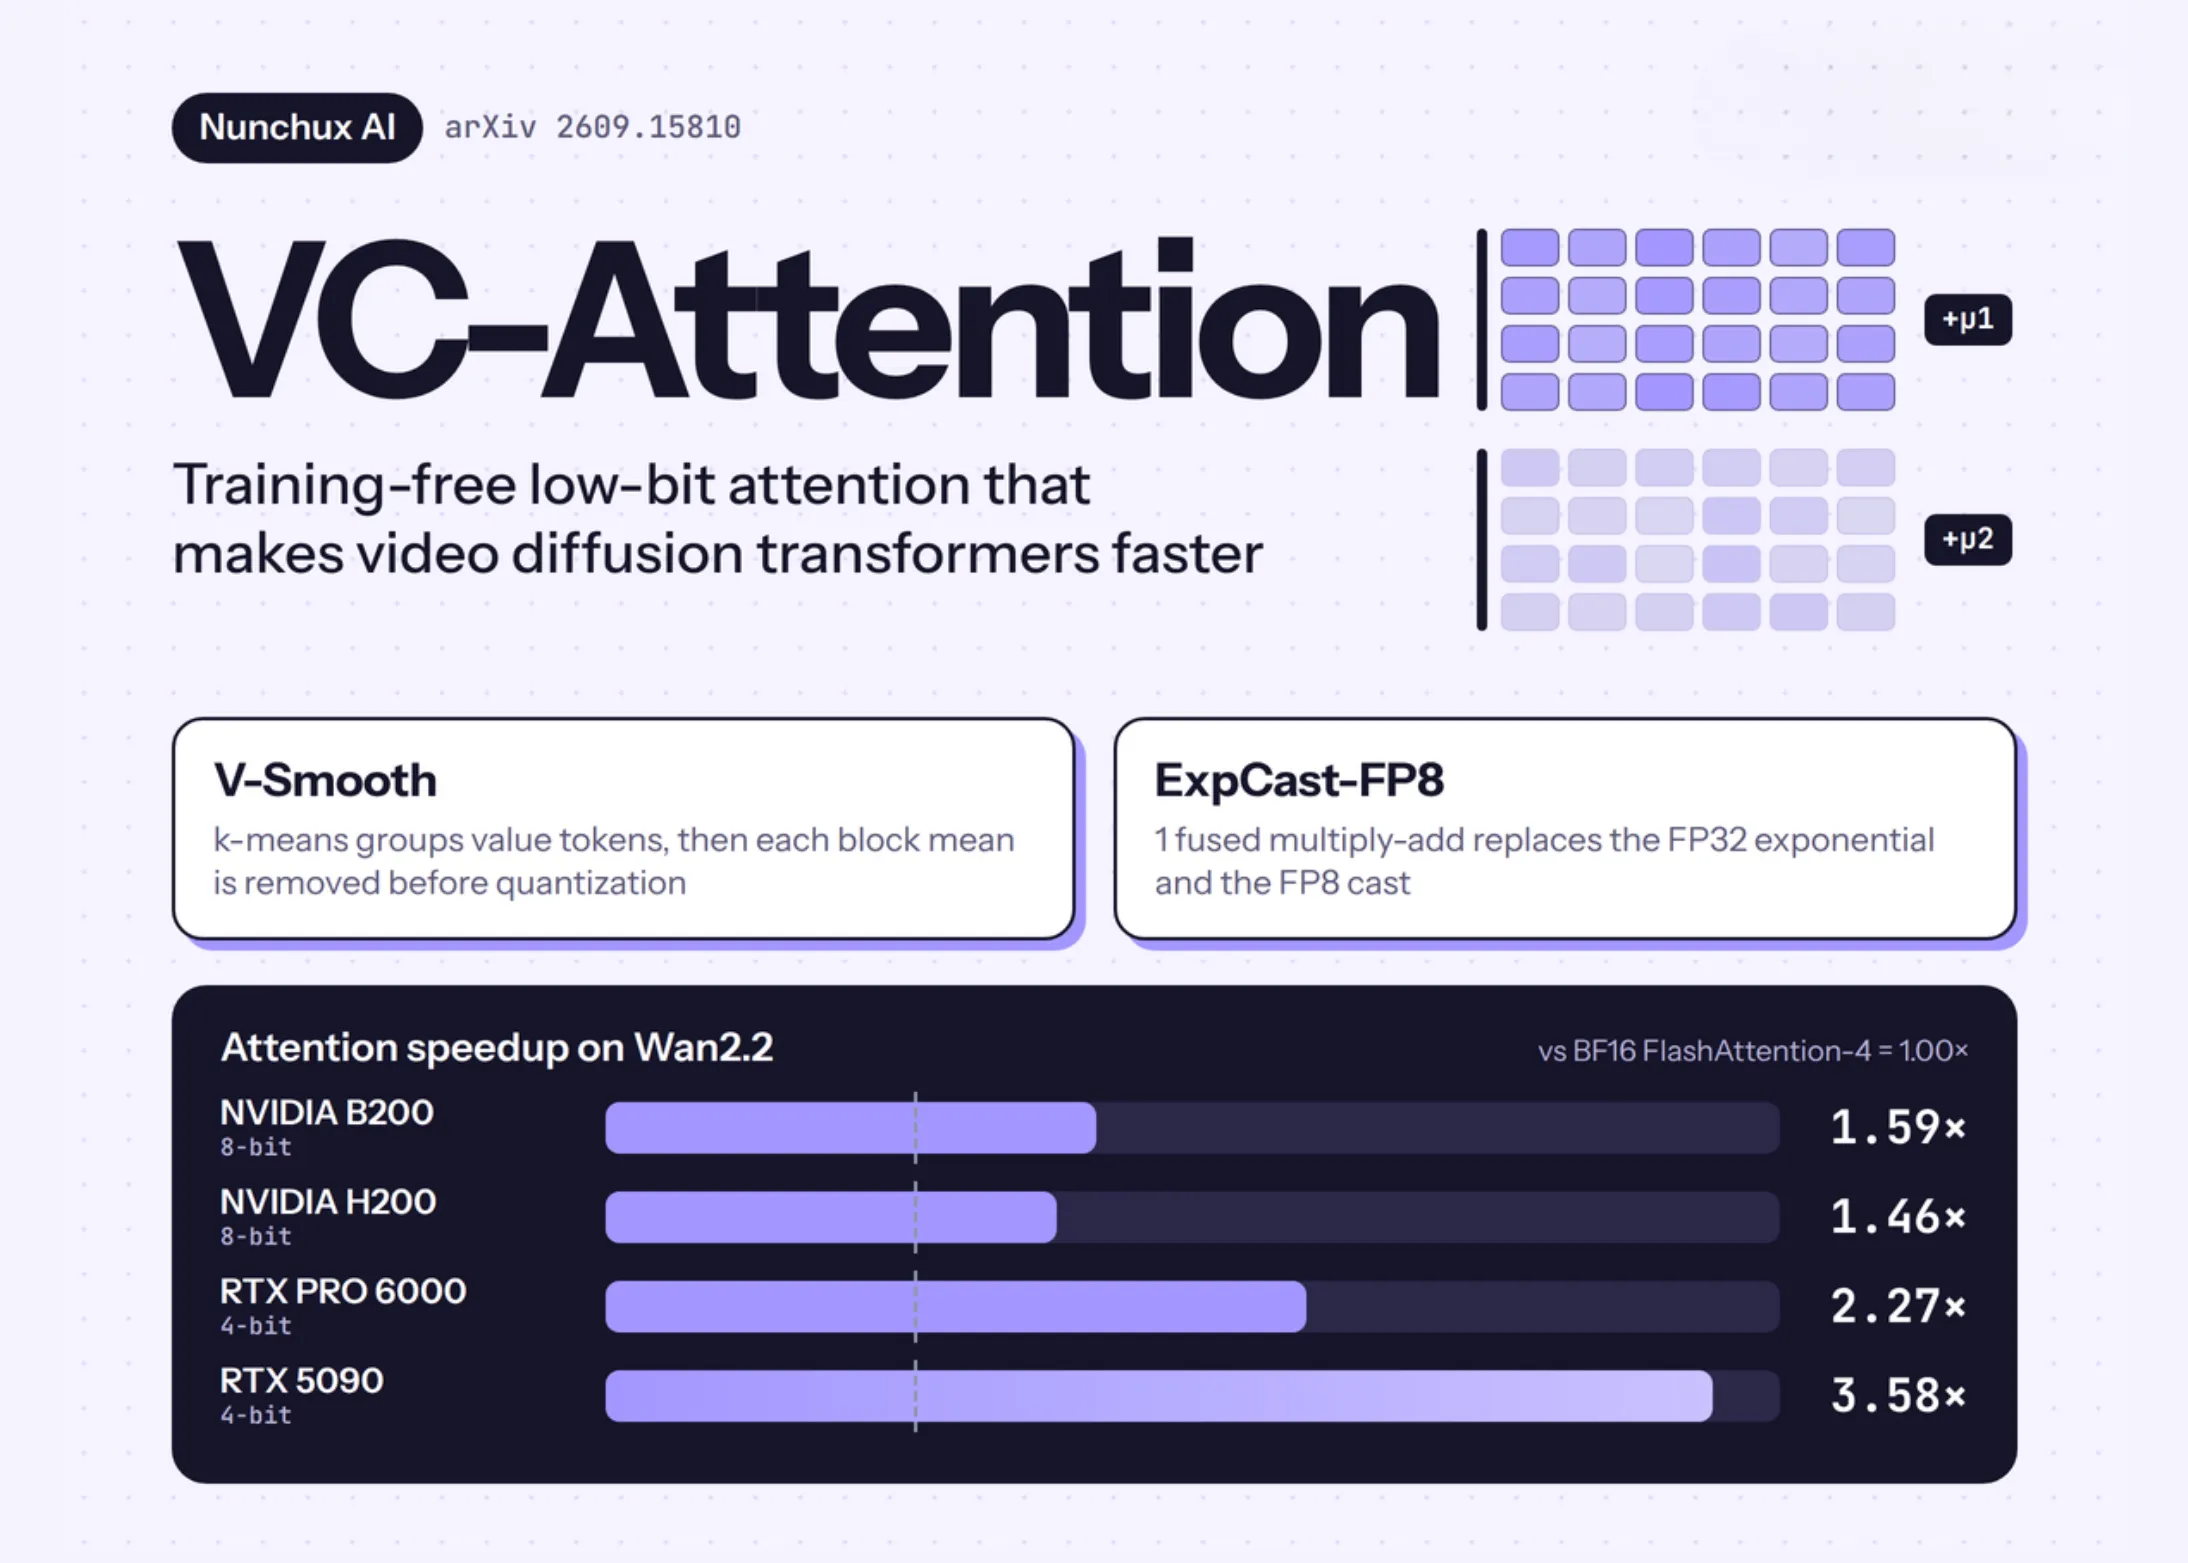
Nunchux AI vừa ra mắt VC-Attention, một kernel attention bit thấp không cần huấn luyện (training-free) được xây dựng cho các mô hình Video Diffusion Transformers (DiTs). Nó nhắm đến 2 vấn đề cùng lúc: lỗi lượng tử hóa giá trị (value quantization error) và giai đoạn softmax chậm chạp.
Tại sao Attention lại là nút thắt cổ chai của Video
Các mô hình Video DiTs làm phẳng một clip thành 1 chuỗi các token không gian-thời gian và chạy full self-attention ở mỗi lớp. Một clip 5 giây độ phân giải 720p của Wan2.2-14B bao gồm khoảng 70K token. Trên RTX 5090, attention chiếm hơn 64% thời gian tạo ảnh. Nhóm nghiên cứu cho biết attention chiếm khoảng hai phần ba mỗi bước khử nhiễu (denoising step) của MiniMax-H3 trên một card B200 đơn lẻ.
Các Tensor Core bit thấp giúp tăng tốc 2 phép nhân ma trận là QK và PV. Tuy nhiên vẫn còn 2 trở ngại. Thứ nhất, các phương pháp trước đây như SageAttention2 thực hiện làm mịn (smooth) các query và key. Sau khi làm mịn và xoay QK, thành phần giá trị (value term) chiếm tới 82% lỗi đầu ra trên Wan2.2. Thứ hai, phép softmax giữa các tích vẫn chạy ở định dạng FP32. Trên B200 và H200, phép tính mũ đó cùng với việc chuyển đổi sang FP8 trở thành giai đoạn đường ống (pipeline) dài nhất.
V-Smooth: Khắc phục các giá trị ngoại lai (Value Outliers)
Các giá trị ngoại lai nằm ở một vài token, và các kênh của chúng thay đổi qua các head, lớp và bước. Phép xoay Hadamard bảo toàn chuẩn token, vì vậy nó không loại bỏ được các giá trị này. Việc xoay V chỉ làm thay đổi lỗi giá trị khoảng 0,2%.
V-Smooth chọn một hướng đi khác:
Khi lấy trung bình trên 100 head của Wan2.2, giá trị trung bình khối (block mean) loại bỏ 8% năng lượng khối theo thứ tự chuỗi. Nó loại bỏ 12% dưới khối tĩnh của DeltaQuant và 36% sau khi sắp xếp. Mỗi giá trị trung bình tiêu tốn 0,125 bit cho mỗi phần tử giá trị.
Việc nhóm (grouping) chỉ chạy trên 25% số bước khử nhiễu đầu tiên. Phép hoán vị được tái sử dụng qua 4 bước liền kề. Tính trung bình trên toàn bộ lịch trình, việc nhóm tiêu tốn từ 3 đến 4% thời gian của attention.
ExpCast-FP8: Loại bỏ nút thắt cổ chai Softmax
Một byte E4M3 vốn đã gần với logarit của giá trị mà nó lưu trữ. Khi đọc dưới dạng số nguyên, nó xấp xỉ bằng 8 log2(v) + 56. Vì vậy, ExpCast-FP8 ghi byte trực tiếp từ điểm số trong miền log với 1 phép nhân-cộng hợp nhất (fused multiply-add). Hằng số β = -0.35 giúp căn giữa phần lỗi còn lại và không cần khớp hằng số cho từng mô hình.
Đường dẫn trực tiếp ghi cùng một byte như đường dẫn FP32 (lấy số mũ rồi chuyển đổi) trên 79,6% mỗi lần nhân đôi. Ở những nơi khác, nó lệch 1 mã. Bài báo chứng minh giới hạn biến thiên tổng thể trên mỗi hàng dưới 3,64%, cộng với bất kỳ phần đuôi underflow nào. Trên 204,8K hàng attention của Wan2.2, mức trung bình đo được là 1,6%. ExpCast-FP8 chỉ áp dụng cho kernel 8-bit, vì NVFP4 không có bản đồ log-to-code affine đơn lẻ.
Việc hợp nhất (fusion) chuỗi tiền xử lý bằng CuTe/CUDA viết tay giúp giảm thời gian gọi 1 V-Smooth từ 42,2 ms xuống còn 4,8 ms trên B200.
Giải thích: VC-Attention hoạt động như thế nào
Các bài kiểm tra hiệu năng (Benchmarks)
Các thử nghiệm bao gồm 4 mô hình Video DiTs mã nguồn mở: Wan2.2-T2V-A14B, LongCat-Video, HunyuanVideo-1.5 và MiniMax-H3. Độ trung thực (fidelity) được chấm điểm dựa trên đầu ra của BF16 FlashAttention-4 qua 100 câu lệnh (prompts).
Trên B200, VC-Attention nhanh hơn 6,02 lần so với SageAttention2 (vốn không hỗ trợ kernel Blackwell). Trên H200, khoảng cách là 1,16 lần. Trên các card đồ họa máy trạm, V-Smooth 4-bit ngang ngửa với SageAttention3 trên RTX PRO 6000. Nó duy trì sai số trong khoảng 5% trên RTX 5090, vì vậy độ trung thực là yếu tố phân biệt chúng.
Kết quả về độ trung thực:
Trên MiniMax-H3 ở độ phân giải 1344×768, attention chạy nhanh hơn 1,60 lần so với BF16 FlashAttention-4 trên B200. Chỉ số PSNR đạt 20,2 dB so với 19,9 dB của SageAttention2. Trên B300, bài báo báo cáo tốc độ nhanh hơn 1,47 lần so với 1,31 lần của một kernel FP8 thông thường. Biểu đồ trên blog liệt kê con số 1,51 lần cho B300.
Nunchux Attention, phần mở rộng độc quyền của công ty, đạt tốc độ 1,91 lần trên B200 và 1,83 lần trên B300 đối với attention của MiniMax-H3.
Phương pháp này chỉ thay đổi chi phí trên mỗi tương tác. Vì vậy, nó có thể kết hợp với các kỹ thuật attention thưa (sparse attention) như Sparse VideoGen và Radial Attention, cũng như chưng cất mô hình (distillation) và thực thi đa GPU. Nunchux cho biết quyền truy cập miễn phí vào MiniMax-H3 sẽ sớm có thông qua danh sách chờ Modelverse.
Những điểm chính cần lưu ý
Hãy xem bài báo và các chi tiết kỹ thuật. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit ML với hơn 150k thành viên của chúng tôi và đăng ký nhận bản tin. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, trang Hugging Face, sản phẩm mới hoặc hội thảo trực tuyến, v.v.? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt nền tảng truyền thông Trí tuệ nhân tạo Marktechpost, nổi bật với việc đưa tin chuyên sâu về học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo độc giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với công chúng.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.