Thủ thuật
SemiAnalysis: Hiệu năng suy luận AI của Vera Rubin NVL72 vượt GB300 tới 67 lần
(giờ Việt Nam)
Tóm tắt AI
Dựa trên bài kiểm tra AgentX, hệ thống Vera Rubin NVL72 cho thấy hiệu suất suy luận vượt trội, đạt mức tối ưu gấp 67 lần so với GB300 Dynamo trong các tác vụ đòi hỏi thông lượng cao.
Bản dịch AI
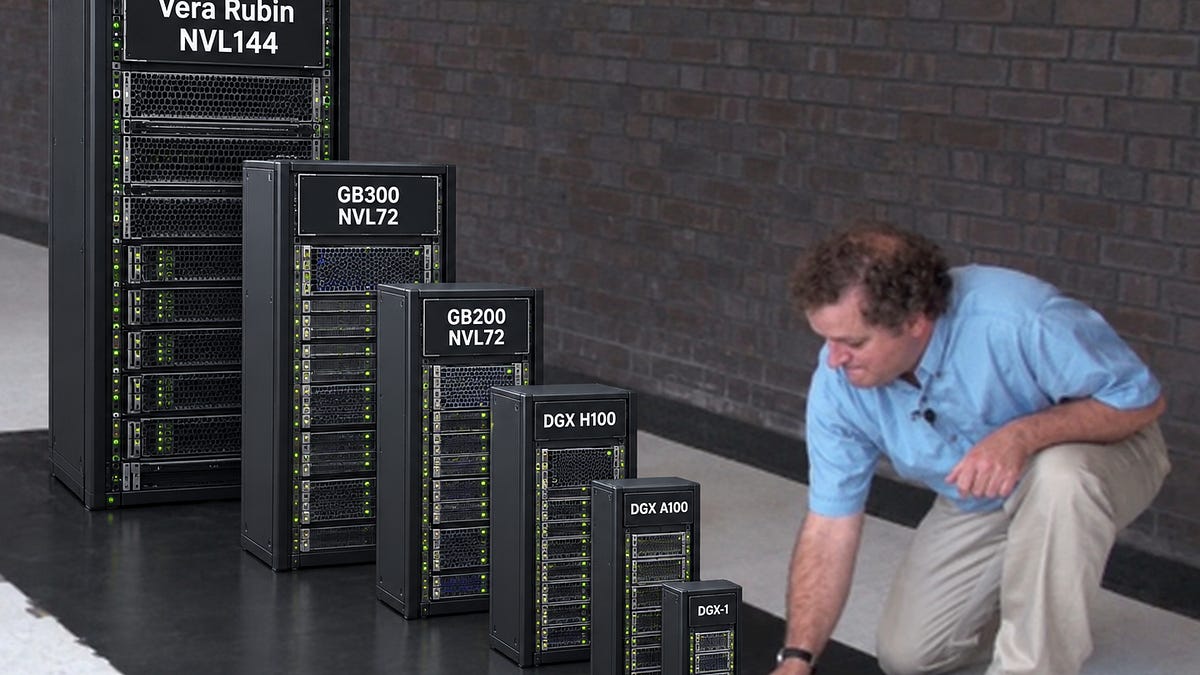
Rubin là nền tảng đầu tiên được đồng thiết kế trên sáu sản phẩm dành cho kỷ nguyên tác tử (agentic era): Rubin GPU, Vera CPU, NVLink 6 Switch, ConnectX-9, BlueField-4 và Spectrum-6. Hôm nay, chúng tôi công bố kết quả suy luận tác tử (agentic inference) được xác thực đầu tiên cho Rubin, đo lường trên chuẩn đo lường suy luận tác tử của chúng tôi, AgentX. Ngay cả trên các phiên bản phần mềm tiền phát hành, kết quả đã cho thấy lý do tại sao việc đồng thiết kế cực hạn lại cần thiết đến vậy.
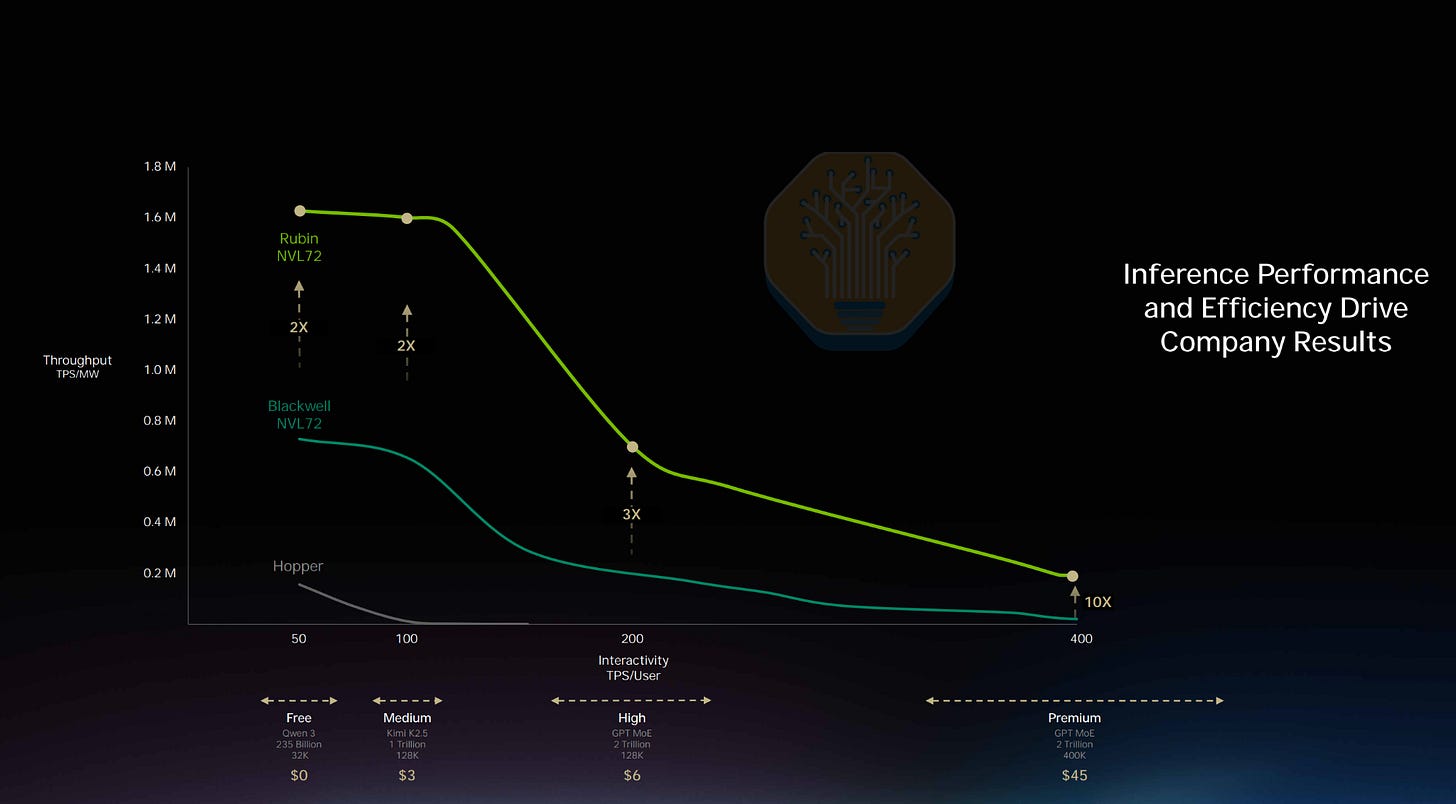
Tại GTC 2026, Jensen đã trình bày biểu đồ cho thấy VR NVL72 đạt hiệu suất trên mỗi MW gấp 3 lần so với Blackwell trên mô hình tham số O(1-3 nghìn tỷ) ở mức khoảng 200 TPS. Nhưng khi so sánh với hiệu suất thực tế của Rubin trên phần mềm tiền phát hành, chúng tôi đã thấy thông lượng token trên mỗi megawatt tốt hơn tới 7 lần. Jensen cần ngừng việc hạ thấp các tuyên bố về hiệu suất của mình tại GTC. Lần cuối cùng ông ấy làm điều này tại GTC 2024, khi tuyên bố GB200 NVL72 sẽ mang lại hiệu suất gấp 30 lần Hopper, nhưng khi chúng tôi thử nghiệm, nó cho hiệu suất tốt hơn tới 98 lần so với Hopper.
Các ước tính của chúng tôi về kết quả hiệu suất cho thấy ngay cả trên các bản dựng phần mềm sớm, Rubin có thể mang lại lợi nhuận trên mỗi gigawatt cao hơn gấp 2 lần so với nền tảng Blackwell. Khi ngăn xếp phần mềm và thư viện nhân (kernel libraries) của Rubin hoàn thiện hơn, và khi cộng đồng nhà phát triển tích lũy kinh nghiệm tối ưu hóa cho Rubin, chúng tôi kỳ vọng khoảng cách đó sẽ còn nới rộng hơn nữa.
Chúng tôi đánh giá hiệu suất bằng kịch bản chuẩn đo lường suy luận tác tử tiêu chuẩn ngành có tên là AgentX. Kịch bản này mô phỏng lại lưu lượng truy cập tác tử thực tế trên đội ngũ hàng nghìn chip của chúng tôi. Do đó, các kết quả này có thể được các nhà cung cấp dịch vụ suy luận và các phòng thí nghiệm AI quy mô lớn tham chiếu một cách toàn diện để quyết định loại chip nào hiệu quả nhất trong từng kịch bản.
Chuẩn đo lường của chúng tôi đã được sao chép, xác thực và/hoặc hỗ trợ rộng rãi bởi hầu hết các bên mua năng lực tính toán lớn, từ Google Cloud đến Microsoft Azure, Oracle, Meta và nhiều đơn vị khác. Hơn nữa, nó còn nhận được sự hỗ trợ từ cộng đồng ML bao gồm vLLM, LMCache, SGLang, PyTorch, Huggingface và sự ủng hộ từ các phòng thí nghiệm lớn như OpenAI, MiniMax, ZAI, Qwen, Moonshot Kimi, v.v.
Xin cảm ơn Jensen Huang, Ian Buck, Nick Comly, Kedar Potdar, Rohit Nagraj và Đội ngũ TensorRTLLM tại Trung Quốc đại lục đã hỗ trợ thực hiện khởi chạy phần mềm Rubin thế hệ tiếp theo và giúp xác thực các kết quả chuẩn đo lường tác tử của chúng tôi.
Hãy gắn sao (star) cho kho lưu trữ InferenceX trên GitHub nếu bạn thấy chuẩn đo lường và dữ liệu mã nguồn mở này hữu ích!. InferenceX là chuẩn đo lường suy luận duy nhất trên thế giới hỗ trợ TPUv7, NVIDIA, AMD và sắp tới là SambaNova & Trainium. Do kịch bản AgentX rất sát với khối lượng công việc suy luận tác tử trong thế giới thực, AMD cũng đã cam kết hợp tác trên MI455X UALoE72.
Ở cấp độ tổng quát, một khối lượng công việc tác tử được đặc trưng bởi bốn yếu tố:
Đa lượt (Multi-turn): một phiên bao gồm hàng chục hoặc hàng trăm tương tác giữa người dùng và trợ lý, so với chỉ một vài tương tác trong kịch bản chatbot. Các khối lượng công việc này kết hợp ngữ cảnh dài và khả năng tái sử dụng tiền tố (prefill) cao với các đợt bùng nổ tác tử phụ (sub-agent bursts) và vô số lệnh gọi công cụ.
Ngữ cảnh dài (Long context): các câu lệnh hệ thống (system prompts), định nghĩa công cụ và số lượng lượt tương tác lớn khiến ngữ cảnh tích tụ nhanh chóng.
Tái sử dụng tiền tố cao (High prefix reuse): vì cuộc hội thoại tiến triển theo đường thẳng, trong đó đầu ra từ lượt n-1 thường được nối vào lượt n, hầu hết ngữ cảnh có thể được phục vụ từ bộ nhớ đệm KV (KV cache) thay vì phải tính toán lại (điều này phụ thuộc vào dung lượng lưu trữ khả dụng cho các tensor KV). Khi n tăng lên, tỷ lệ đầu vào được lưu trong bộ nhớ đệm so với đầu vào không được lưu thường có xu hướng tiến về 1.
Đợt bùng nổ tác tử phụ (Sub-agent bursts): một phiên khởi chạy nhiều tác tử phụ tồn tại trong thời gian ngắn với ngữ cảnh mới, tạo ra các mô hình bộ nhớ đệm KV bùng nổ.
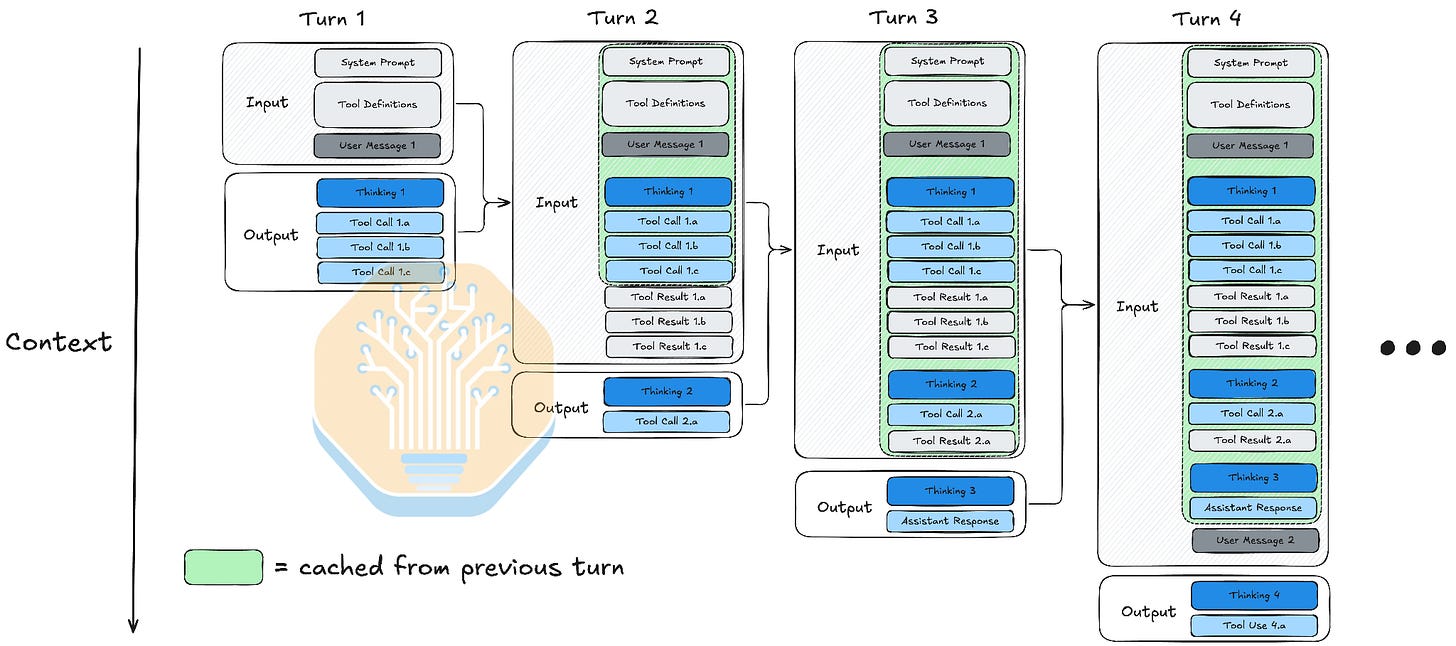
Đọc thêm về phương pháp luận trong bài viết về AgentX của chúng tôi.
Hiệu suất trên tổng chi phí sở hữu (TCO) là một trong những góc độ quan trọng nhất để đánh giá hiệu suất của bộ tăng tốc AI. Trong các biểu đồ dưới đây, trục Y là tổng số token trên mỗi 1 USD TCO. Nói một cách thực tế, điều này cho nhà cung cấp dịch vụ suy luận biết họ có thể tạo ra bao nhiêu token cho mỗi đô la chi tiêu cho năng lực tính toán. Chỉ số này được tính bằng cách chuẩn hóa tổng thông lượng cho một kịch bản theo chi phí phục vụ toàn diện ($/chip/giờ nhân với số lượng chip được sử dụng để phục vụ).
Trên InferenceX, chúng tôi cung cấp một vài số liệu TCO khác nhau cho mỗi SKU, bắt nguồn từ Mô hình TCO Đám mây AI của SemiAnalysis. Các kịch bản được cung cấp mặc định như sau:
Sở hữu tại quy mô Hyperscaler lớn: chi phí mô hình hóa trên mỗi GPU-giờ để sở hữu và vận hành phần cứng, bao gồm chi phí vốn (capex) cho máy chủ và mạng được phân bổ trong suốt vòng đời hữu dụng giả định, chi phí đặt chỗ (colocation), điện năng và chi phí vốn. Điều này giả định các điều khoản mua sắm và tài chính của hyperscaler, bao gồm chiết khấu theo khối lượng và các cấu hình máy chủ tùy chỉnh.
Thuê - Cam kết 3 năm: giá thị trường trên mỗi GPU-giờ trả cho nhà cung cấp đám mây cho một cam kết đặt chỗ trong ba năm, dựa trên các khảo sát về giá thuê của SemiAnalysis.
Người dùng cũng có thể chỉnh sửa chi phí tính toán trong máy tính của chúng tôi để khớp với chi phí họ đang trả. Các số liệu khác như giá thuê thị trường theo yêu cầu và các cam kết thuê ngắn hạn hơn có thể được tìm thấy trong mô hình TCO Đám mây AI, vốn đến từ khảo sát thị trường hàng tháng của chúng tôi với hơn 100 khách hàng GPU, các nhà cung cấp GPU neocloud và các hyperscaler.
Vera Rubin là một cải tiến đáng kể so với GB300 về hiệu suất trên mỗi đô la. Ở mức 170 TPS, trên cấu hình TRTLLM NVFP4 Dense (so sánh tương đương), Vera Rubin NVL72 mang lại tổng thông lượng trên mỗi TCO gấp khoảng 67 lần so với GB300 Dynamo TRTLLM theo các giả định chi phí sở hữu. Hơn nữa, tại phân khúc biên nơi hầu hết các nhà cung cấp thực sự phục vụ mô hình này (60-100 TPS), Vera Rubin đạt được thông lượng trên mỗi TCO gấp từ 1,4 đến 3 lần so với cấu hình GB300 TRTLLM mới nhất và mạnh nhất.
Rack của chúng tôi sử dụng SKU sản xuất với TDP 2300W và 1,5TB CPU LPDDR5X trên mỗi khay tính toán. Chúng tôi thảo luận nhiều hơn về lý do tại sao NVIDIA phải cắt giảm một nửa bộ nhớ Vera trong mô hình bộ tăng tốc và bộ nhớ của chúng tôi. Đối với bài viết này, chúng tôi sẽ nói về hiệu suất TRTLLM của Rubin nhưng chúng tôi kỳ vọng các bài viết sau sẽ bao gồm cả hiệu suất vLLM Rubin & SGLang Rubin trên các khối lượng công việc suy luận tác tử.
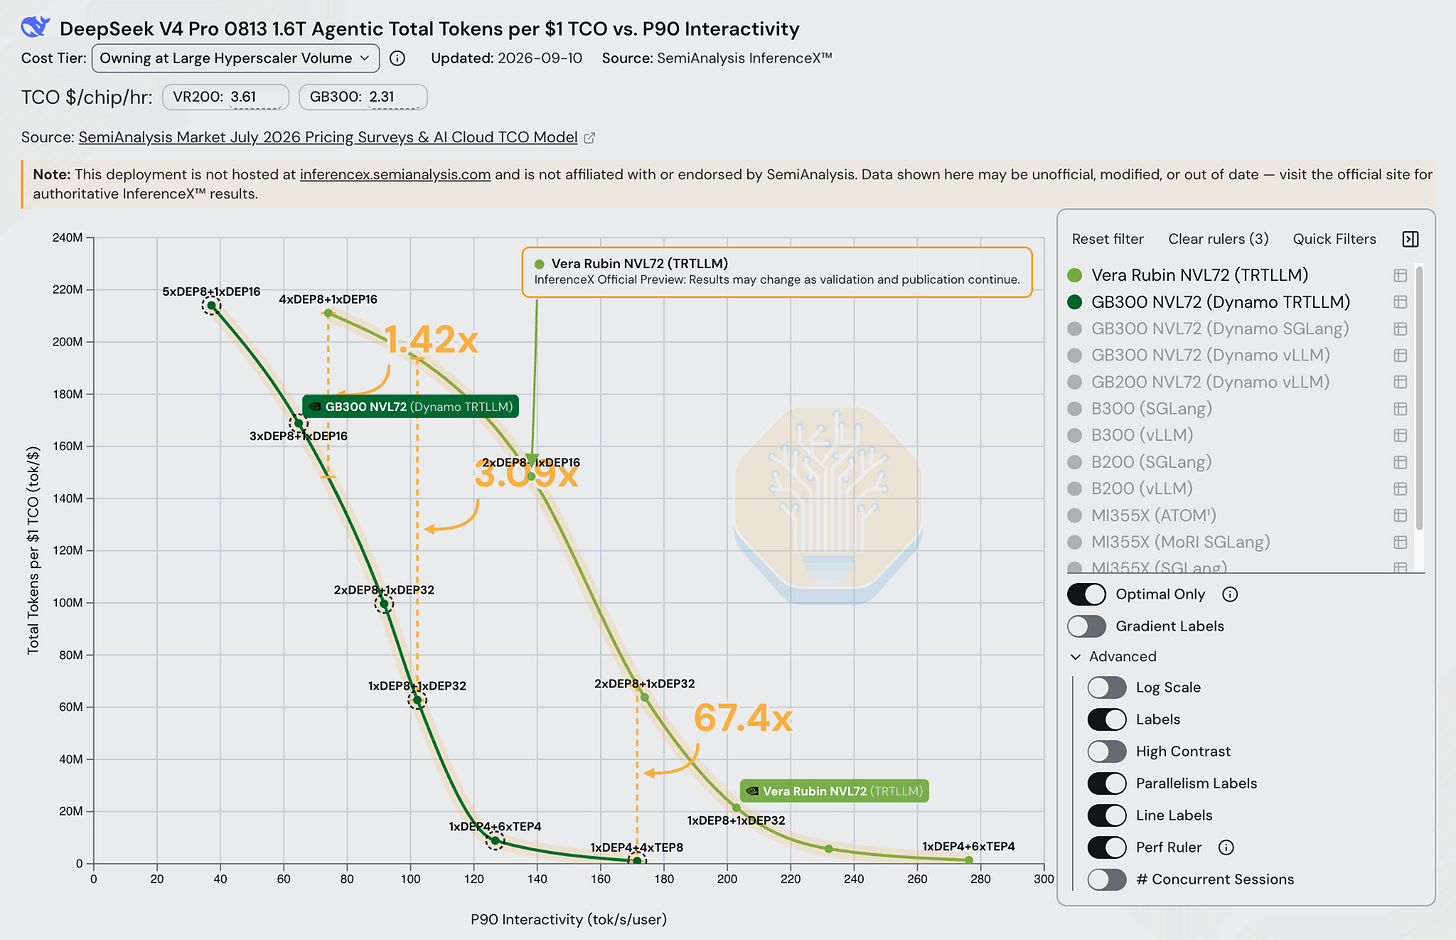
Vera Rubin đạt được khả năng tương tác P90 tối đa cao hơn khoảng 61% so với GB300 Dynamo TRTLLM, đạt 276,24 so với 171,53 P90 TPS. Tuy nhiên, khi sử dụng ngăn xếp SGLang mã nguồn mở, GB300 có thể đạt được khả năng tương tác tương tự như Vera Rubin.
Chúng tôi nhận thấy rằng đây là bản phát hành phần mềm TRTLLM tiền phát hành sớm và hiệu suất sẽ chỉ tốt hơn, đặc biệt là ở các "điểm cuối" của biên giới (thông lượng siêu cao/độ trễ siêu thấp). Thúc đẩy biên giới tiến lên và làm nổi bật những cải tiến theo thời gian là mục tiêu cuối cùng của InferenceX. Đọc thêm về điều này trong các bài viết trước của chúng tôi về InferenceX:
Cũng cần lưu ý rằng Vera Rubin đạt được độ trễ P90 E2E (đầu cuối) tốt hơn đáng kể trong các kịch bản thông lượng cao hơn. Mặc dù khả năng tương tác (TPS) thường là tiêu đề cho các chuẩn đo lường hiệu suất, các chỉ số độ trễ như TTFT (thời gian đến token đầu tiên) và độ trễ E2E cũng rất quan trọng và là một trong những tiêu chuẩn SLA thực tế trong phục vụ sản xuất.
Khi chúng ta xem xét chi phí thuê 3 năm, vốn vào tháng 7 năm 2026 là hơn 8,5 USD/giờ/chip cho Rubin và 5 USD/giờ/chip cho Blackwell Ultra NVL72, thì việc nâng cấp vẫn hoàn toàn xứng đáng. Ở mức khả năng tương tác P90 80 TPS, Vera Rubin có thể tạo ra nhiều hơn 62% tổng số token với cùng mức TCO thuê. Trên các phần có khả năng tương tác cao hơn của biên giới, Vera Rubin đạt được số token trên mỗi TCO thuê 3 năm gấp tới 16 lần.
Bài học ở đây khá đơn giản: nếu bạn có tiền để mua hoặc thuê một chiếc VR NVL72, bạn nên làm vậy – nó sẽ tạo ra các token rẻ hơn đáng kể so với bộ tăng tốc hàng đầu tiếp theo và do đó giúp bạn kiếm được nhiều tiền hơn đáng kể. Như Jensen đã nói một cách nổi tiếng: "bạn càng mua nhiều, bạn càng kiếm được nhiều".
Khi so sánh với Blackwell đơn nút và MI355X, khoảng cách về hiệu suất trên TCO thậm chí còn rộng hơn trên toàn bộ đường cong. Tại SLA P90 80 TPS (một lần nữa, khá thực tế cho mô hình này), một nhà cung cấp dịch vụ suy luận có thể phục vụ số lượng token gấp 10 lần trên mỗi USD so với B300 khi sử dụng số liệu TCO sở hữu.
Lợi thế này cũng mở rộng sang độ trễ P90 đầu cuối. Như hiển thị bên dưới, ở mức 60 triệu token trên mỗi đô la TCO theo các giả định sở hữu, Vera Rubin đạt được độ trễ P90 đầu cuối khoảng 20 giây, so với 60 giây đối với B200/B300 chạy ngăn xếp phục vụ vLLM mới nhất. Ở mức 160 triệu token trên mỗi đô la, khoảng cách độ trễ P90 đầu cuối nới rộng lên khoảng sáu lần: 20 giây cho Vera Rubin so với 120 giây.
Trên các khối lượng công việc tác tử, Vera Rubin khiến H200 trông có vẻ cạnh tranh như một chiếc máy tính bỏ túi TI-84. Tại mục tiêu khả năng tương tác P90 là 80 TPS, Rubin mang lại số token trên mỗi đô la gấp 18 lần. Tại 120 P90 TPS, lợi thế đó nới rộng lên 39 lần. Các lợi thế của Rubin ít hơn ở suy luận hàng loạt ngoại tuyến (offline batch inference) và nhiều hơn cho việc huấn luyện vì đây là nơi chúng ta thấy các phòng thí nghiệm lớn đang dần chuyển dịch Hopper sang.
Sự sẵn có của các trung tâm dữ liệu được cấp nguồn thường là yếu tố hạn chế việc triển khai thêm chip, vì vậy hiệu quả năng lượng là cực kỳ quan trọng. Nếu bạn có thể tạo ra nhiều token hơn trên mỗi GigaWatt, thì bạn có thể tạo ra nhiều doanh thu và lợi nhuận hơn trên mỗi GigaWatt.
Mô hình Ngành Trung tâm Dữ liệu của SemiAnalysis
Tại GTC 2026, Jensen đã trình bày biểu đồ so sánh Rubin với Blackwell trên một mô hình MoE 2T lớn, cho thấy VR NVL72 đạt hiệu suất trên mỗi MW gấp 3 lần trên một mô hình tham số nghìn tỷ ở mức khoảng 200 TPS. Nhưng khi so sánh với hiệu suất thực tế của Rubin trên phần mềm tiền phát hành, chúng tôi đã thấy thông lượng token trên mỗi megawatt tốt hơn tới 7 lần. Jensen cần ngừng việc hạ thấp các tuyên bố về hiệu suất của mình tại GTC. Ông ấy đã làm điều đó lần trước tại GTC 2024 khi công bố GB200 NVL72, tuyên bố rằng nó sẽ nhanh hơn 30 lần so với Hopper, nhưng khi chúng tôi thử nghiệm, nó cho hiệu suất tốt hơn tới 98 lần so với Hopper.
Khả năng tương tác P90 mô tả tốc độ phát trực tuyến của một phản hồi cá nhân, sử dụng nghịch đảo của độ trễ giữa các token (inter-token latency) của phản hồi đầy đủ P90. Tại một mục tiêu tương tác cố định, đường cong cao hơn có nghĩa là việc triển khai có thể phục vụ tổng lưu lượng truy cập nhiều hơn trong cùng một ngân sách năng lượng. Thời gian chờ ban đầu cho token đầu tiên và thời gian phản hồi tổng thể vẫn là các cân nhắc riêng biệt trong phân tích độ trễ trước đó.
Đối với khối lượng công việc tác tử DeepSeek V4 Pro, Vera Rubin mang lại tổng thông lượng token trên mỗi megawatt cao hơn đáng kể so với GB300 và MI355X tại các mục tiêu tương ứng được so sánh bên dưới. Quy mô của lợi thế đó phụ thuộc vào mục tiêu tương tác và công cụ phục vụ được sử dụng để so sánh.
Tại 100 TPS, Rubin mang lại khoảng 59,4 triệu tổng tok/s/MW, so với 28,5 triệu cho GB300 Dynamo SGLang và 21,1 triệu cho GB300 Dynamo TRTLLM. Đó là lợi thế gấp 2,09 lần so với công cụ GB300 mạnh hơn tại mục tiêu này. MI355X SGLang đạt 2,01 triệu tok/s/MW, mang lại cho Rubin vị thế dẫn đầu gấp 29,5 lần trên khối lượng công việc và ảnh chụp nhanh cụ thể này. SGLang là công cụ mạnh nhất trong số các công cụ MI355X được đo lường tại mục tiêu này.
Bài viết được AI dịch và tổng hợp tự động từ SemiAnalysis RSS. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.