Tin ngành
Dịch vụ Postgres được quản lý của Lakebase: Những gánh nặng vận hành nào đã được loại bỏ?
(giờ Việt Nam)
Tóm tắt AI
Lakebase của Databricks vận hành PostgreSQL trên hạ tầng serverless, tự động hóa các tác vụ như vá lỗi, mở rộng quy mô, sao lưu và phục hồi. Giải pháp này tối ưu hóa hiệu suất ghi gấp 5 lần và hỗ trợ các tính năng chuyên sâu như pgvector hay PostGIS mà không cần quản lý hạ tầng thủ công.
Bản dịch AI

Mọi nhà cung cấp Postgres đều tự gọi mình là "managed" (được quản lý). Tuy nhiên, rất ít bên thống nhất được thuật ngữ này bao hàm những gì. Một số bên chỉ có nghĩa là họ vá lỗi hệ điều hành (OS) và để phần còn lại cho đội ngũ cơ sở dữ liệu. Số khác lại có nghĩa là cơ sở dữ liệu tự động mở rộng, xử lý lỗi và sao lưu mà không cần bất kỳ ai trong nhóm phải đụng vào tệp cấu hình.
Managed Postgres là một dịch vụ cơ sở dữ liệu mà tại đó nhà cung cấp vận hành cơ sở hạ tầng nền tảng và xử lý các hoạt động cốt lõi như vá lỗi, mở rộng, chuyển đổi dự phòng (failover) và sao lưu, giúp đội ngũ cơ sở dữ liệu dành ít thời gian hơn cho việc bảo trì và tập trung nhiều hơn vào việc xây dựng ứng dụng chạy trên đó. Nhà cung cấp càng đảm nhận nhiều hoạt động này, thì khối lượng công việc quản trị cơ sở dữ liệu mà khách hàng phải thực hiện càng ít đi.
Sự khác biệt đó càng trở nên quan trọng khi Postgres tiến vào các ứng dụng AI. Cơ sở dữ liệu giờ đây có thể lưu trữ trạng thái ứng dụng, lịch sử trò chuyện, các vector nhúng (embeddings) và dữ liệu tác nhân (agent data) bên cạnh các khối lượng công việc giao dịch truyền thống, vì vậy phạm vi vận hành không chỉ dừng lại ở việc giữ cho cơ sở dữ liệu hoạt động.
Lakebase Postgres áp dụng cách tiếp cận quản lý đó cho serverless Postgres, kết hợp khả năng tự động mở rộng, tính tương thích với PostgreSQL, khả năng phục hồi và các tích hợp với Databricks. Câu hỏi đặt ra là nó thực sự loại bỏ được bao nhiêu công việc vận hành.
Tóm tắt (TL;DR)
Ý nghĩa thực sự của Managed Postgres
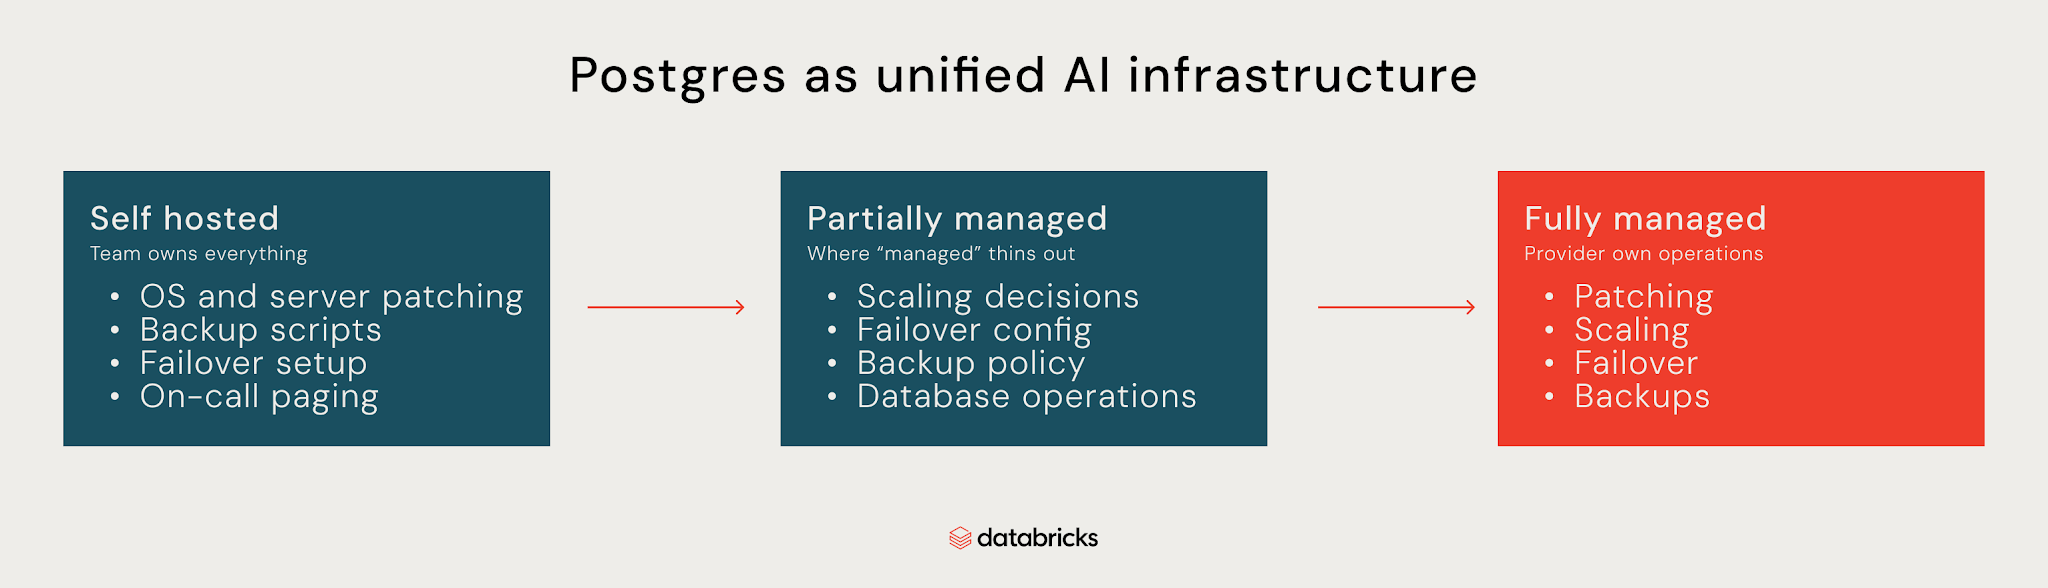
Hãy coi Managed Postgres giống như việc trao chìa khóa cơ sở dữ liệu cho người khác. Việc một nhóm trao quyền đến đâu phụ thuộc vào nhà cung cấp. Ở một thái cực, đội ngũ cơ sở dữ liệu vẫn phải xử lý máy chủ, sao lưu, chuyển đổi dự phòng và mở rộng. Ở thái cực kia, một dịch vụ được quản lý toàn diện (fully managed) sẽ lo liệu mọi công việc vận hành cho nhóm, chứ không chỉ là cơ sở hạ tầng bên dưới. Hầu hết các nhà cung cấp nằm ở đâu đó giữa hai thái cực này, xử lý máy ảo (VM) và mạng trong khi vẫn để lại một số hoạt động cơ sở dữ liệu, quyết định mở rộng, cấu hình chuyển đổi dự phòng và chính sách sao lưu cho đội ngũ của khách hàng.
Một nhà cung cấp có thể vá lỗi OS và gọi cơ sở dữ liệu là "managed" trong khi đội ngũ của bạn vẫn phải chịu trách nhiệm cho các công việc để giữ cho nó luôn sẵn sàng và có thể phục hồi.
Vá lỗi, mở rộng, chuyển đổi dự phòng và sao lưu là những tiêu chí tốt để vạch ra ranh giới đó. Một dịch vụ được quản lý cũng sẽ quyết định xem nhóm của bạn còn phải tự quản lý bao nhiêu phần về bảo mật, phục hồi, di chuyển dữ liệu, khối lượng công việc AI và các công cụ dành cho nhà phát triển xung quanh Postgres.
Managed Postgres là dịch vụ mà nhà cung cấp vận hành cơ sở hạ tầng cơ sở dữ liệu và xử lý các tác vụ vận hành cốt lõi như vá lỗi, mở rộng, chuyển đổi dự phòng và sao lưu. Một dịch vụ được quản lý toàn diện sẽ chịu trách nhiệm cho các hoạt động đó, để nhóm của bạn có thể tập trung vào việc xây dựng ứng dụng trên Postgres thay vì phải vận hành nó.
Những gì Managed Postgres nên đảm nhận
Bài kiểm tra rõ ràng nhất để xác định vị trí của một dịch vụ trên thang đo đó là liệu nó có giúp đội ngũ của bạn giải quyết bốn tác vụ vận hành sau đây hay không:
Bảo trì và vá lỗi
Một nhà cung cấp dịch vụ quản lý nên tự động áp dụng các bản vá OS, cập nhật phiên bản PostgreSQL nhỏ và thực hiện bảo trì định kỳ như tối ưu hóa vacuum mà đội ngũ cơ sở dữ liệu không cần phải lên lịch hay thực hiện thủ công - trái ngược hoàn toàn với Postgres tự lưu trữ (self-hosted), nơi tất cả những việc đó đều do họ đảm nhận. Việc nâng cấp phiên bản lớn vẫn cần lập kế hoạch vì các phần mở rộng (extensions) và hành vi ứng dụng có thể thay đổi, nhưng một nhà cung cấp tốt sẽ giảm thiểu sự can thiệp đó xuống mức tối thiểu và đưa ra lộ trình nâng cấp rõ ràng.
Mở rộng (Scaling)
Dung lượng cần được điều chỉnh theo khối lượng công việc mà không cần các kỹ sư nền tảng phải thay đổi kích thước cơ sở hạ tầng thủ công: mở rộng theo chiều dọc (vertical scaling) để tăng tài nguyên tính toán hoặc bộ nhớ, các bản sao đọc (read replicas) cho lưu lượng đọc, và lý tưởng nhất là khả năng mở rộng serverless giúp loại bỏ hoàn toàn các quyết định này. Tính năng tự động mở rộng của Lakebase là một ví dụ trong môi trường thực tế, cho phép ghi dữ liệu vào Postgres nhanh gấp 5 lần so với Postgres tiêu chuẩn. Bài kiểm tra thực sự nằm ở lúc lưu lượng truy cập tăng đột biến: nếu đội ngũ cơ sở dữ liệu vẫn phải theo dõi mức sử dụng và chờ đợi thay đổi kích thước, thì việc mở rộng vẫn là công việc của họ.
Tính sẵn sàng cao và chuyển đổi dự phòng (High availability and failover)
Cơ sở dữ liệu phải luôn hoạt động khi cơ sở hạ tầng gặp sự cố mà không cần kỹ sư trực phải tự tay chuyển đổi bản sao vào lúc 2 giờ sáng. Một số nhà cung cấp xử lý việc này bằng các phiên bản dự phòng (standby instances) tự động tiếp quản; những bên khác, như Lakebase, thay thế trực tiếp tài nguyên tính toán bị lỗi vì nó không lưu trữ trạng thái cục bộ bền vững. Tuy nhiên, không phải nhà cung cấp nào cũng chuyển đổi dự phòng với tốc độ như nhau hoặc cùng mức độ mất mát dữ liệu. Một số bên làm mất dữ liệu ghi trong vài giây trong quá trình này; số khác thì không. Đó là chi tiết đáng kiểm tra trước khi tin tưởng vào nhãn dán "managed", bao gồm cả việc liệu chuyển đổi dự phòng có tồn tại hay không và điều gì sẽ xảy ra với các dữ liệu đang ghi dở khi nó kích hoạt.
Sao lưu và phục hồi
Sao lưu tự động và quy trình khôi phục mà các nhóm có thể tự chạy mà không cần gửi yêu cầu hỗ trợ là tiêu chuẩn cơ bản. Phục hồi tại một thời điểm cụ thể (Point-in-time recovery - PITR), tức là khôi phục về một thời điểm chính xác thay vì chỉ là bản snapshot gần nhất, rất quan trọng khi một quá trình di chuyển dữ liệu lỗi làm hỏng dữ liệu vào giữa buổi chiều. Một khu vực (region) bị sập hoàn toàn là vấn đề lớn hơn, được đo bằng Mục tiêu Thời gian Phục hồi (RTO - thời gian bạn bị gián đoạn) và Mục tiêu Điểm Phục hồi (RPO - lượng dữ liệu bạn có thể chấp nhận mất). Một nhà cung cấp không có các con số xác định cho cả hai chỉ số này thì không có kế hoạch phục hồi sau thảm họa, mà chỉ là sự phỏng đoán.
Managed Postgres bảo vệ dữ liệu của bạn như thế nào
Một cơ sở dữ liệu được quản lý nên mã hóa dữ liệu ở trạng thái nghỉ (at rest) và trong quá trình truyền tải (in transit), kiểm soát quyền truy cập và cung cấp cho các nhóm dữ liệu khả năng hiển thị hoạt động của cơ sở dữ liệu. Điều đó có nghĩa là:
Những điều cần cân nhắc khi di chuyển cơ sở dữ liệu PostgreSQL hiện có
Một quá trình di chuyển có vẻ đơn giản cho đến khi cơ sở dữ liệu mới không hỗ trợ một phần mở rộng, cấu hình hoặc tính năng PostgreSQL mà ứng dụng của bạn đang dựa vào. Hãy kiểm tra các phụ thuộc của ứng dụng trước khi di chuyển bất cứ thứ gì. Dưới đây là những điểm chính cần cân nhắc khi di chuyển cơ sở dữ liệu PostgreSQL hiện có:
Postgres có tốt cho các ứng dụng AI không?
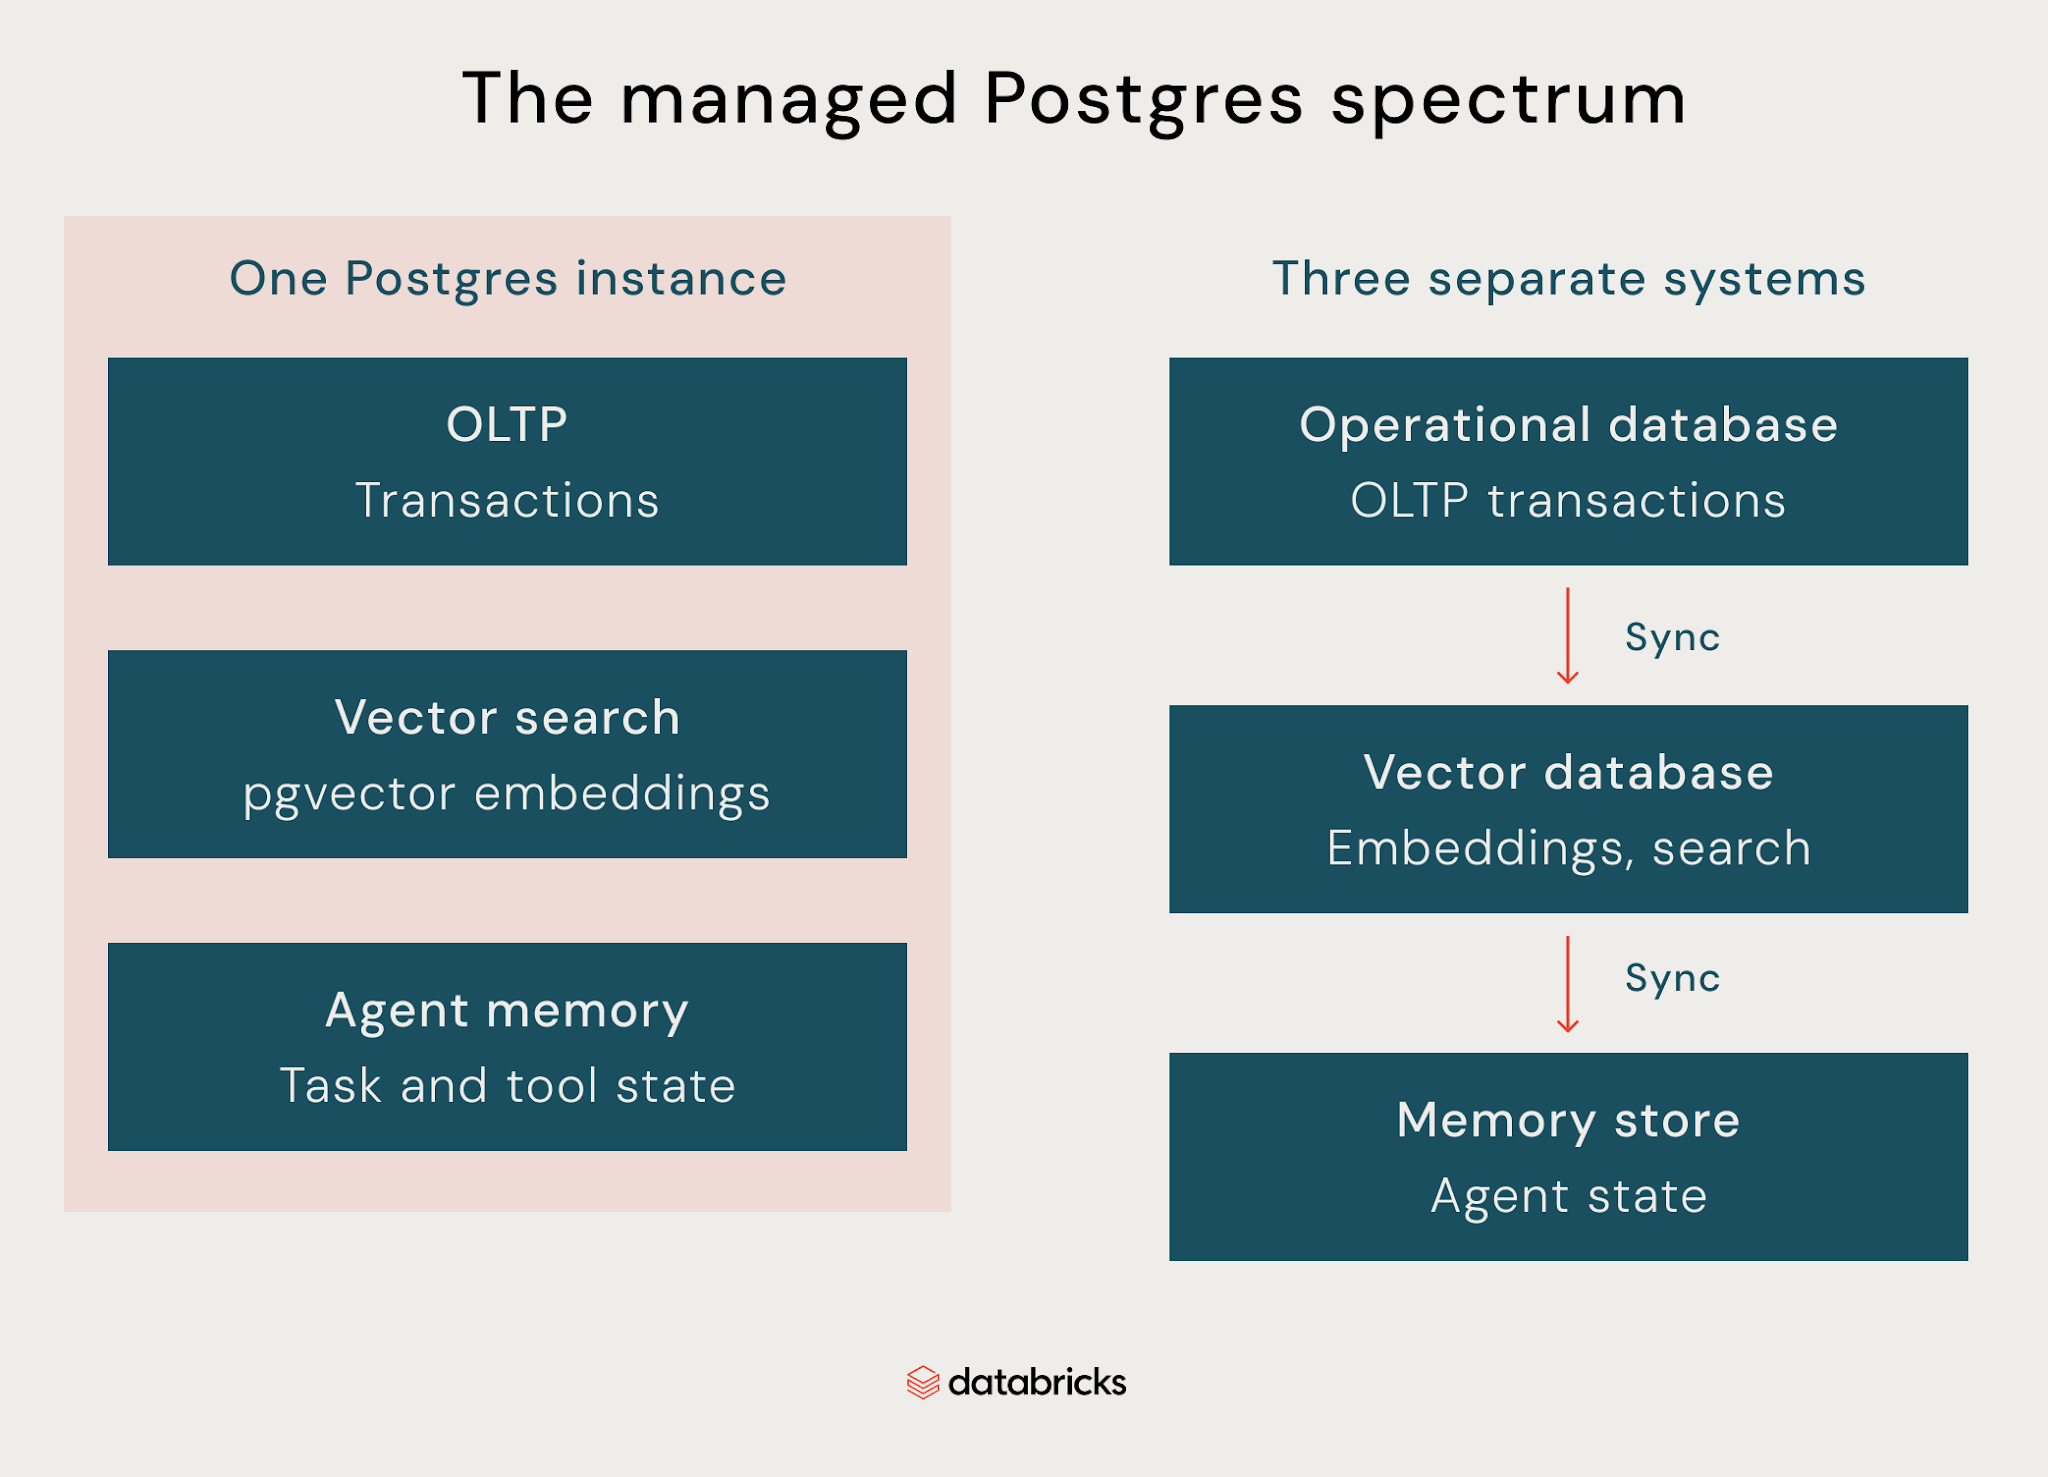
Postgres có thể là lựa chọn mạnh mẽ cho các ứng dụng AI khi ứng dụng cần trạng thái giao dịch và tìm kiếm vector trong cùng một hệ thống. Điều này phụ thuộc vào bốn yếu tố: pgvector là phần mở rộng giúp điều đó trở nên khả thi, tìm kiếm vector để truy xuất, bộ nhớ mô hình ngôn ngữ lớn (LLM) để duy trì trạng thái giữa các yêu cầu, và các khối lượng công việc tác nhân (agent workloads) cần cả hai cùng lúc.
pgvector
pgvector thêm kiểu dữ liệu vector và lập chỉ mục tìm kiếm tương đồng trực tiếp vào bên trong Postgres, vì vậy các vector nhúng nằm cạnh các dữ liệu ứng dụng khác thay vì ở một hệ thống riêng biệt. Sự đánh đổi là việc sử dụng một cơ sở dữ liệu vector riêng biệt đồng nghĩa với việc giữ cho các vector nhúng và dữ liệu vận hành đồng bộ trở thành một bài toán kỹ thuật phức tạp, điều mà pgvector đã loại bỏ cho các khối lượng công việc không cần một kho lưu trữ vector chuyên dụng.
Tìm kiếm vector và tìm kiếm ngữ nghĩa
pgvector cho phép bạn lưu trữ các vector nhúng và sử dụng các chỉ mục láng giềng gần đúng (ANN) để tìm các vector tương tự một cách hiệu quả khi tập dữ liệu phát triển, đây chính là yếu tố giúp tìm kiếm ngữ nghĩa, truy xuất tăng cường (RAG) và khớp dữ liệu dựa trên ý nghĩa trở nên khả thi bên trong Postgres. Chiến lược lập chỉ mục phù hợp vẫn phụ thuộc vào quy mô tập dữ liệu và mô hình truy vấn, vì vậy pgvector không loại bỏ nhu cầu đánh giá hiệu suất cho khối lượng công việc cụ thể của bạn.
Bộ nhớ LLM
Các ứng dụng LLM cần nơi để lưu trữ trạng thái giữa các yêu cầu, bao gồm lịch sử trò chuyện, tùy chọn người dùng, tài liệu đã truy xuất và kết quả công cụ. Postgres có thể lưu trữ trạng thái đó dưới dạng dữ liệu quan hệ thông thường trong khi pgvector xử lý các vector nhúng trong cùng một cơ sở dữ liệu. Đối với các khối lượng công việc cần truy xuất vector chuyên biệt ở quy mô rất lớn, một cơ sở dữ liệu vector chuyên dụng vẫn có thể hợp lý, nhưng nhiều ứng dụng AI hoàn toàn có thể giữ trạng thái vận hành và truy xuất cùng nhau.
Khối lượng công việc tác nhân (Agent workloads)
Các tác nhân liên tục đọc và cập nhật trạng thái khi chúng chạy. Chúng theo dõi các cuộc trò chuyện, lưu trữ kết quả trung gian và ghi lại các lệnh gọi công cụ, điều này khiến cơ sở dữ liệu trở thành một phần của lớp thực thi tác nhân thay vì chỉ là nơi để truy xuất ngữ cảnh. Một cơ sở dữ liệu được xây dựng cho các khối lượng công việc tác nhân AI cần hỗ trợ cả trạng thái giao dịch thay đổi liên tục đó và việc truy xuất ngữ cảnh liên quan mà tác nhân sử dụng, tất cả trong một hệ thống.
Postgres cho phát triển ứng dụng
Ngoài việc chạy các khối lượng công việc thực tế (production), Postgres cần hỗ trợ cách nhóm của bạn thực sự xây dựng sản phẩm. Điều đó có nghĩa là các kết nối không được trở thành nút thắt cổ chai khi bạn mở rộng quy mô, và việc kiểm thử các thay đổi lược đồ (schema) không được gây rủi ro cho dữ liệu thực tế.
Quản lý kết nối
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.