Mô hình
Alibaba ra mắt Qwen-Image-2.1: Mô hình tạo và chỉnh sửa ảnh mã nguồn mở 7B
(giờ Việt Nam)
Tóm tắt AI
Alibaba giới thiệu Qwen-Image-2.1, mô hình DiT 7B tích hợp khả năng tạo và chỉnh sửa ảnh, hỗ trợ xuất file trong suốt RGBA và xử lý tối đa 10 ảnh tham chiếu.
Bản dịch AI
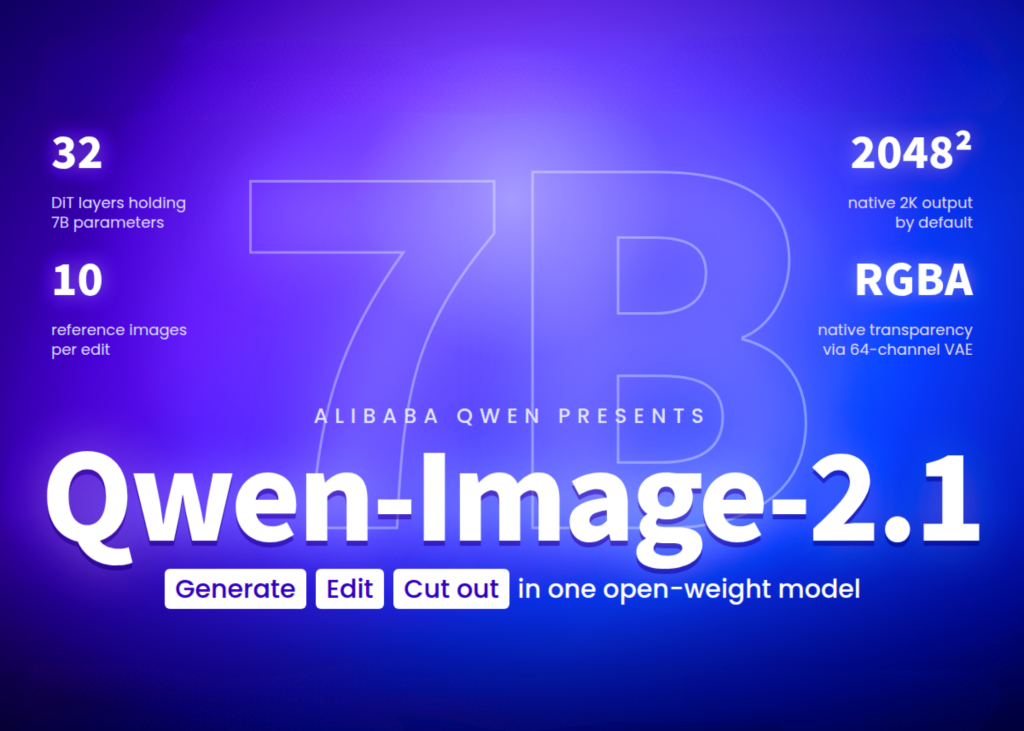
Đội ngũ Qwen của Alibaba vừa ra mắt Qwen-Image-2.1, một mô hình hợp nhất giữa tạo ảnh từ văn bản và chỉnh sửa hình ảnh. Thành phần tạo hình ảnh của mô hình có 7 tỷ tham số trải dài trên 32 lớp DiT (Diffusion Transformer) luồng đơn. Một checkpoint duy nhất hỗ trợ tạo ảnh từ văn bản, chỉnh sửa đa tham chiếu, chỉnh sửa cục bộ và xuất tệp RGBA trong suốt.
Có thể triển khai được không? Có, dành cho mục đích nghiên cứu và đánh giá. Hỗ trợ Day 0 bao gồm Diffusers, ComfyUI, vLLM-Omni, SGLang và LightX2V. Việc triển khai thương mại cần có giấy phép riêng từ Qwen.
Từ 20B xuống 7B
Qwen-Image phiên bản gốc được phát hành vào tháng 8 năm 2025 dưới dạng mô hình 20B theo giấy phép Apache 2.0. Chức năng chỉnh sửa trước đây nằm trong một checkpoint Qwen-Image-Edit riêng biệt. Qwen-Image-2.1 tích hợp cả hai tác vụ vào một mô hình duy nhất với kích thước chỉ bằng khoảng một phần ba. Đội ngũ Qwen gọi đây là mô hình cân bằng và tiết kiệm chi phí nhất trong dòng Qwen-Image. Một lưu ý quan trọng cho việc lập kế hoạch năng lực: con số 7B chỉ bao gồm riêng phần diffusion transformer. Pipeline này còn tải thêm một bộ mã hóa Qwen3-VL 8B.
Kiến trúc
GitHub Repo liệt kê 4 thành phần:
Attention mask (mặt nạ chú ý) chính là yếu tố tạo nên tốc độ. Các token văn bản sử dụng mặt nạ nhân quả (causal mask) ở cấp độ token. Các token hình ảnh sử dụng mặt nạ hai chiều (bidirectional mask) cấp độ khối trong mỗi hình ảnh. Qwen gọi đây là cơ chế chú ý đa độ phân giải (mixed-granularity attention). Tiền tố điều kiện (condition prefix) nằm trước latent nhiễu, vì vậy nó không bao giờ chú ý đến latent đó. Do đó, các khóa (keys) và giá trị (values) của nó vẫn cố định trong suốt các bước khử nhiễu. Mô hình tính toán văn bản và hình ảnh đầu vào một lần duy nhất ở bước đầu tiên, sau đó tái sử dụng bộ nhớ đệm prefix KV cho mọi bước còn lại. Mức tiết kiệm tài nguyên tăng dần theo số lượng hình ảnh tham chiếu, điều này giải thích cho tuyên bố về tốc độ xử lý đa hình ảnh.
Khả năng của mô hình
Điểm chuẩn: Biểu đồ của Qwen
Nhóm nghiên cứu so sánh các mô hình trên Qwen-Image-Bench, bộ tiêu chuẩn đánh giá nội bộ của Qwen. Trên biểu đồ đó, Qwen-Image-2.1 đạt tổng điểm 60,28. Kết quả này giúp nó vượt qua Nano Banana 2.0 với 59,82 điểm và tất cả các mô hình mã nguồn mở được liệt kê. FLUX 2 Max, một mô hình mở 32B, đạt 55,33 điểm. Có 6 mô hình đóng đạt điểm cao hơn, dẫn đầu là GPT Image 2.5 Sunburst với 67,01 điểm.
Công cụ giải thích tương tác
Cách vận hành
Cài đặt PyTorch 2.4.0 trở lên, transformers 5.17 trở lên, Diffusers từ mã nguồn, accelerate và pillow. Sau đó:
Cùng một pipeline đó sẽ xử lý việc chỉnh sửa khi bạn truyền tham số image= với 1 hoặc nhiều tham chiếu. Trên các GPU có dung lượng nhỏ hơn, pipe.enable_model_cpu_offload sẽ giúp giảm áp lực bộ nhớ.
Đối với việc phục vụ (serving), vLLM-Omni bổ sung tính năng lượng tử hóa FP8, bộ nhớ đệm prefix KV, giải mã CUDA Graph và song song hóa tensor. SGLang bổ sung Cache-DiT, CUDA graphs, song song hóa đa GPU và giảm tải thành phần. ComfyUI cung cấp các node gốc và trọng số đã chuyển đổi. Ngoài NVIDIA, bản phát hành này còn hỗ trợ các GPU AMD Radeon thông qua ROCm và các nền tảng 8 chip thông qua FlagOS.
Đội ngũ Qwen cũng phát hành 2 mô hình viết lại prompt, là các checkpoint Qwen3.5-VL 9B được tinh chỉnh cho tác vụ tạo ảnh từ văn bản và chỉnh sửa. Chúng giúp mở rộng các prompt ngắn thành các prompt chi tiết và có khả năng chọn tỷ lệ khung hình.
Những điểm chính cần lưu ý
Hãy xem qua Model Weights, GitHub Repo và Technical Details. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter, đừng quên tham gia cộng đồng 150k+ ML SubReddit và đăng ký nhận bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, trang Hugging Face, sản phẩm mới hoặc hội thảo trực tuyến, v.v.? Hãy kết nối với chúng tôi.

Michal Sutter là một chuyên gia khoa học dữ liệu với bằng Thạc sĩ Khoa học Dữ liệu từ Đại học Padova. Với nền tảng vững chắc về phân tích thống kê, học máy và kỹ thuật dữ liệu, Michal xuất sắc trong việc chuyển đổi các tập dữ liệu phức tạp thành những thông tin chi tiết có giá trị thực tiễn.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.